요즘 하고 있는 프로젝트를 이야기해 보려 합니다.
최근 AI를 통해 광고 소재를 만들거나 업무에 적용하는 것이 매우 당연한 흐름이 되었습니다.
그리고 광고나 SNS 운영을 대신해 주겠다는 서비스 또한 심심찮게 보입니다.
그러한 흐름 속에서 최근 제가 시도하고 있는 프로젝트가 하나 있습니다.
콘텐츠를 올린 후 실제 사람들의 반응을 기다리는 대신, 사람을 직접 모으지 않아도 수백 명의 AI 응답자가 설문에 답하고 여러 기획안 가운데 어떤 안을 더 선호하는지 사전에 평가해 보는 프로젝트입니다.
과거에도 이런 문제를 검증하기 위한 방법은 많았습니다.직접 고객을 만나거나, A/B 테스트를 진행하거나, 페이크 도어 테스트를 해 보는 등 수많은 방법론이 고안되어 왔죠.
다만 기존 방법론에는 한계도 있었습니다. 제대로 검증하려면 사람을 모아야 하니 비용이 많이 들고, 결과를 확인하기까지 시간도 오래 걸리며 이걸 머신러닝기반 최적화를 하려는 시도는 무척이나 많았죠 물론 정합성과 신뢰도를 놓고 보면 기존 방법론이 나쁘다고 할 수는 없습니다.
다만 AI 시대인 만큼 LLM기반으로 이 과정을 조금 다르게 접근할 방법은 없을까요?
그래서 실험을 하나 해봤습니다.
AI 응답자 페르소나를 만들고, 이들에게 영상 기획안과 썸네일 네 개를 보여 준 뒤 어떤 안을 선택하는지 확인해 보자. 시작은 이런 단순한 아이디어였습니다.
01실험조건
실험이 성립하려면 두 가지 조건이 필요했습니다.
첫 번째는
한국을 대상으로 실험하는 만큼, 한국의 문화적 배경을 반영한 데이터가 있어야 한다는 점
두 번째
AI의 응답을 한 번만 받고 그대로 신뢰할 수는 없으니, 반복 검증을 통해 최대한 신뢰할 수 있는 데이터만 남겨야 한다는 점
이 두 가지가 기본 조건이었죠. 그래서 이번 실험에서는 다음과 같은 검증 조건을 추가했습니다.
첫 번째, 일부러 정말 이상한 기획안을 하나 넣고 이것조차 걸러내지 못한다면 해당 실험 결과는 폐기
두 번째, 같은 질문을 세 번 반복해 답변의 일관성과 각 페르소나의 응답 안정성 체킹
왜 이렇게까지 했을까요?
사실 첫 번째 실험을 한 번 말아먹었거든요. 처음에는 25명으로 가볍게 시작했습니다. 솔직히 결과만 보면 정말 웰메이드하게 나왔어요. 제가 예상한 1안이 1위를 했고, 일부러 떨어뜨리려고 넣어 둔 안은 꼴찌를 했습니다.
‘오, 잘됐네? AI 똑똑하네?’
제가 생각했던 모델링이 그대로 구현되는 줄 알았습니다.
그런데 결과를 자세히 뜯어보니 문제가 보였죠, 나머지 세 가지 안의 점수 차이가 이상할 정도로 똑같이 반복되고 있었죠 그걸 보는 순간 알았습니다.
‘아, 이거 오염됐구나. 망했다.’
결과가 그럴듯하게 나온 것과 실험이 제대로 작동한 것은 전혀 다른 문제였습니다. 그래서 기존 결과는 버리고, 실험 설계 자체를 아래와 같이 다시 구성했습니다.
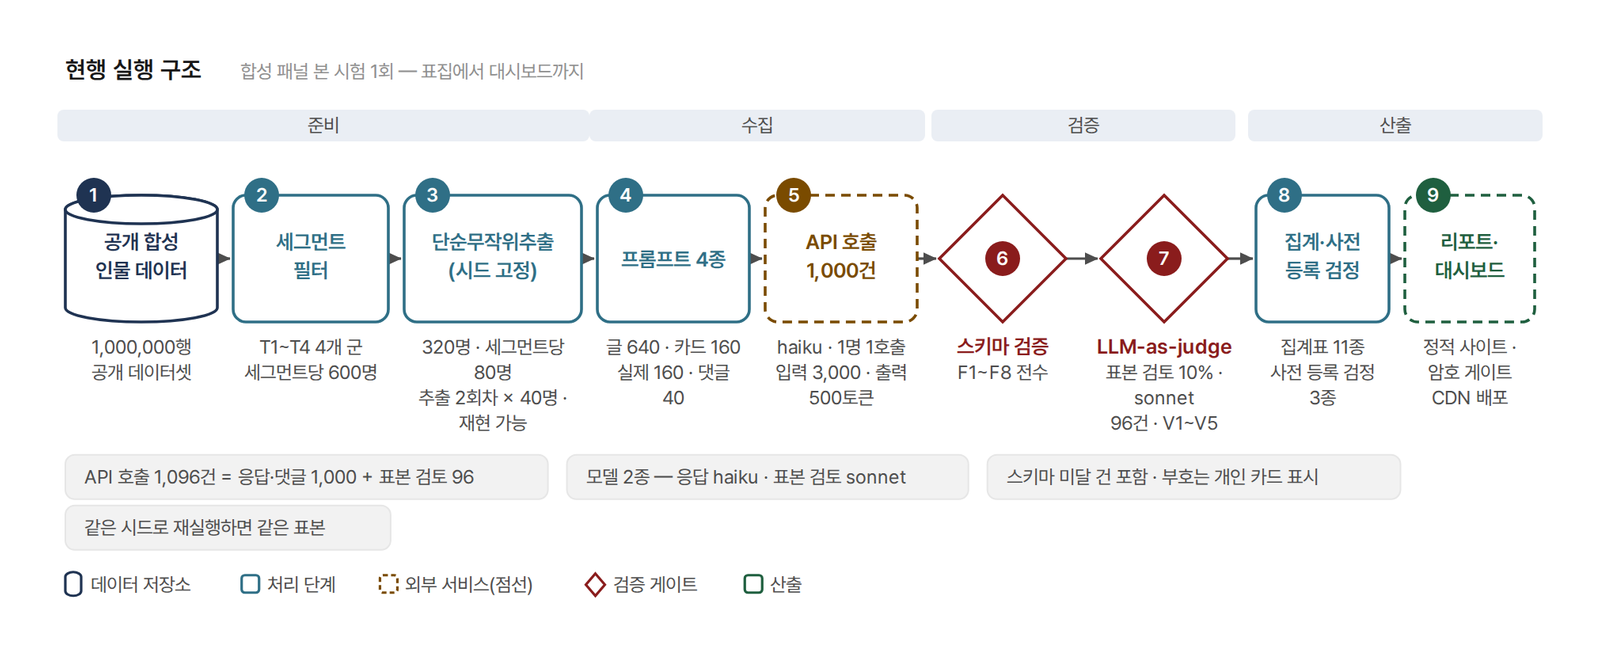
AI 응답자를 만들려면 우선 사람에 해당하는 기초 자료가 필요하죠, 문제는 한국은 개인정보 보호법때문에 쉽지않아요
그렇기에 여기서는 NVIDIA가 2025년에 공개한 Nemotron-Personas-Korea를 사용했습니다.
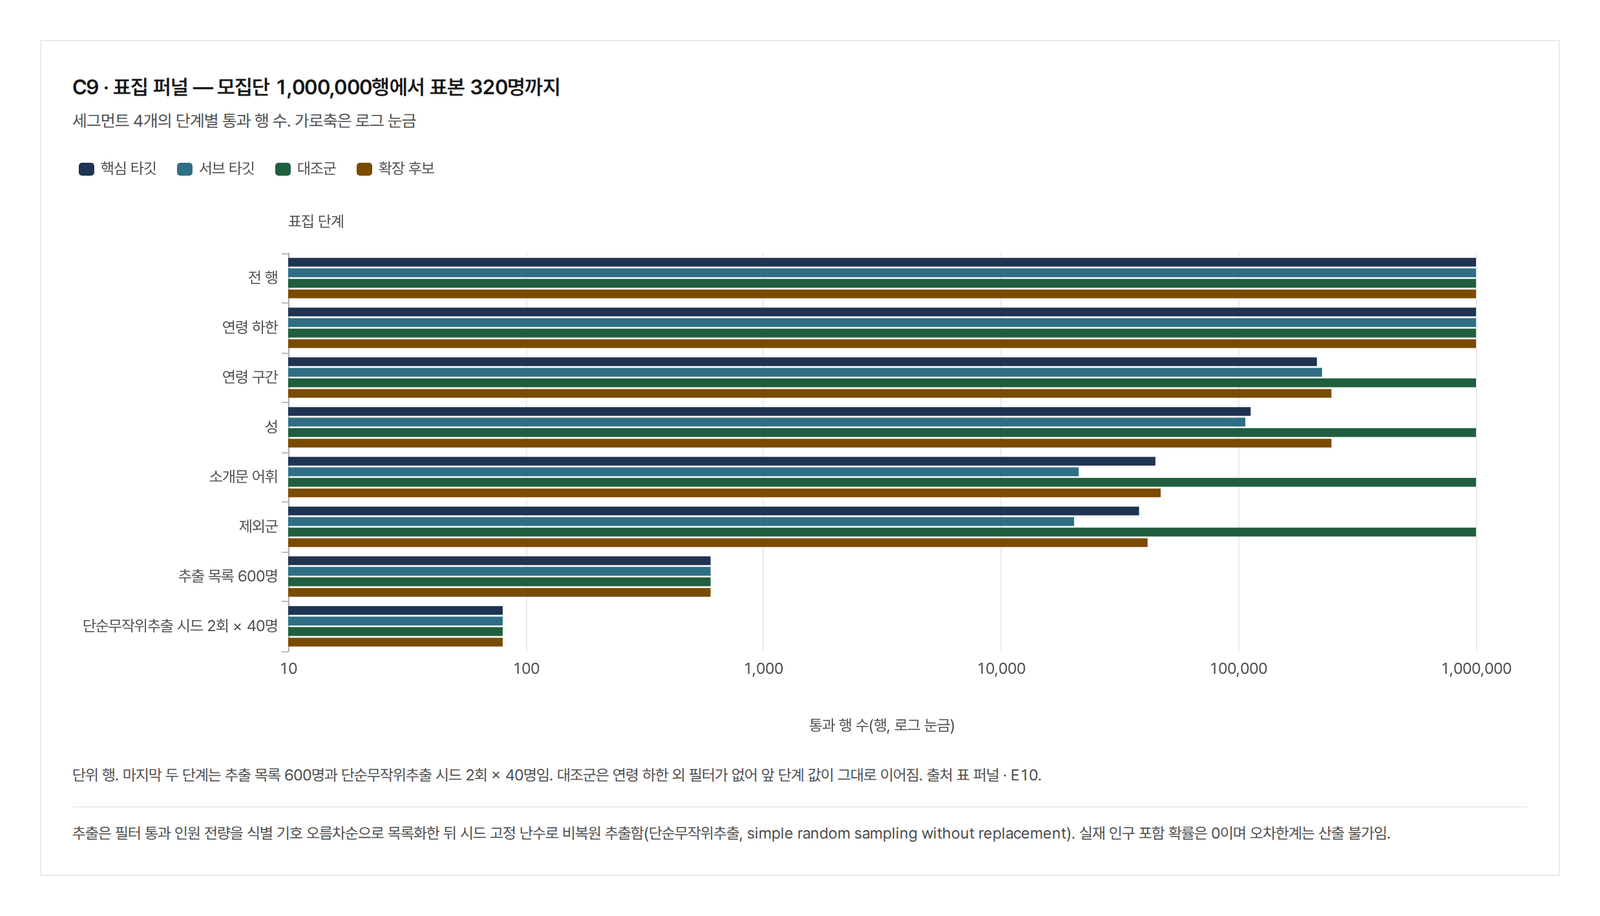
쉽게 말하면 실존 인물은 단 한 명도 포함되지 않은, 100만 명 규모의 가상 인물 데이터셋입니다. 한국의 인구통계학적 특성을 반영해 성별, 나이, 직업, 거주 지역, 취미, 자기소개 등 한 사람당 26개의 항목으로 구성되어 있고 실제로 무척다양한 지표가있어요
이 데이터셋을 사용한이유는 국내에서 실제 사람의 개인정보를 대규모로 수집해 실험에 활용하려면 개인정보보호 문제를 함께 고려해야 하는데, 이 데이터는 애초에 실존 인물이 아닌 합성 데이터이기 때문에 굉장히 편하게 에이전트를 구성할수있었죠
물론 한계도 있습니다.
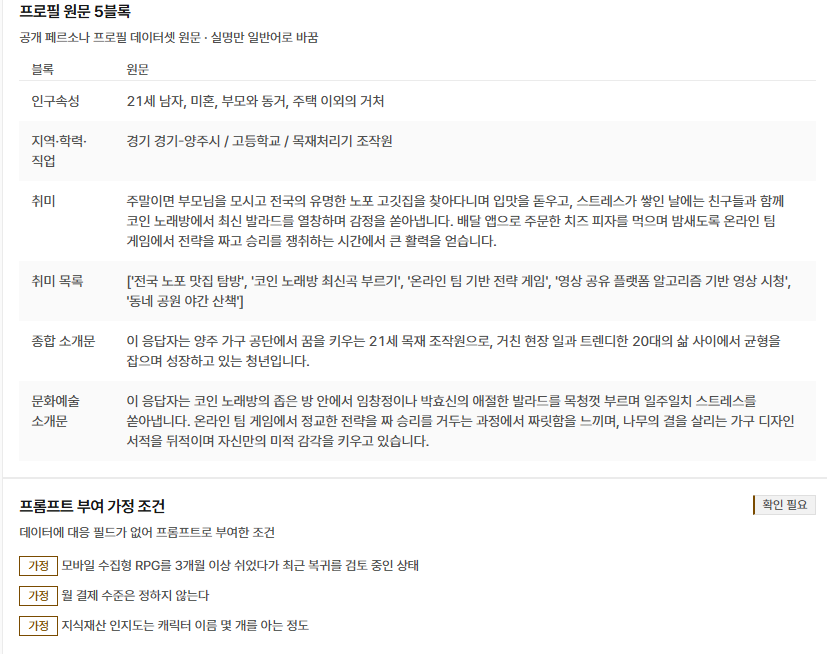
이 사람이 어떤 콘텐츠를 좋아하는지, 소득 수준은 어느 정도인지, 어떤 기준으로 소비를 결정하는지와 같은 세부적인 행동·심리 데이터까지 들어 있는 것은 아닙니다. 그래서 부족한 부분은 AI가 기존 프로필의 취미, 직업, 연령 등의 정보를 바탕으로 추론해 가정값을 채우도록 설계했죠
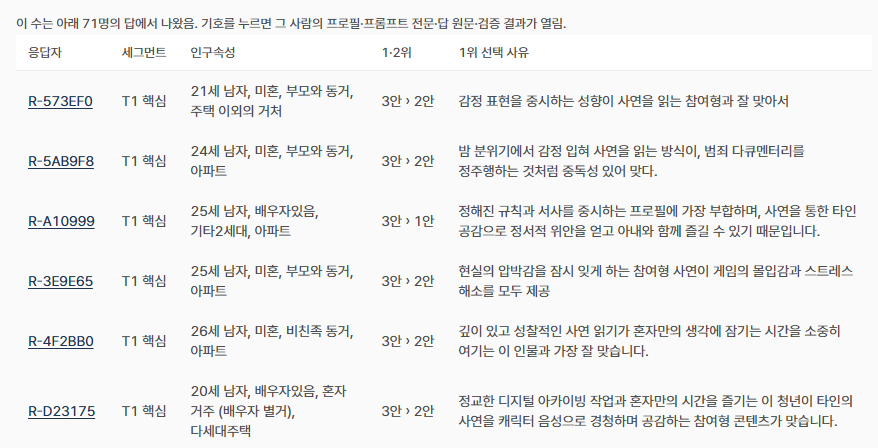
02 실제 테스트
예를 들어 이런 페르소나가 있습니다.
23세 남성, 미혼, 부모님과 아파트 거주, 용인 수지 거주, 전문대 졸업, 시설 경비원. 취미는 길거리 농구와 잠들기 전 영상 시청이며, 자기소개에는 실속과 안정을 최우선
이런 기본 정보를 바탕으로 AI가 각각의 타깃 페르소나를 분석하고, 실험에 필요한 추가 가정 조건을 설정하도록 했습니다.
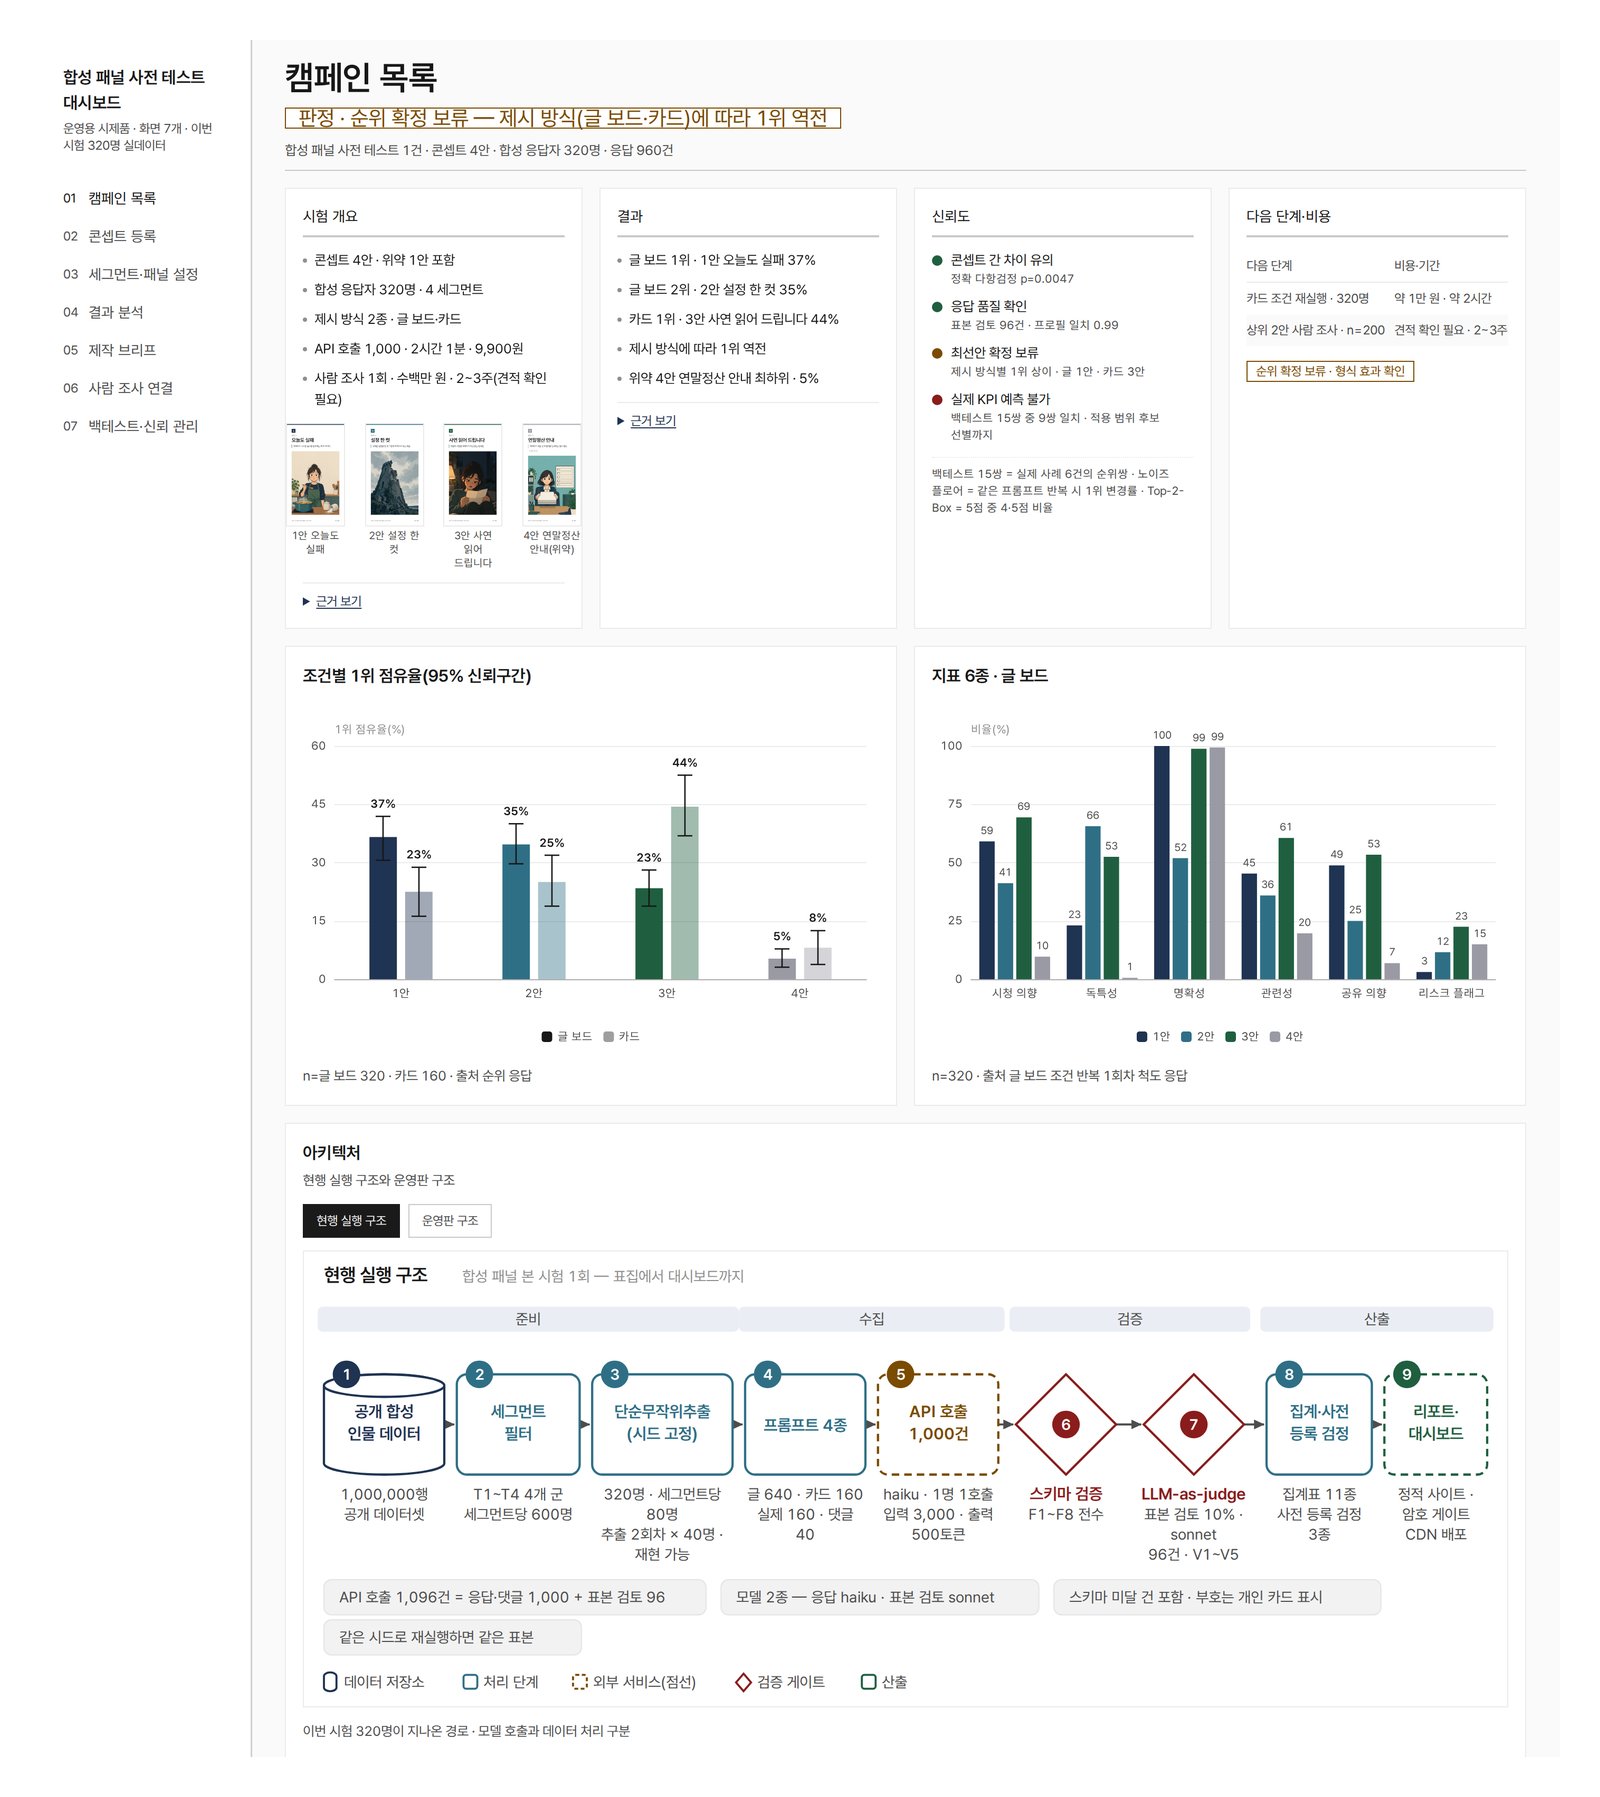
여기서 네 개의 집단을 정하고 집단별로 80명씩, 총 320명의 페르소나를 뽑았습니다.
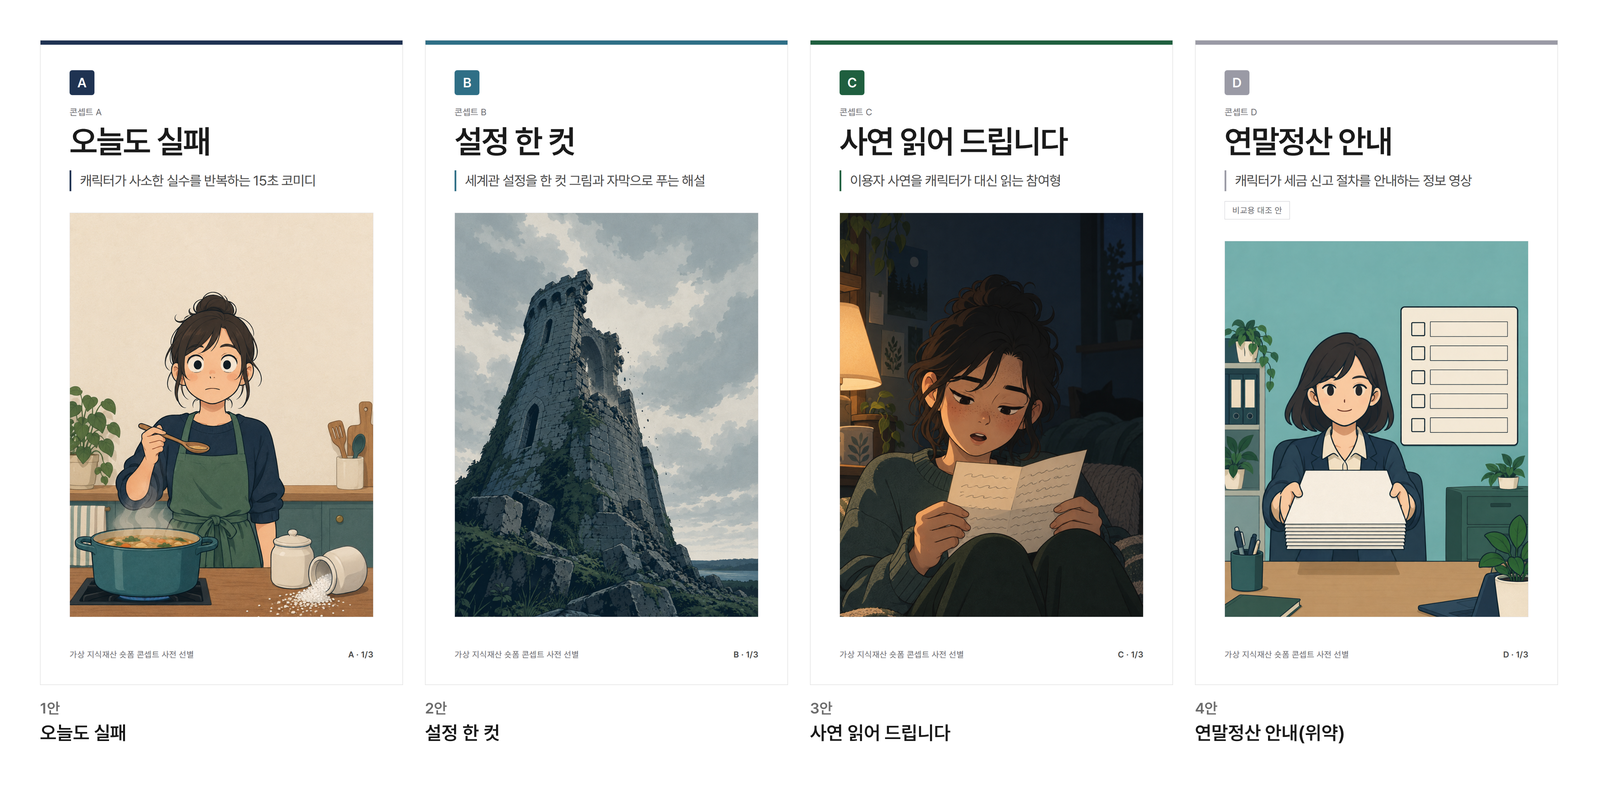
그리고 이들에게 보여 줄 영상 기획안 네 개를 만들었습니다. 캐릭터 40종이 등장하는 가상의 모바일 게임을 하나 설정하고, 이를 배경으로 테스트용 콘텐츠와 페르소나 세트를 구성했습니다.
기업 단위로 넘어간다면 이런 세트를 제품이나 브랜드, 프로젝트별로 각각 만들어 활용할 수도 있겠죠.
결과부터 말씀드리는 편이 빠르겠습니다.
아직 실험 중인 단계이고, 결과도 완전히 안정적이지는 않습니다.
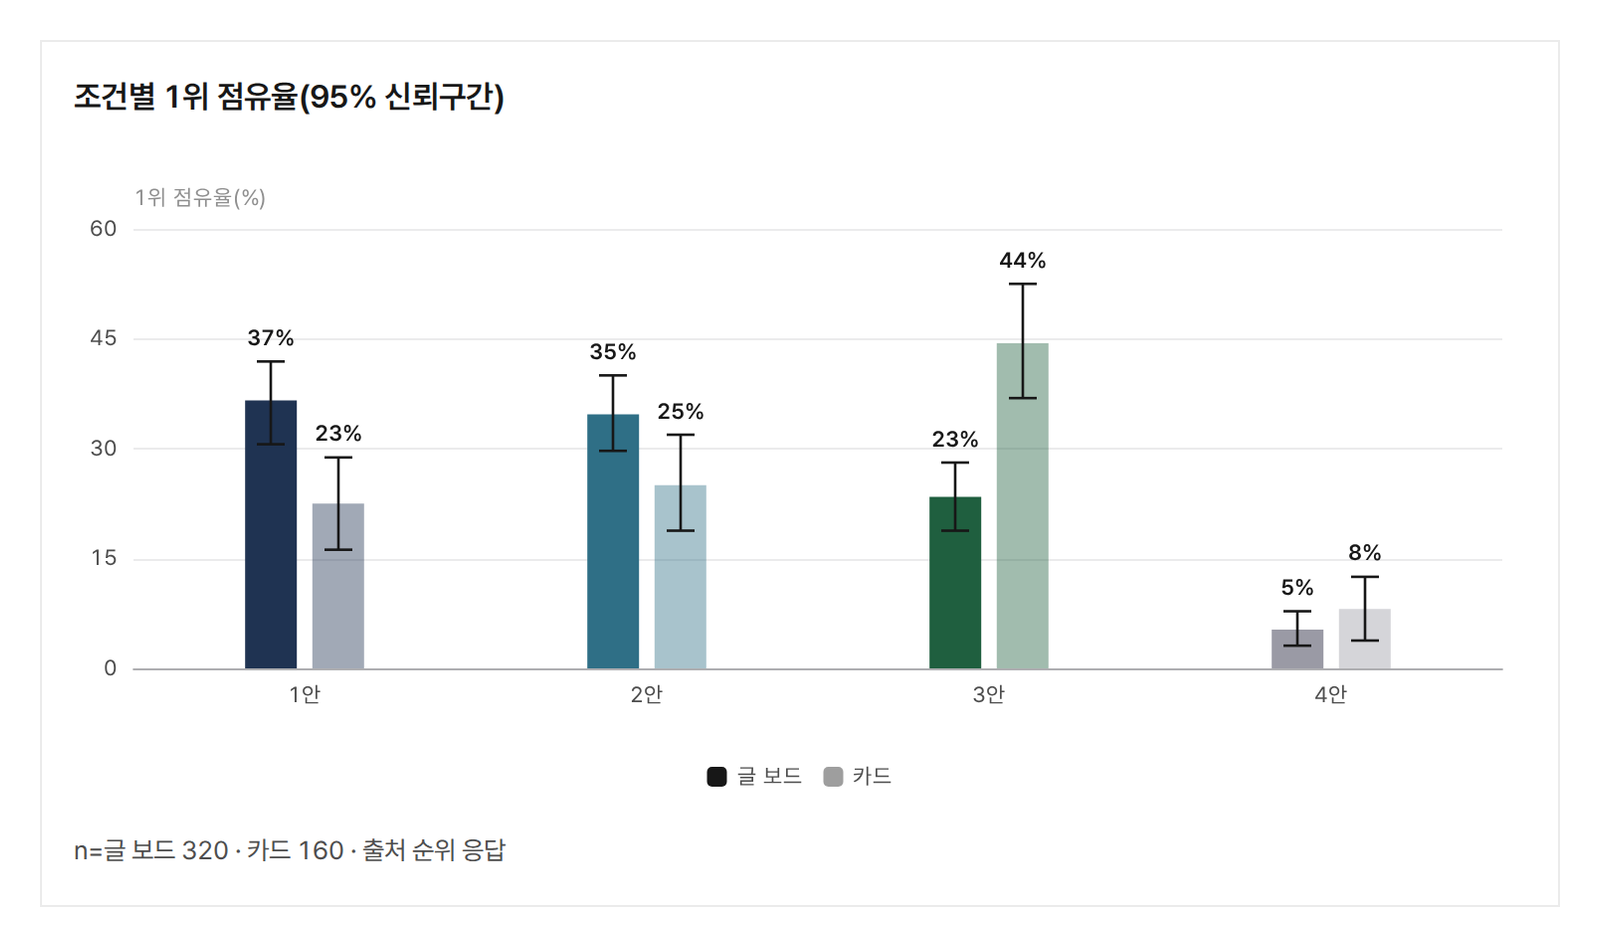
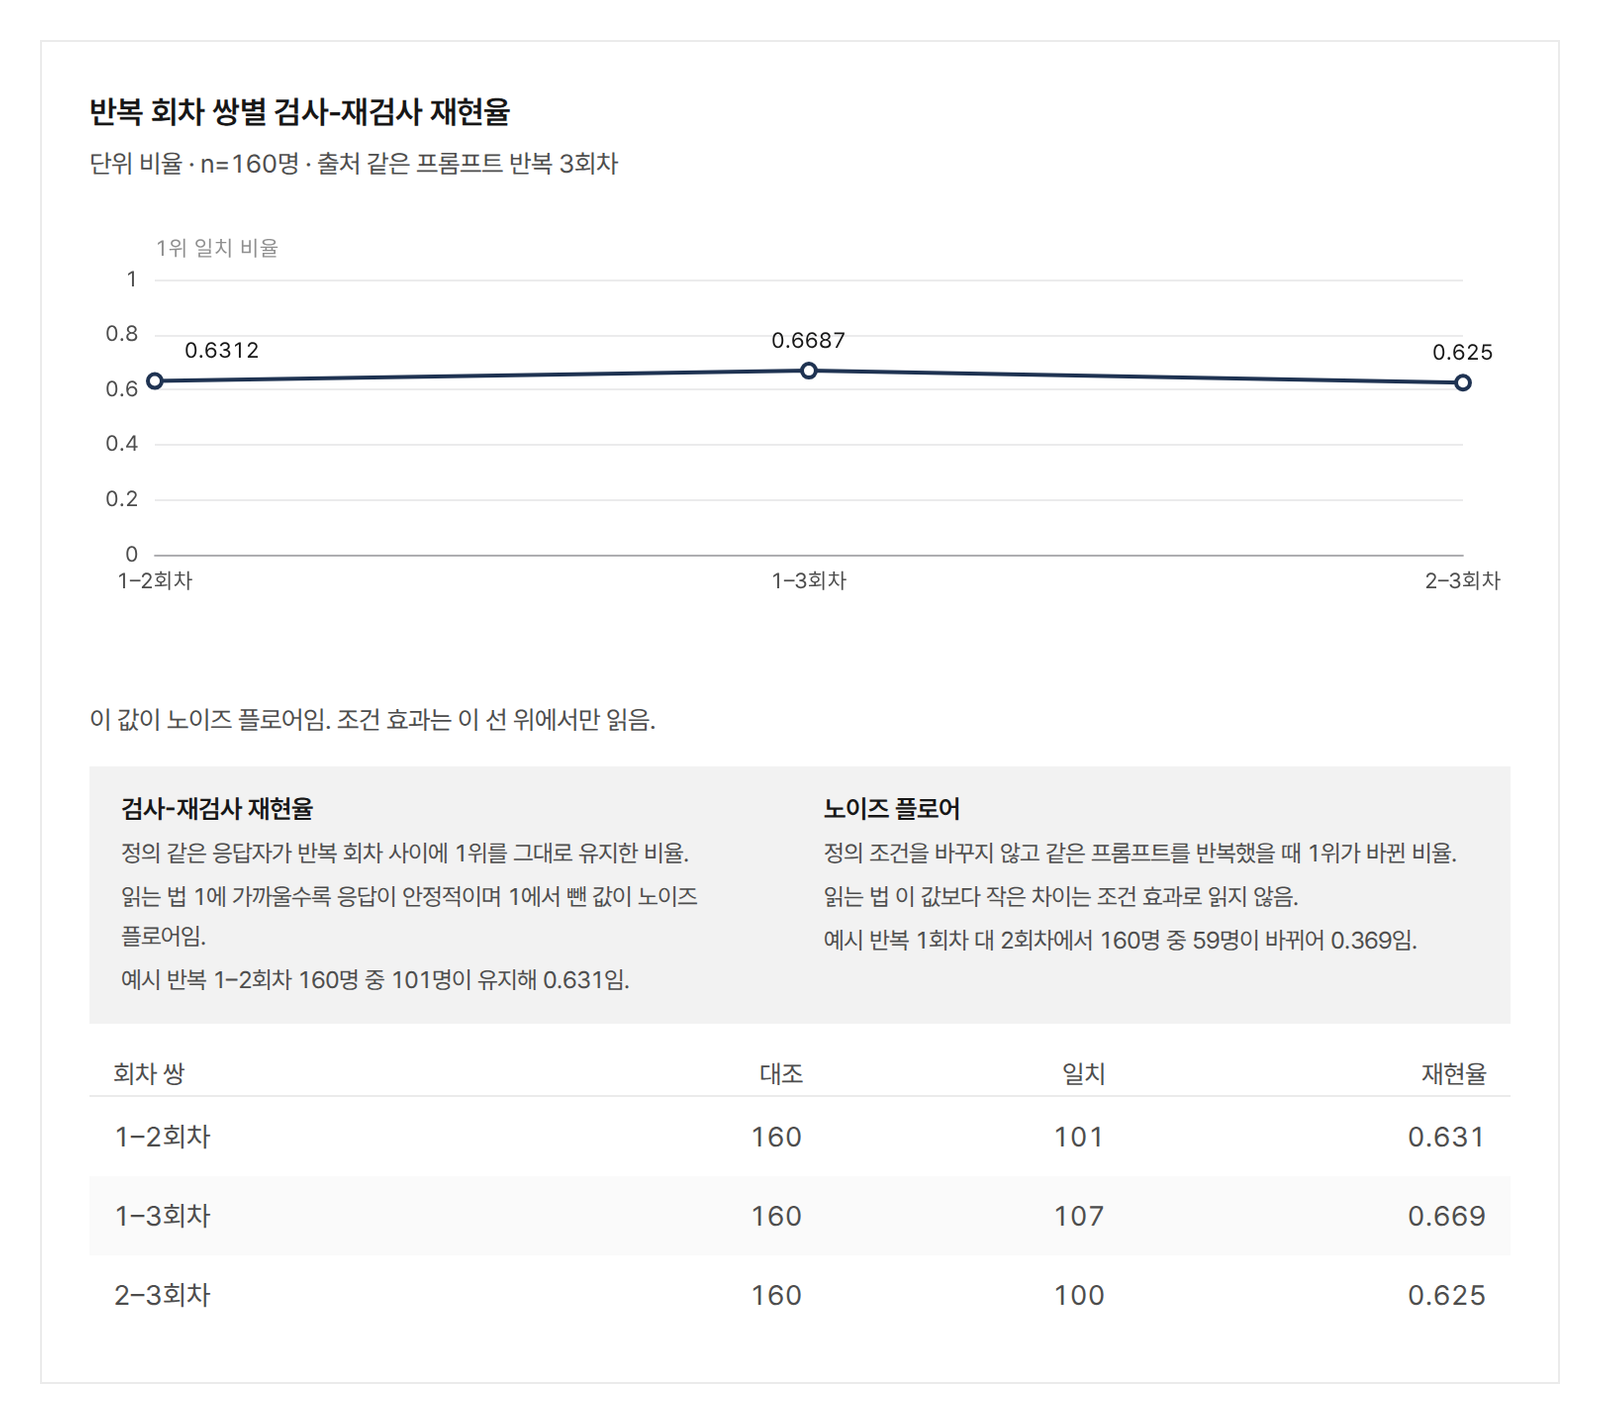
먼저 같은 기획안을 텍스트 대신 카드 이미지 형태로 바꿔 다시 보여 줬고. 그 결과 160명의 페르소나 가운데 82명, 약 51%가 기존에 1위로 선택했던 안을 바꿨습니다.
다음으로도 표현 방식조차 바꾸지 않고 똑같은 질문을 한 번 더 던져 봤습니다. 그런데 이때도 160명 가운데 59명, 약 37%가 기존 선택을 바꿨습니다. 반대로 보면 동일한 조건에서 다시 질문했을 때 약 63%는 기존 선택을 유지한 셈입니다.
아직 반복 측정에 대한 일관성이 충분하다고 보기는 어렵습니다.
특히 같은 내용이라도 텍스트인지 이미지인지에 따라 결과가 크게 달라졌기 때문에, 제시 방식이 응답에 미치는 영향도 추가로 검증해야 하며 최적화도 필요하죠 그래서 지금 단계에서 이 결과를 실제 소비자의 반응과 동일하다고 보기는 어렵지만 다만 실험을 반복하면서 기획안을 사전에 걸러내거나, 어떤 지점에서 부정적인 반응이 발생하는지 확인하는 용도로 활용할 만한 데이터를 뽑아내고 있지요
03구조
구조 자체는 단순합니다.
데이터셋에서 프로필 하나를 꺼내고, 이를 에이전트 스폰 지시문에 넣어 하나의 페르소나로 만듭니다. 그 페르소나에게 질문을 던져 답을 받은 뒤, 다시 별도의 검사 과정을 거쳐 해당 응답을 실제 분석에 사용할 수 있는지 판단하는 작은 루프를 구성했습니다.
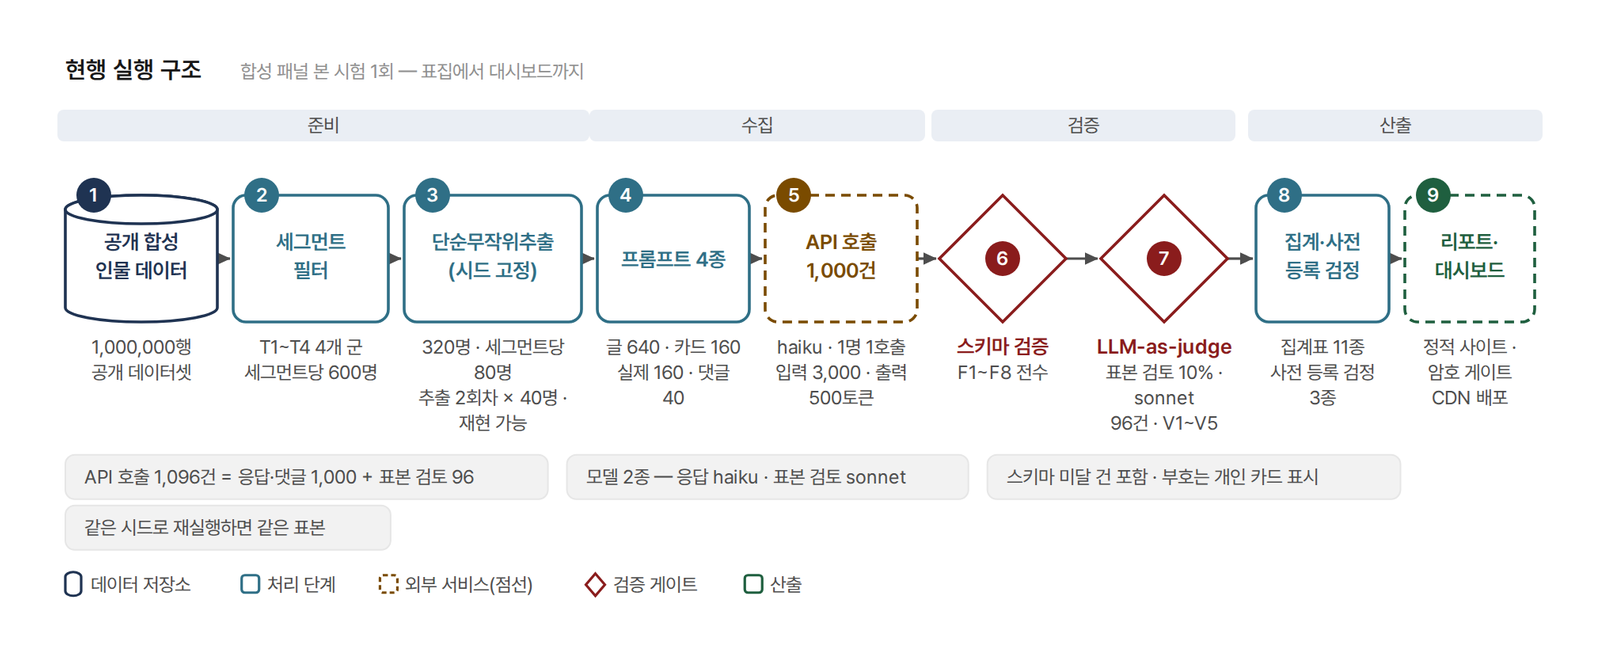
에이전트에 들어가는 프롬프트의 경우
핵심은 AI가 프로필에 없는 내용을 마음대로 만들어 내는 것을 최대한 줄이는 것이었습니다.
다만 여기서 근본적인 문제가 하나 생깁니다.
AI에게 사람의 성향과 심리 조건을 넣어 준다고 해서 정말 그 사람처럼 답할까요? 사람의 판단을 충분히 잘 흉내 낼 수 있을까요?
솔직히 말하면 100% 보장할 수 없습니다.
현재 실험에서도 동일한 질문을 반복했을 때 기존 선택을 유지한 비율이 60%대에 머물렀습니다.
관련 연구에서도 인구통계학적 속성을 바탕으로 사람의 응답을 재현했을 때 약 74% 수준의 일치도를 보였다는 결과가 있습니다. 다만 해당 연구와 이번 실험은 조건과 측정 방식이 다르기 때문에 두 수치를 직접 비교하기는 어렵습니다.
그래서 처음부터 사람을 완벽하게 복제하는 것을 목표로 잡지는 않았습니다.
중요했던 것은 “AI가 사람을 100% 재현할 수 있는가?”보다 “이 방식으로 여러 기획안 사이의 상대적인 반응 차이와 위험 신호를 찾아낼 수 있는가?”였습니다.
재현성을 높이는 것도 중요하지만, 최종적으로 보고 싶었던 것은 각 기획안 사이의 상대적인 차이와 어떤 방향으로 수정했을 때 더 나은 결과가 나오는지였습니다.
04결론
지금까지 실험하면서 확인한 것은 크게 세 가지입니다.
1. 무엇을 보여 주느냐뿐 아니라, 어떻게 보여 주느냐도 결과에 큰 영향을 줍니다.
같은 내용이라도 어떤 형태로 보여 주는지, 어디에 배치하는지에 따라 응답이 계속 달라졌습니다.
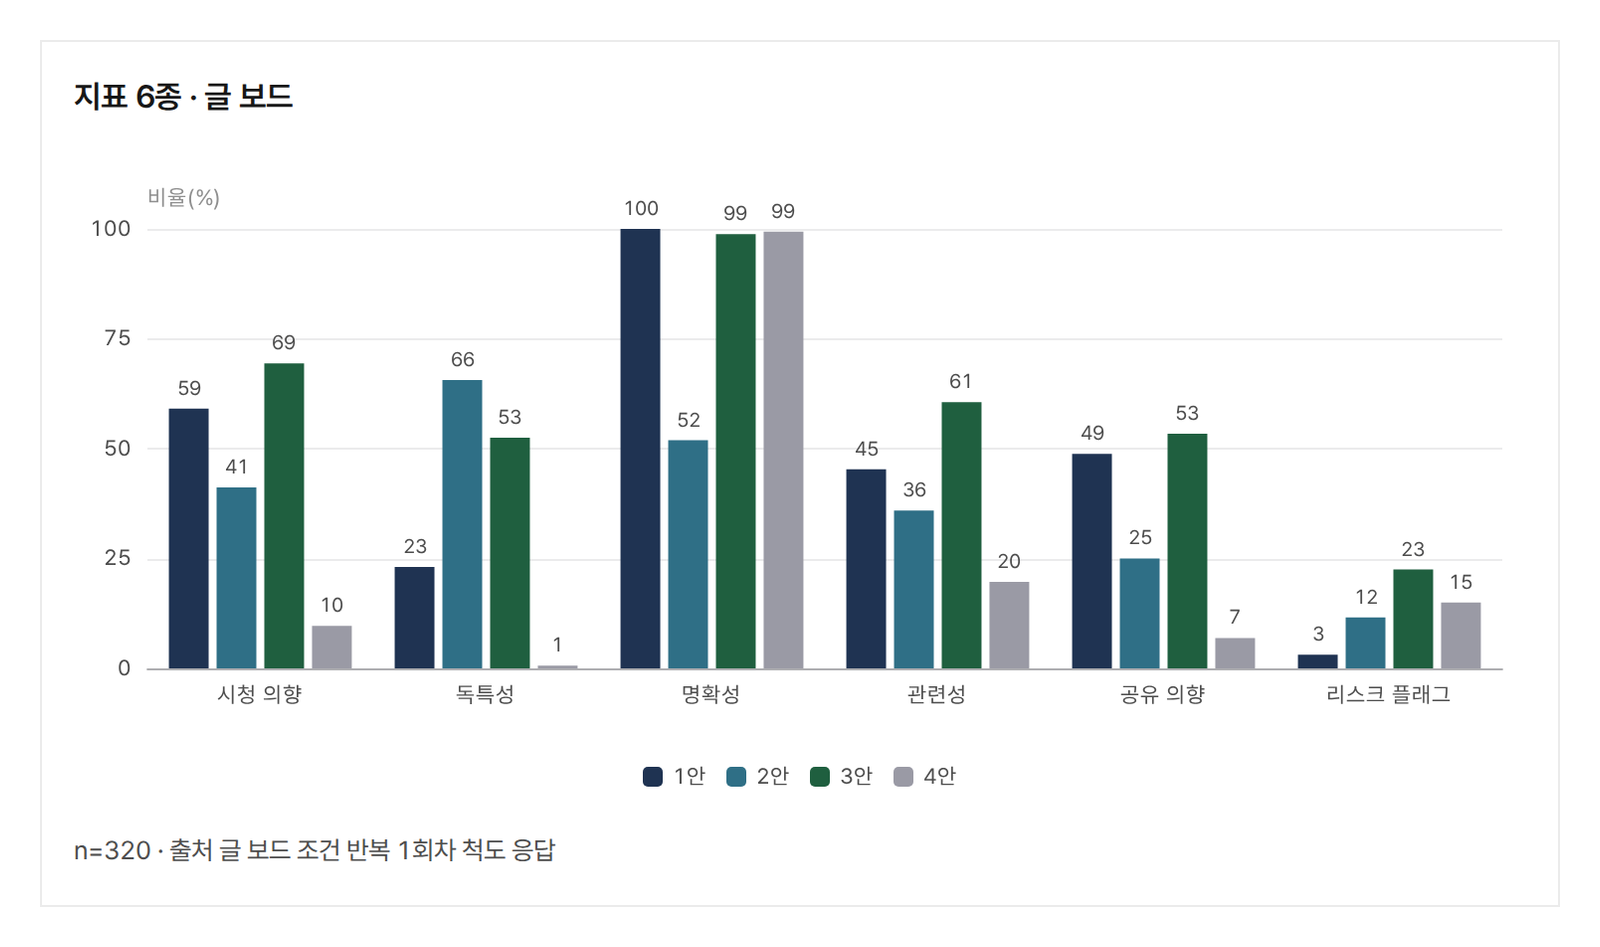
결국 단순한 프롬프트만으로 실제 콘텐츠가 전달되는 상황을 완전히 재현하기는 어려웠습니다. 텍스트로 설명하는 것과 실제 이미지를 보여 주는 것은 전혀 다른 결과를 만들었기 때문입니다. 그래서 제대로 테스트하려면 결국 실제 콘텐츠와 최대한 비슷한 이미지까지 만들어 보여 줘야 했습니다.
문제는 여기서부터 비용이 커진다는 점입니다. 텍스트만으로 테스트하면 전체 비용이 3천 원 수준에 그쳤지만, 실제 활용 가능한 지표를 얻으려면 이미지까지 제작해야 했고 그만큼 비용도 크게 늘어났습니다. 물론 만원선이었지만요
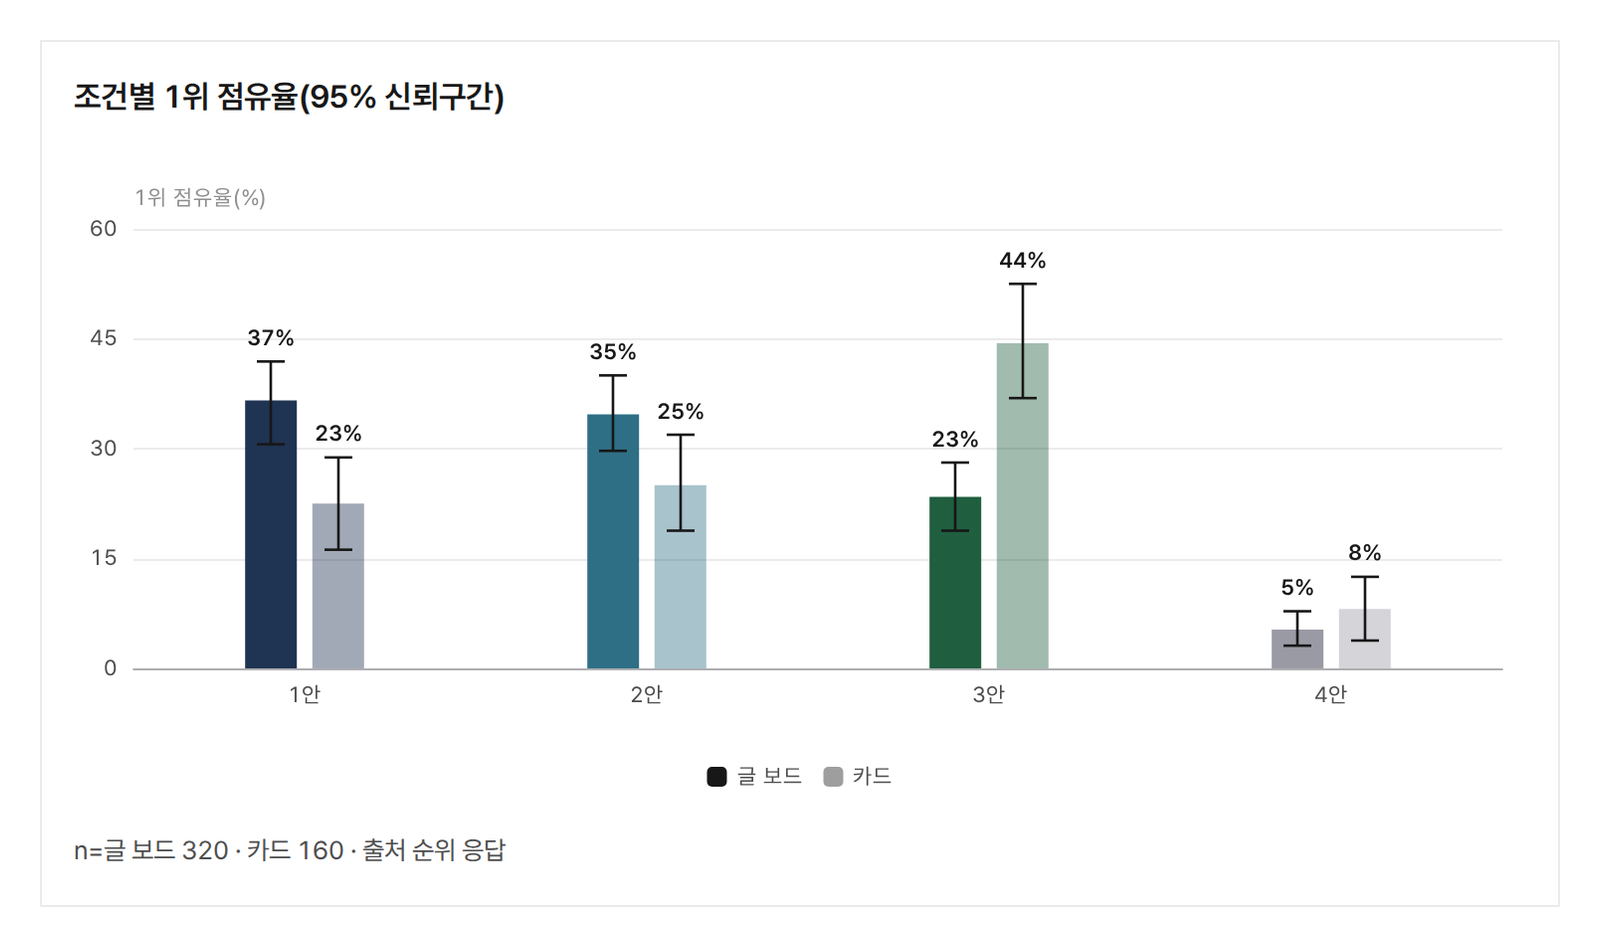
2. 세 개의 실사용 후보 가운데 명확한 순위를 정하지는 못했습니다.
사실 이 부분은 실험 설계 단계에서 목적을 충분히 구체화하지 못한 영향도 있습니다.
‘사람들이 가장 싫어할 콘텐츠를 찾겠다’, ‘가장 많이 팔릴 콘텐츠를 찾겠다’, ‘가장 높은 조회수를 얻을 콘텐츠를 찾겠다’처럼 하나의 명확한 목표를 먼저 정했어야 했는데, 이번에는 여러 반응을 한 번에 확인하려다 보니 무엇을 기준으로 최종 순위를 정해야 하는지가 모호했습니다.
그래서 세 안 가운데 어느 것이 가장 좋다고 결론 내리지는 못했습니다.
그렇기에 이제 이 부분은 추가 실험이 필요하다는 결론을 내렸습니다. 다만 각 기획안에 대해 AI가 제시한 이유와 반응을 하나씩 살펴봤을 때, 왜 그런 평가가 나왔는지는 어느 정도 납득할 수 있었습니다.
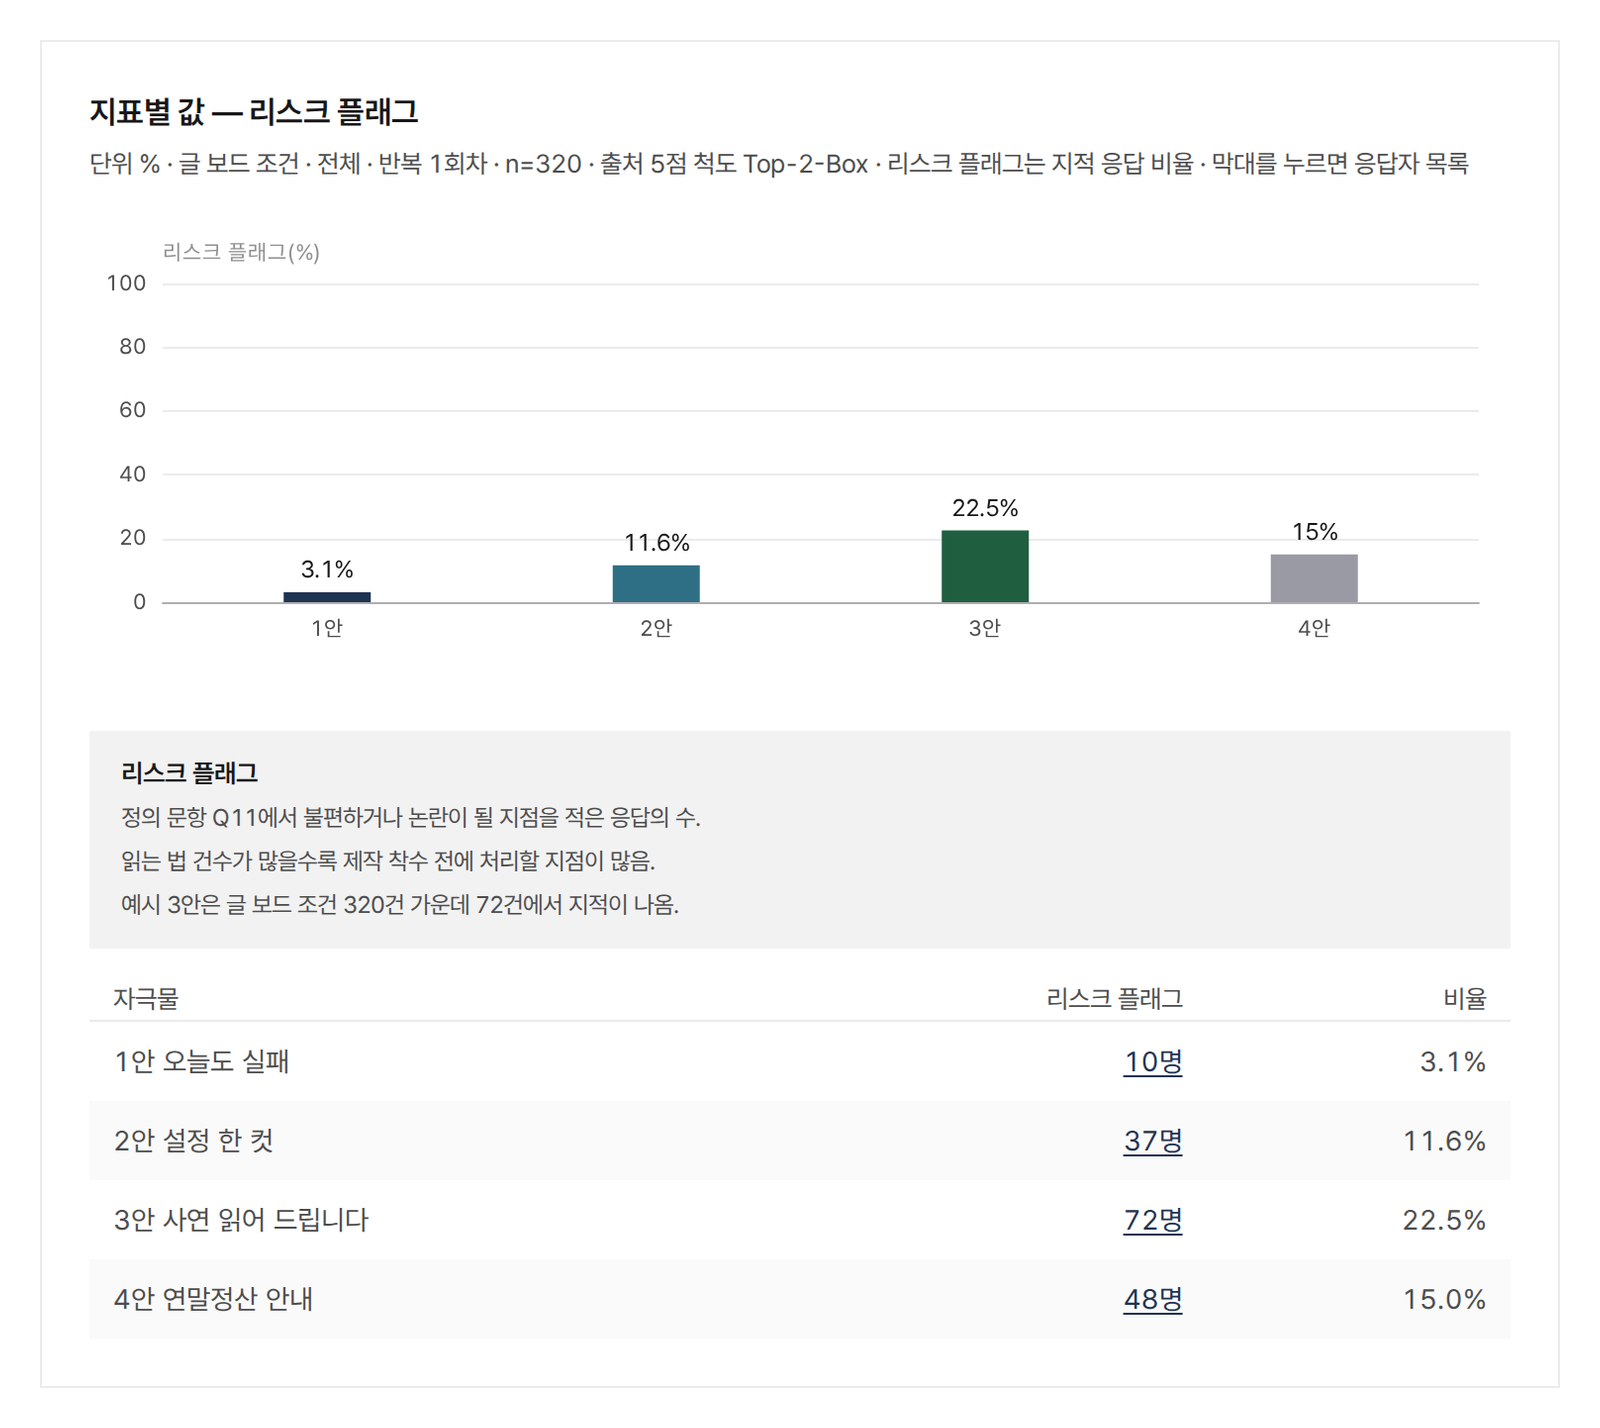
3. 오히려 부정적인 반응을 찾아내는 쪽에서 더 흥미로운 결과가 나왔습니다.
각 기획안에 대해 불만이나 거부 반응이 발생할 가능성이 있다고 분류된 응답은 각각 10건, 37건, 72건, 48건이었습니다.
그중 가장 많은 72건이 나온 안은 시청자의 사연을 캐릭터가 읽어 주는 콘텐츠였습니다.
여기서는
“사연은 누가 검수하는가?”
“개인적인 이야기를 콘텐츠로 사용해도 괜찮은가?”
“사생활 문제는 어떻게 처리할 것인가?”
같은 지적이 반복해서 등장했습니다. 사실 하나씩 보면 충분히 사람이 떠올릴 수 있는 문제들입니다. 하지만 중요한 것은 이런 문제를 막연히 예상하는 데서 끝나는 것이 아니라, 어떤 안에서 어떤 우려가 집중되는지를 먼저 찾아내고 그 지점을 더 깊게 파고들 수 있다는 점이었습니다.
설계가 잘들어간다면 꽤나 좋은 프로젝트로 발전할 수 있겠다 생각이 들었죠
05마치며
결국 지금 단계에서 제가 가장 가능성을 크게 보는 부분은 정답 찾기보다 걸러내기입니다.
군집 분석과 코호트 분석을 함께 적용해 320명의 가상 페르소나 데이터를 살펴보니, 제가 사전에 예상했던 문제와 겹치는 결과도 있었고 미처 생각하지 못했던 반론이나 우려도 확인할 수 있었습니다.
물론 이 지표가 정확하다는 이야기를 하고 싶은 것은 아닙니다.
AI가 실제 사람의 반응을 그대로 재현한다고 말할 수도 없고, 이 결과만 믿고 의사결정을 내려도 된다는 의미도 아닙니다. 다만 기존에는 사람을 직접 모아 의견을 물으려면 상당한 시간과 비용이 필요했으나 반드시 필요한 과정이었고 모든 아이디어를 감으로만 판단하는 것도 불가능합니다.
그 사이에서 AI 페르소나를 활용해 먼저 수백 개의 반응을 만들어 보고, 명백히 문제가 있는 안을 걸러내거나 예상하지 못했던 위험 요소를 찾아보는 것. 저는 지금 단계에서는 이 정도의 사전 검증용 보조 지표로 활용하는 것이 가장 현실적인 방향이라고 보고 있습니다.
참고 문헌
NVIDIA, Nemotron-Personas-Korea(CC BY 4.0). https://huggingface.co/datasets/nvidia/Nemotron-Personas-Korea
Park 외, Generative Agent Simulations of 1,000 People, 2024(개정판 제목 LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals). https://arxiv.org/abs/2411.10109
Kohavi, Tang, Xu, Trustworthy Online Controlled Experiments, Cambridge University Press, 2020, 19장. https://www.cambridge.org/core/books/abs/trustworthy-online-controlled-experiments/aa-test/D0779D2FB153D36DD4C624BA207E41C2
Oppenheimer, Meyvis, Davidenko, Instructional Manipulation Checks: Detecting Satisficing to Increase Statistical Power, Journal of Experimental Social Psychology 45(4), 2009. https://www.sciencedirect.com/science/article/abs/pii/S0022103109000766
실험데이터 비밀번호 0000
의견을 남겨주세요