안녕하세요, 이든이에요.
Claude Pro를 결제하고, Lovable로 만든 랜딩 페이지를 세 번째 갈아엎던 어느 새벽이었습니다. 분명히 "장바구니 버튼 색을 바꿔줘"라고 했을 뿐인데, 화면에는 같은 버튼이 네 개로 늘어나 있었어요. 30분 전엔 멀쩡했던 로그인까지 깨져 있었고요.
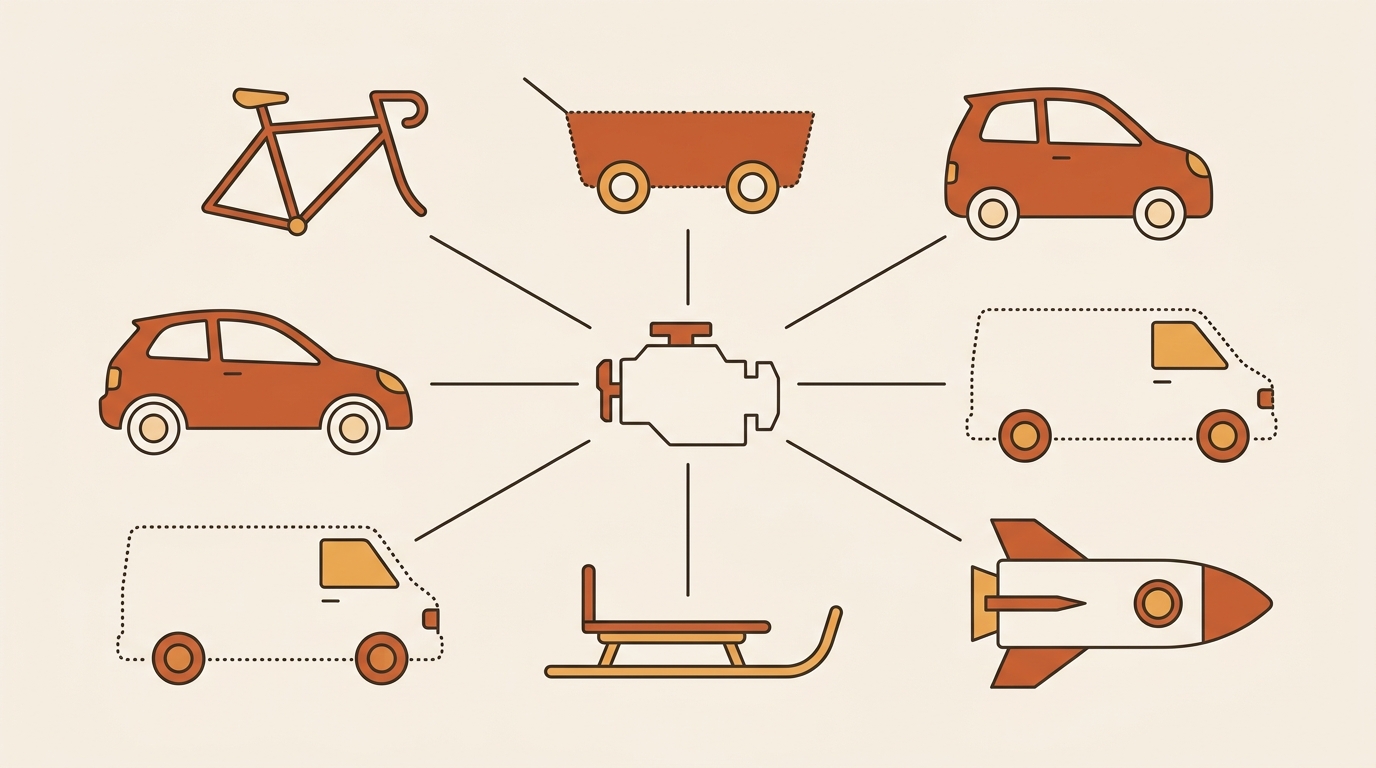
그날 제가 제일 먼저 의심한 건 모델이었어요. 얘가 멍청해진 건가, 더 비싼 모델로 갈아타야 하나. 그런데 파고들수록 답은 반대쪽에 있었습니다. 문제는 모델이 아니라 모델이 일하는 환경이었어요. 오늘은 그 환경, 하네스(harness) 이야기를 하려고 해요.
🎨 하네스가 뭔지부터
AI 업계에서 하네스는 이렇게 정의됩니다. 모델 가중치(weights) 바깥의 모든 작동 환경. 지시문, 메모리, 도구, 검증 장치, 세션 관리까지 전부 포함입니다.
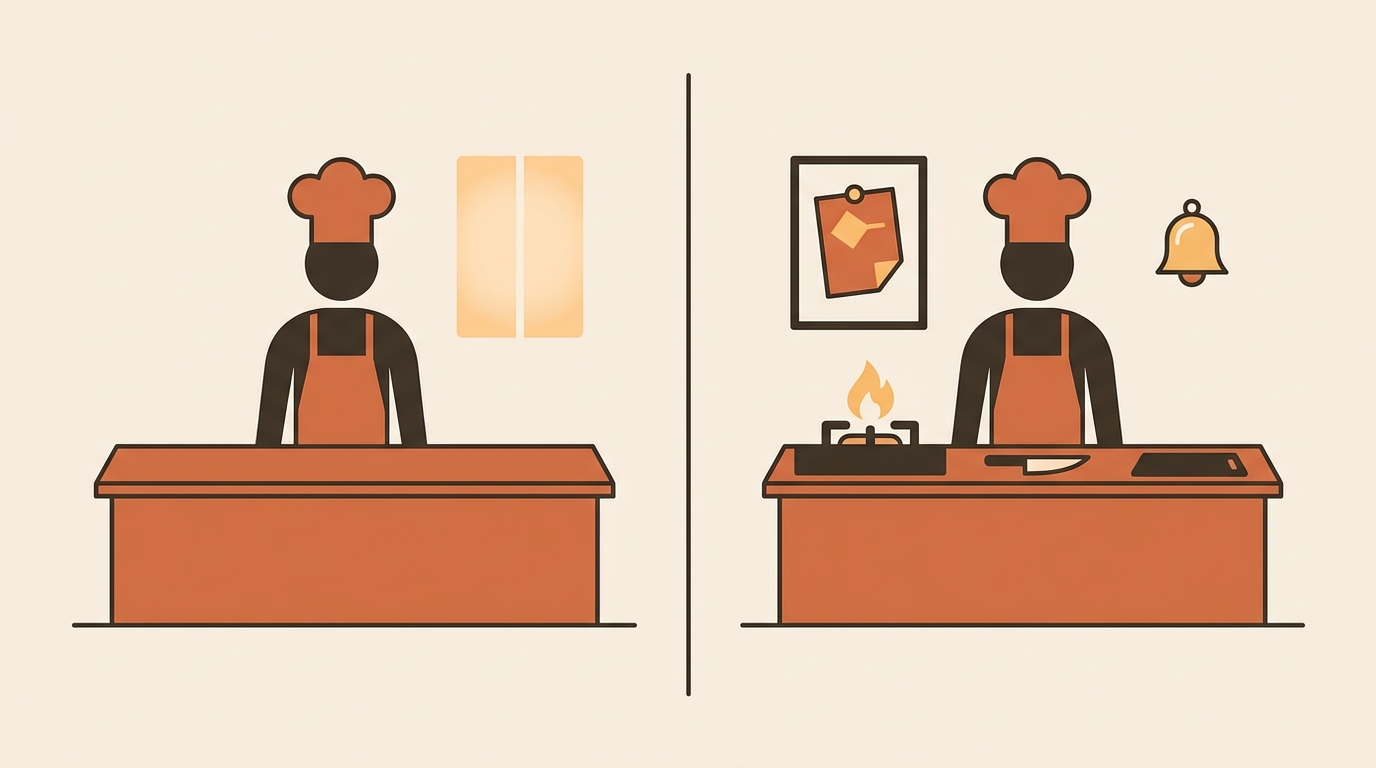
말이 어려우니 장면 하나로 바꿔볼게요. 미슐랭 셰프를 데려와 "파스타 만들어 주세요"라고 했는데, 주방에 가스레인지도 칼도 레시피도 없다고 상상해 보세요. 셰프 실력은 그대로인데 접시는 나오지 않습니다. 우리가 AI에게 매일 하고 있는 게 정확히 이거예요.
제 플레이북에서는 하네스를 다섯 개의 방으로 나눠 설명해요.
| 방 | 하는 일 | 주방으로 치면 |
|---|---|---|
| 의도(Intent) | "무엇을, 왜" 알려줌 | 셰프에게 건네는 오늘의 메뉴판 |
| 메모리(Memory) | 어제 한 일을 기억함 | 주방 칠판에 적힌 어제 재고 |
| 실행(Execution) | 실제로 칼을 잡고 불을 켬 | 가스레인지, 도마, 팬 |
| 검증(Verification) | "다 됐어요"가 진짜인지 확인 | 손님에게 내기 전 시식 |
| 세션(Session) | 길게 끊지 않고 잇기 | 점심 영업과 저녁 영업의 인수인계 |
한 줄로 줄이면 이래요. 모델은 직원, 하네스는 사무실이에요.
👉 다섯 개 방을 하나씩 차리는 순서는 플레이북 챕터 2에 있어요. 프로젝트 폴더 하나, CLAUDE.md 한 장, 기능 목록, 진행 기록, 세션 종료 체크리스트 다섯 줄이면 시작됩니다.
🤔 벤더 평가표에는 모델 칸만 있습니다
PM으로 일하면서 벤더 비교표를 참 많이 봤어요. 거기엔 거의 항상 모델 벤치마크 점수가 있습니다. 이 제품은 몇 점, 저 제품은 몇 점, 3%p 높으니 이쪽으로 가자. 그렇게 도장이 찍히는 회의를 여러 번 봤어요.
그런데 그 표를 다시 들여다보면 이상한 게 있습니다. 하네스 칸이 없어요. 우리 팀 규칙을 담은 문서를 에이전트가 읽는지, 어제 한 일을 기억하는지, 완료라고 말하기 전에 진짜로 확인을 하는지 묻는 칸이 아예 없습니다. 정작 우리가 매일 겪는 실패는 대부분 그 칸에서 나오는데요.
🔍 단서 세 개
파고들수록 단서가 쌓이더라고요. 세 개만 소개할게요.
단서 1. 모델을 고정하고 하네스만 바꾼 실험이 있었어요.
Composio가 8월 11일에 공개한 Finding the Best Harness for DeepSeek V4 Flash입니다. 모델은 DeepSeek V4 Flash 하나로 고정하고 하네스만 8종으로 바꿔 과제 30개를 돌렸어요. 총 240회 실행. 과제는 Airtable, Gmail, GitHub, Slack 같은 SaaS 앱을 오가며 실제 작업을 하는 것이고, 채점은 인상 평가가 아니라 프로그래밍 방식 검증자가 연결된 앱의 실제 상태(올바른 레코드, 정확한 계산, 함정 데이터 미변경)를 검사했습니다.
| 하네스 | 성공률 | 중앙값 시간 | 성공당 비용 |
|---|---|---|---|
| Pi Agent | 66.7% | 132.2초 | $0.028 |
| Prime Agent | 62.5% | 242.1초 | $0.131 |
| OMP | 56.7% | 272.4초 | $0.103 |
| Claude Code | 53.3% | 122.7초 | $0.195 |
| Codex | 53.3% | 245.0초 | $0.081 |
| DeepAgents | 53.3% | 187.1초 | $0.045 |
| Hermes Agent | 50.0% | 175.5초 | $0.056 이상 |
| OpenCode | 46.7% | 129.7초 | $0.073 |
같은 모델인데 최저 46.7%(OpenCode)와 최고 66.7%(Pi Agent)의 차이가 20%p예요. 그리고 돈을 더 쓴다고 정확해지지도 않았습니다. 성공 1건당 비용이 가장 비싼 Claude Code($0.195)는 성공률에서 중간이었어요. 저자의 결론은 한 줄이에요. "하네스는 모델만큼 중요할 수 있다(Harnesses can matter as much as the models they run)." 비용, 속도, 신뢰성을 크게 바꾼다는 거죠.
단서 2. Salesforce는 "한 번 됐다"를 성공으로 세지 않아요.
Salesforce Engineering이 8월 17일에 낸 How to Evaluate Production AI Agents입니다. CRMAgentBench라는 벤치마크를 만들면서 pass^k라는 지표를 써요. 같은 과제를 k번 독립적으로 돌렸을 때 전부 성공할 확률입니다. 원문의 예시가 정확해요. 10번 중 9번 성공하는 에이전트도 pass^10은 3분의 1 근처로 떨어집니다(succeed 9 times out of 10, and pass^10 already drops to about one-in-three).
10번 중 9번이면 우리는 보통 훌륭하다고 부르죠. 그런데 10번 연속을 요구하는 순간 확률은 3분의 1이 됩니다. 데모에서 잘 되던 에이전트가 현업에 들어가자마자 원성을 사는 이유가 이 계산 안에 다 들어 있어요.
평가 기준도 단호합니다. "최종 상태가 맞는 것은 필요조건이지 충분조건이 아니다(Correct final state is necessary. It is not sufficient)." 그래서 이 팀은 세 가지를 묻습니다. 에이전트가 올바른 행동을 했는가, 올바른 인자와 순서로 했는가, 시스템이 의도한 최종 상태에 도달했는가.
단서 3. LangChain은 에이전트를 파일로 정의합니다.
LangChain의 Harrison Chase가 8월 12일에 쓴 Why managed agents are the next big thing in agent building이에요. 관리형 에이전트를 소개하는 글인데, 제 눈에 걸린 건 이 문장이었습니다. "비즈니스 로직은 언제나 직접 가져와야 한다(You always need to bring your own business logic)." 기성품 하네스가 시작을 쉽게 만든 건 맞지만, 프로덕션에서 만나는 문제는 따로 있다는 거예요.
벤더가 아무리 좋은 껍데기를 줘도 우리 팀 규칙은 우리가 넣어야 합니다. 그 규칙을 어디에 두느냐에 대한 답도 같은 글에 있어요. LangChain은 자기들의 Fleet 에이전트를 "파일시스템의 파일로 표현하고 정의했다(represented and defined Fleet agents just as files in a filesystem)"고 밝힙니다.
세 단서를 한 문장으로 이으면 이렇게 됩니다. 같은 모델이라도 하네스에 따라 성공률이 20%p 갈리고, 그 성공은 한 번이 아니라 열 번 기준으로 재야 하며, 하네스의 핵심인 우리 팀 규칙은 결국 파일로 우리가 직접 넣어야 한다.
🧪 직접 돌려봤습니다
남의 실험만 인용하기엔 찜찜해서, 이번 주에 축소판을 제 손으로 돌렸어요.
설계는 이렇습니다. 같은 모델(Claude Code 헤드리스, 기본 모델)로 파이썬 함수 구현 과제를 두 조건에 돌렸어요.
- 조건 A "맨몸"은 파일 쓰기만 허용, 테스트 작성과 실행 금지, 단발 응답.
- 조건 B "하네스"는 경계 조건을 먼저 목록화하고 테스트를 먼저 쓴 뒤 구현, 실행, 재시도하며, 통과 출력을 확인하기 전에는 완료라고 말하지 못하게 했습니다. 다섯 개 방 중 의도, 실행, 검증 세 개만 붙인 최소 하네스예요. 채점은 모델이 볼 수 없는 숨은 테스트로 했습니다.
| 과제 묶음 | 맨몸 통과 | 맨몸 평균 시간 | 하네스 통과 | 하네스 평균 시간 |
|---|---|---|---|---|
| 쉬운 과제 12개 | 11/12 | 16초 | 12/12 | 117초 |
| 어려운 과제 6개 | 6/6 | 32초 | 6/6 | 132초 |
| 합계 18개 | 17/18 | 21초 | 18/18 | 122초 |
솔직히 제가 기대한 그림은 아니었어요. 명세가 완결된 단일 함수 과제에서는 맨몸도 18개 중 17개를 통과했습니다. 하네스가 얻은 건 통과 1건, 대가는 시간 약 6배였어요. 이 유형의 과제에서 하네스 효과는 작습니다. 어려운 과제 6개에서도 양쪽 다 6/6이었으니, "어려워질수록 갈렸다"고 말할 근거도 이 데이터엔 없어요.
다만 그 1건의 성격이 걸립니다. 맨몸이 실패한 과제는 RLE(런 렝스 부호화)였고, 숨은 테스트의 경계 조건 하나에서 틀렸어요. 중요한 건 실패한 방식이에요. 맨몸은 "완료했다"고 보고하고 끝냈습니다. 테스트를 돌리지 않았으니 틀린 줄 몰랐던 거예요. 같은 과제를 하네스는 테스트를 먼저 쓰고 실행과 재시도를 거쳐 236초 만에 통과했고요. Salesforce의 문장이 여기에 정확히 붙습니다. 최종 상태가 맞는 것은 필요조건이지 충분조건이 아니다.
각 과제를 한 번씩만 돌렸으니 표본이 작습니다. 이 실험이 보여준 건 "하네스가 늘 이긴다"가 아니라 경계예요. 하네스가 값을 하는 곳은 한 번에 끝나는 함수가 아니라, 여러 단계와 상태가 있는 긴 작업입니다. Composio 실험에서 20%p가 갈린 과제들, 그러니까 여러 SaaS 앱을 오가며 상태를 바꾸는 작업이 정확히 그 종류였고요.
🌏 이게 향하는 곳
지난 몇 년의 경쟁은 모델 점수 싸움이었어요. 다음 몇 년은 하네스 싸움이 될 거라고 봅니다.
Anthropic이 Claude Opus 4.5 시스템 카드에서 공개한 실험이 상징적입니다. 같은 모델에 같은 과제를 줬는데, 도구가 없는 맨손 조건에서는 20분 만에 포기했어요. 약 9달러를 쓰고 실패했습니다. 하네스를 장착한 조건에서는 6시간을 끈질기게 진행해 성공했고, 약 200달러가 들었어요. 같은 모델, 같은 과제, 비용은 20배 넘게 차이 나고 결과는 반대입니다.
SWE-bench Verified에서도 똑같은 모델이 환경에 따라 50%대와 60%대를 오갑니다. 모델을 그대로 두고 환경만 바꿔도 리더보드 순위가 갈리는 폭이 움직인다는 뜻이에요.
PM 관점에서 이게 무슨 의미냐면, 벤더를 갈아타서 얻는 개선폭보다 우리 하네스를 정비해서 얻는 개선폭이 더 클 수 있다는 겁니다. 그리고 후자는 새 계약서 없이 이번 주에 시작할 수 있어요.
🧰 에이전트 벤더 평가 체크리스트
다음 벤더 비교표를 만들 때, "모델 성능" 칸 옆에 이 여섯 칸을 두세요. 그대로 복사해 쓰셔도 됩니다.
- 의도
- 메모리
- 실행
- 검증
- 세션
- pass^k
앞의 다섯은 하네스의 다섯 개 방이고, 마지막 하나는 Salesforce식 질문이에요. 이 여섯 칸에 O를 몇 개 칠 수 있는지가, 벤치마크 3%p 차이보다 우리 팀의 다음 6개월을 더 정확하게 예측합니다.
여섯 칸을 어떻게 확인하는지도 적어 둘게요. 벤더 데모 자리에서 그대로 물어보시면 됩니다.
의도: 우리 팀 규칙을 담은 문서 한 장을 에이전트가 시작할 때 읽는가. 저는 프로젝트마다 CLAUDE.md 한 장을 두고 "무엇을, 왜"와 금지 사항을 적어요. 이 칸이 비어 있으면 같은 규칙을 매번 프롬프트에 되풀이하게 되고, 하루만 지나도 규칙이 새어 나갑니다.
물어볼 것: "우리 규칙 파일을 주면 그걸 읽고 시작하나요?"
메모리: 어제 한 일이 파일로 남는가. 채팅창 기록이 아니라 진행 기록 파일(progress.md 같은 것)이 남아야 다음 세션과 다음 사람이 이어받아요.
물어볼 것: "세션을 꺼다 켜면 어제 어디까지 했는지 아나요?"
실행: 실제로 코드를 돌리고 브라우저를 여는가. "이렇게 하시면 됩니다"라고 말하는 것과 직접 실행해 결과 파일을 남기는 것은 다른 제품이에요.
물어볼 것: "실행 로그와 결과물을 보여 주세요." 말로 된 답만 오면 이 칸은 비어 있는 겁니다.
검증: 완료 전에 테스트나 실제 상태 확인을 강제하는가. 제 실험의 맨몸 조건이 정확히 이 칸이 빈 상태였고, 그래서 틀린 채로 "완료"를 보고했어요.
물어볼 것: "테스트를 안 돌리고도 완료라고 말할 수 있나요?" 답이 "네"면 조용한 실패가 들어옵니다.
세션: 긴 작업을 끊지 않고 이어가는가. Opus 4.5 실험에서 하네스 조건이 6시간을 끌고 간 게 이 칸이에요. 저는 세션 종료 체크리스트 다섯 줄로 점심 영업과 저녁 영업을 인수인계합니다.
물어볼 것: "한 시간 넘는 작업이 중간에 끊기면 어디서부터 다시 하나요?"
pass^k (k 제곱): 같은 과제를 10번 돌리면 10번 다 되는가. 데모는 한 번 보여 주는 자리라 늘 성공해요. 열 번 돌려 달라고 하세요. 9번 성공이면 pass^10은 3분의 1입니다.
물어볼 것: "이 과제를 지금 열 번 연속으로 돌려 주세요."
🎯 오늘의 한 줄
모델을 바꾸기 전에 하네스를 점검해 봤습니까. 한 번 되는 건 데모입니다. k번 반복해서 되는 게 운영입니다.
📮 이번 주 질문
지금 팀에서 쓰는 에이전트, 같은 과제를 열 번 돌리면 열 번 다 되나요? 아니라면 몇 번째에서 무너지나요?
- 월요일 할 일: 벤더 비교표에 하네스 다섯 칸을 추가하고, 지금 쓰는 에이전트에 그 다섯 칸 중 몇 개가 있는지 표시해 보세요.
이든 드림 · AI 네이티브 PM · Agentic AI 제품 리드
🔗 오늘의 레터 출처
Finding the Best Harness for DeepSeek V4 Flash (Composio)
How to Evaluate Production AI Agents (Salesforce Engineering)
Why managed agents are the next big thing in agent building (LangChain)
하네스가 벤치마크를 이겼다 (blog.habix.ai) · 이 글의 46.7%→56.7%는 8종 중 일부 수치, 전체 표는 위 Composio 원문 기준
의견을 남겨주세요