이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
그렉 아이젠버그는 최근 책상 위에 DGX Spark라는 고성능 AI 워크스테이션을 들였습니다. 그런데 정작 영상에서 하는 말은 반대예요. 비싼 장비부터 사지 말고, 2021년에 산 남는 노트북이나 휴대폰으로 먼저 시작하라고 하거든요.
요즘 ChatGPT와 Claude는 다들 써 봤지만, 허깅페이스(Hugging Face), 올라마(Ollama), LM 스튜디오(LM Studio) 같은 이름을 들으면 "그건 개발자들 얘기"라며 넘기는 사람이 많습니다. 그렉은 이게 실수라고 말해요. 대부분의 사람이 아직 로컬 AI의 지도를 갖고 있지 않고, 그래서 기회가 비어 있다는 겁니다.
스타트업 아이디어 팟캐스트를 진행하는 그렉이 이번에는 게스트 없이 혼자 마이크를 잡았습니다. 로컬 AI가 뭔지, 어떤 모델부터 돌려야 하는지, 그리고 로컬 AI를 무기로 삼은 창업 아이디어 세 개까지 풀어놨어요. 구글이 후원한 회차라 구글의 오픈 모델 젬마(Gemma)가 주된 예시로 나옵니다.
기술을 몰라도 따라올 수 있게 설명한 회차라, 1인 창업가에게 필요한 내용 위주로 인터뷰 형식으로 옮겼습니다.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
어디에 지능을 둘 것인가
Q. 로컬 AI가 정확히 뭔가요?
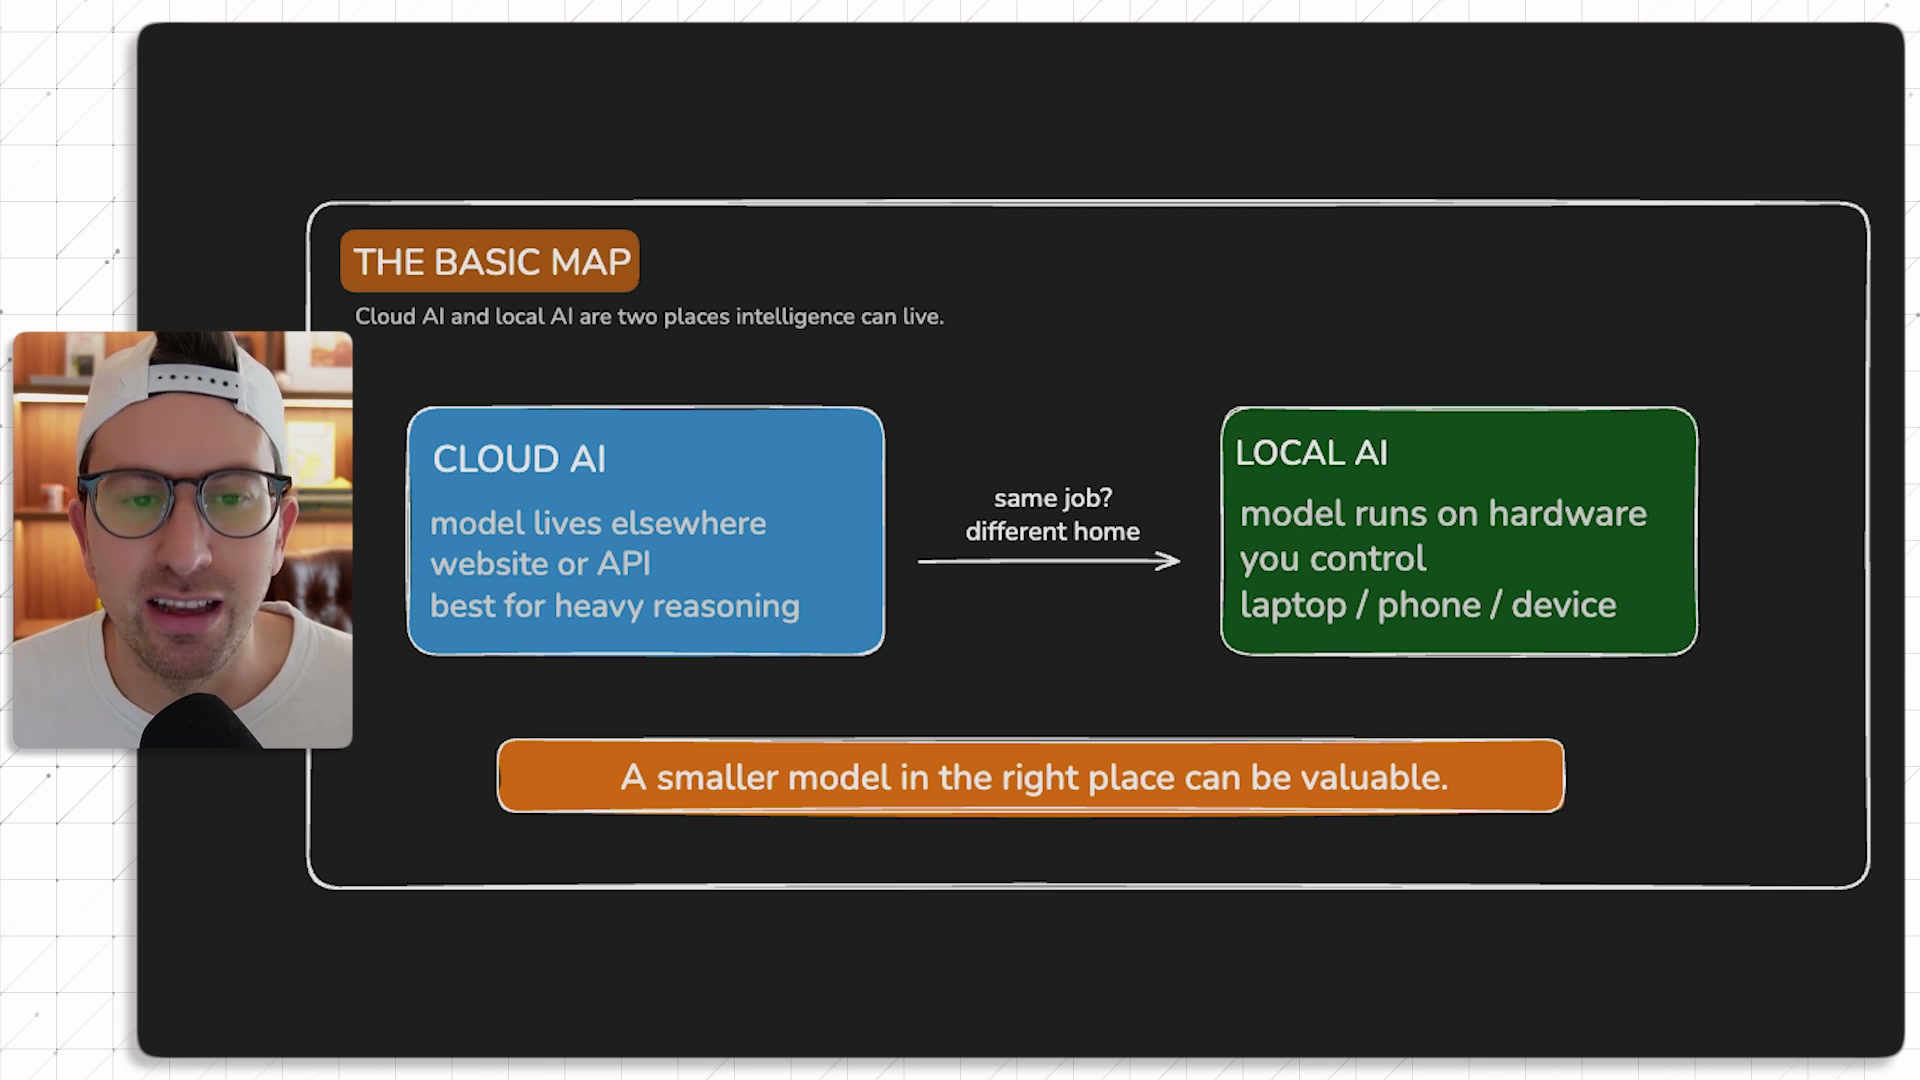
간단히 말하면, 모델이 내가 통제하는 하드웨어 위에서 돌아가는 거예요. 맥북일 수도 있고 윈도 노트북, 안드로이드폰, 아이폰일 수도 있어요. 저는 얼마 전에 DGX Spark라는 고급 장비를 들였는데, 중요한 건 이제 휴대폰으로도 로컬 AI를 돌릴 수 있다는 점이에요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
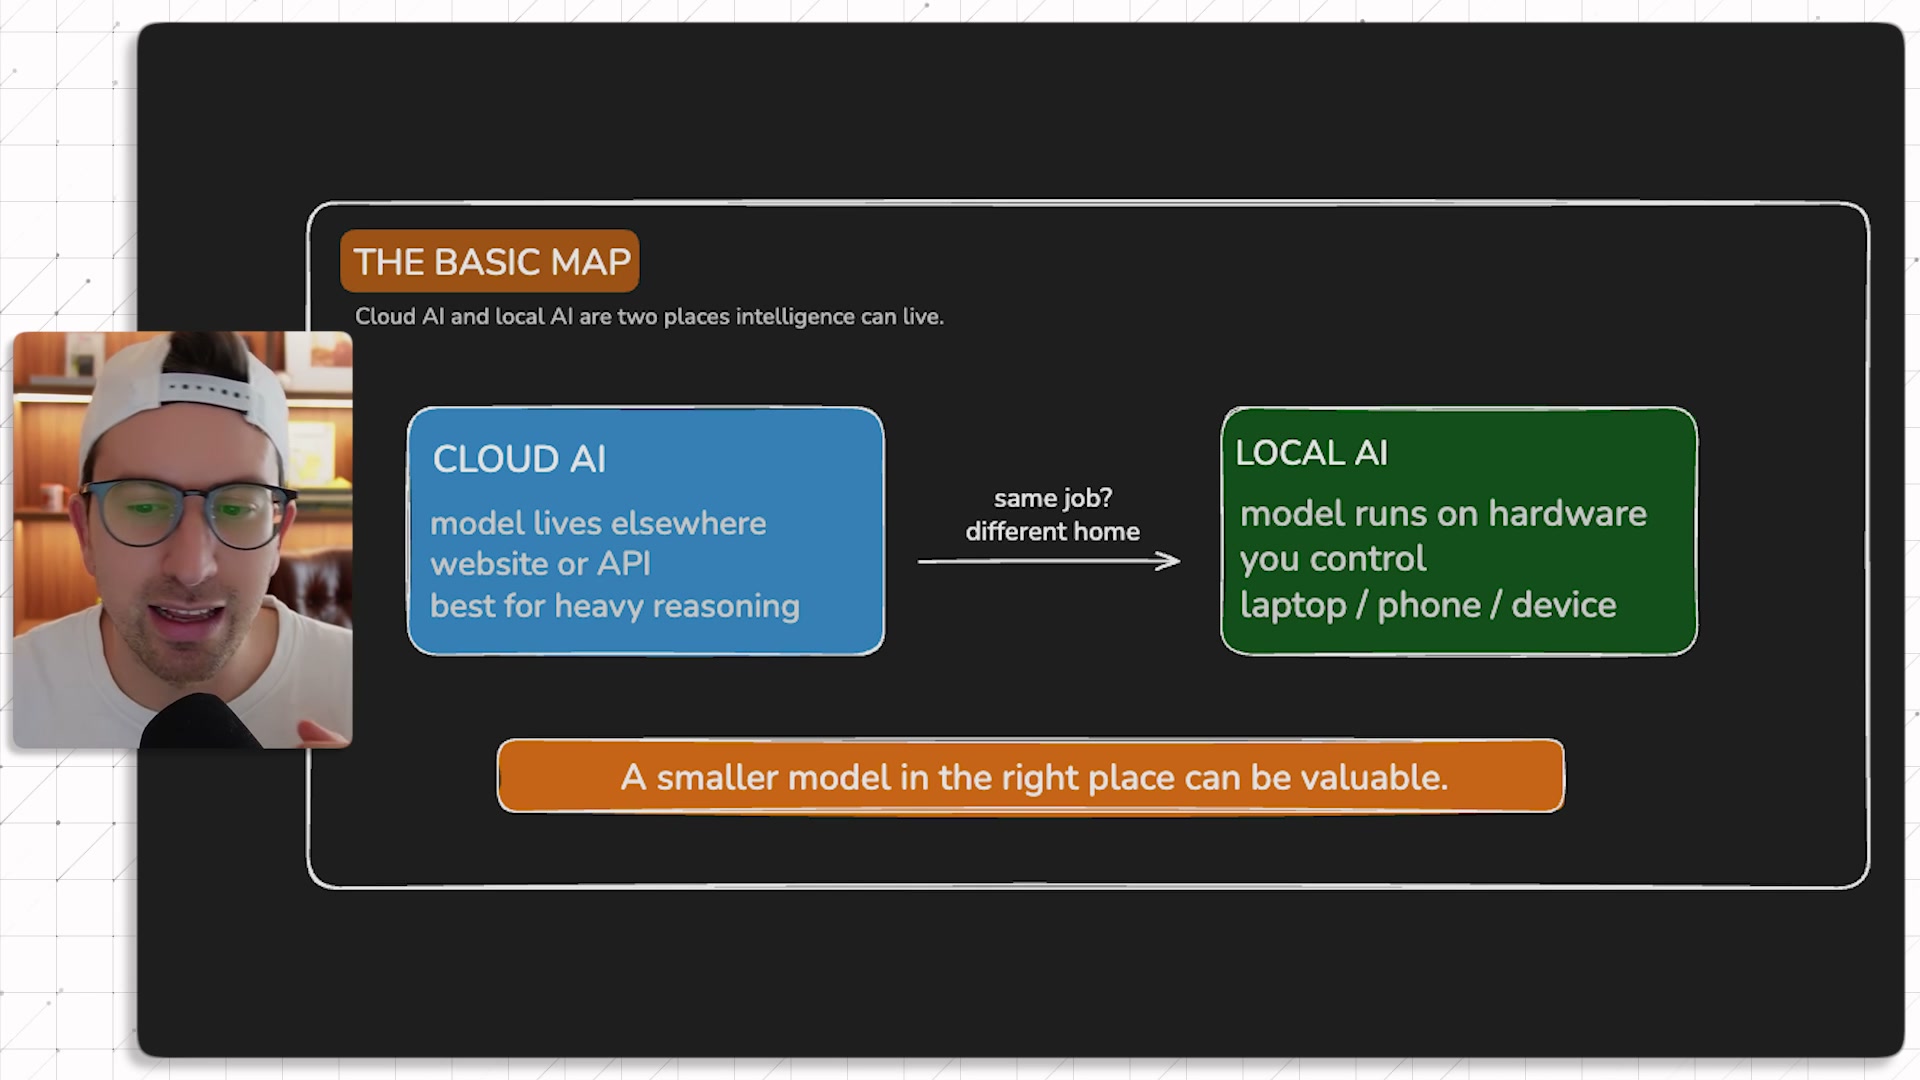
클라우드 AI는 모델이 다른 곳에서 돌아가고, 나는 웹사이트나 API로 접속해서 쓰는 거죠. 기본적인 차이는 그게 전부예요.
Q. 그럼 언제 로컬을 써야 하나요?
사업 관점의 질문은 "지능이 어디에 있어야 하느냐"예요. 깊은 리서치나 전략, 어려운 추론처럼 가장 강한 모델이 필요한 일이면 저도 클라우드의 프런티어 모델(frontier model, 각 회사의 최상위 성능 모델)을 씁니다.
그런데 민감한 고객 데이터가 든 파일을 다루거나, 인터넷 없이 현장에서 일하거나, 반응이 빨라야 하거나, 음성 입력을 받거나, 같은 내부 업무를 몇 번이고 반복한다면 얘기가 달라져요. 이때부터 로컬 AI가 말이 되기 시작합니다.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
작은 모델이라도 제자리에 있으면 아주 값질 수 있어요. 이 생각 하나만 머릿속에 넣어 두세요.
Q. 사람들이 로컬 모델을 보면 제일 먼저 묻는 질문이 있다고요.
네, 대부분 "이 모델이 클라우드의 제일 큰 모델보다 똑똑해?"라고 물어요. 그런데 더 쓸모 있는 질문은 따로 있습니다.
"이 모델이 이 일을 하기에 충분한가, 그리고 로컬에서 돌리면 제품이 더 나아지는가." 질문을 이렇게 바꾸는 순간 사업 기회가 보이기 시작해요.
모델, 창고, 소프트웨어, 그리고 워크플로
Q. 로컬 AI를 이루는 조각이 네 개라고요.
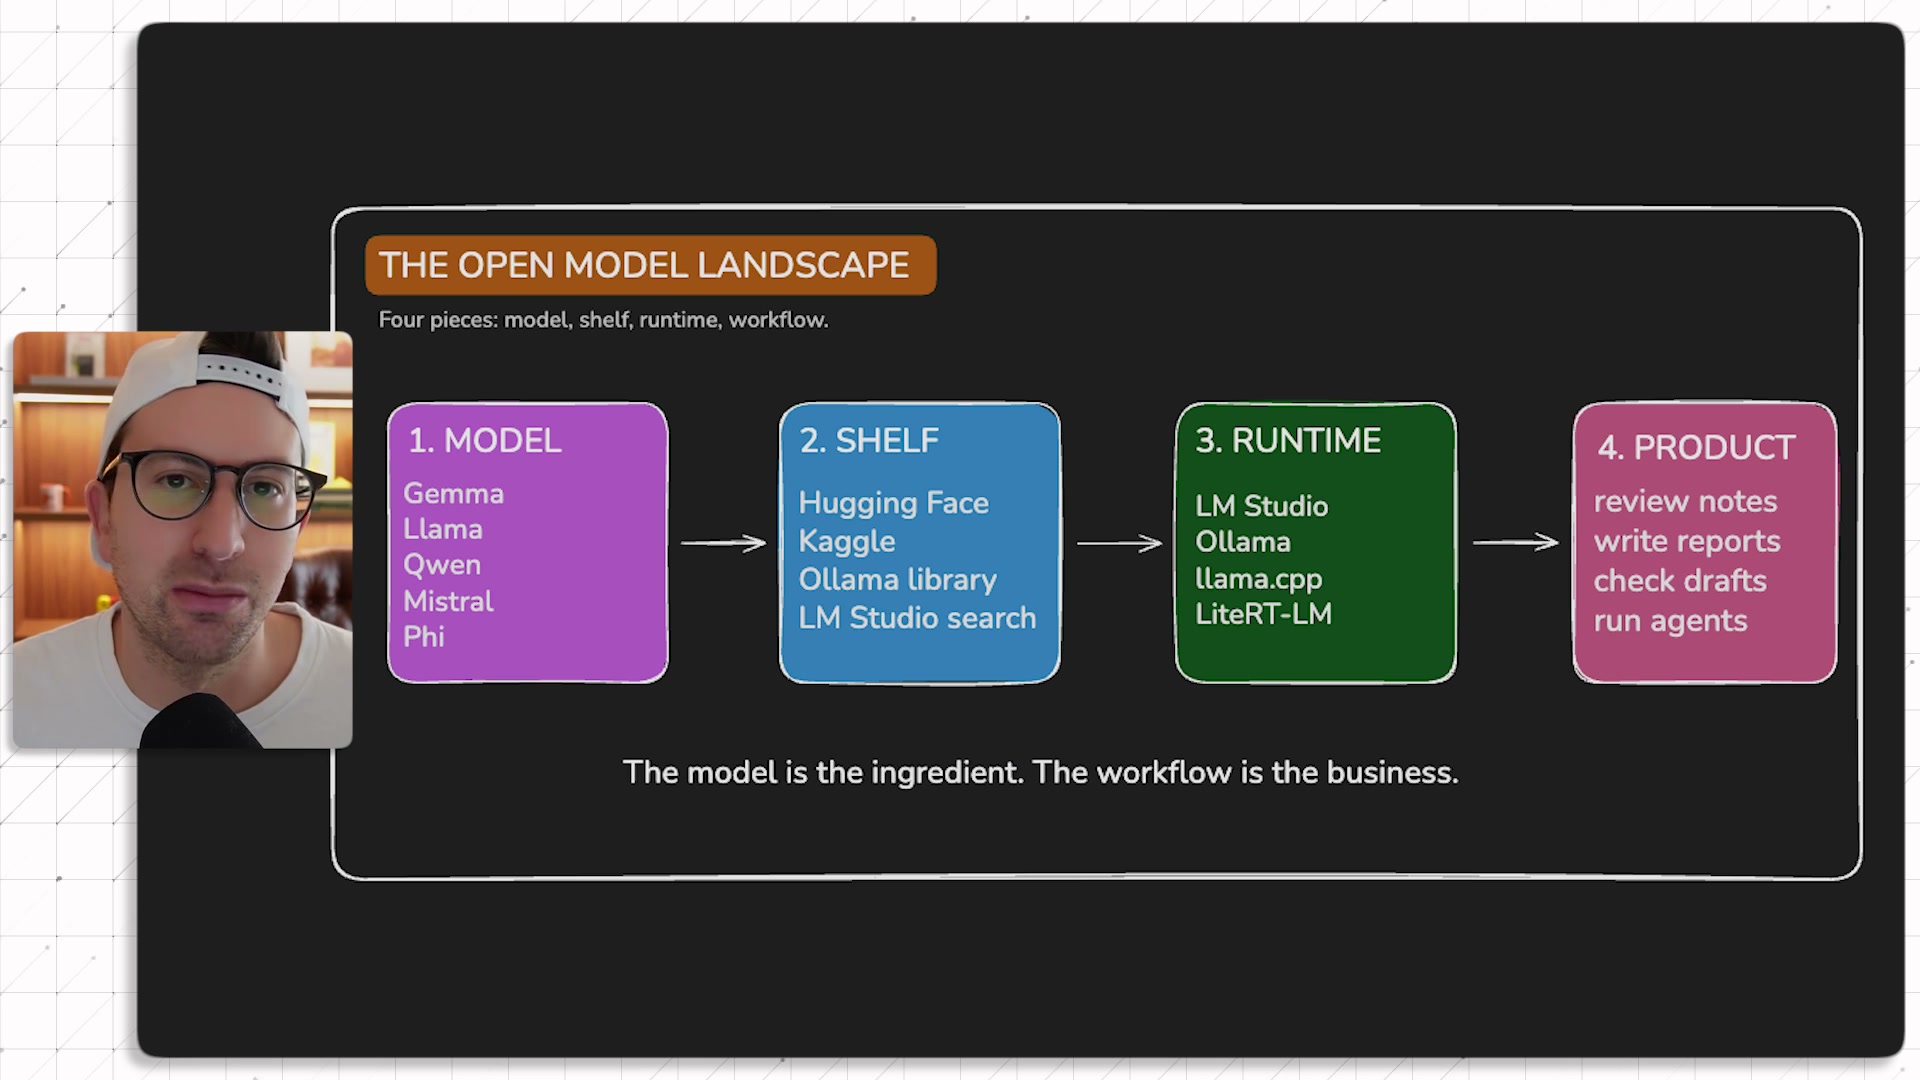
모델, 창고, 소프트웨어, 워크플로예요. 모델은 두뇌 파일이에요. 젬마, 라마(Llama), 미스트랄(Mistral) 같은 것들이죠. 추론, 코딩, 이미지, 속도 중 어디에 강한지가 저마다 달라요. 창고는 모델을 찾는 곳인데, 허깅페이스가 대표적이에요. 지금 130억 달러(약 18조 2천억 원)에 인수되려고 한다는 얘기도 있더라고요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
소프트웨어는 모델을 실제로 돌리는 프로그램이고, LM 스튜디오나 올라마가 여기에 해당해요. 마지막 워크플로는 이 모든 걸 엮어서 만드는 제품입니다.
Q. 허깅페이스는 어떻게 쓰면 되나요?
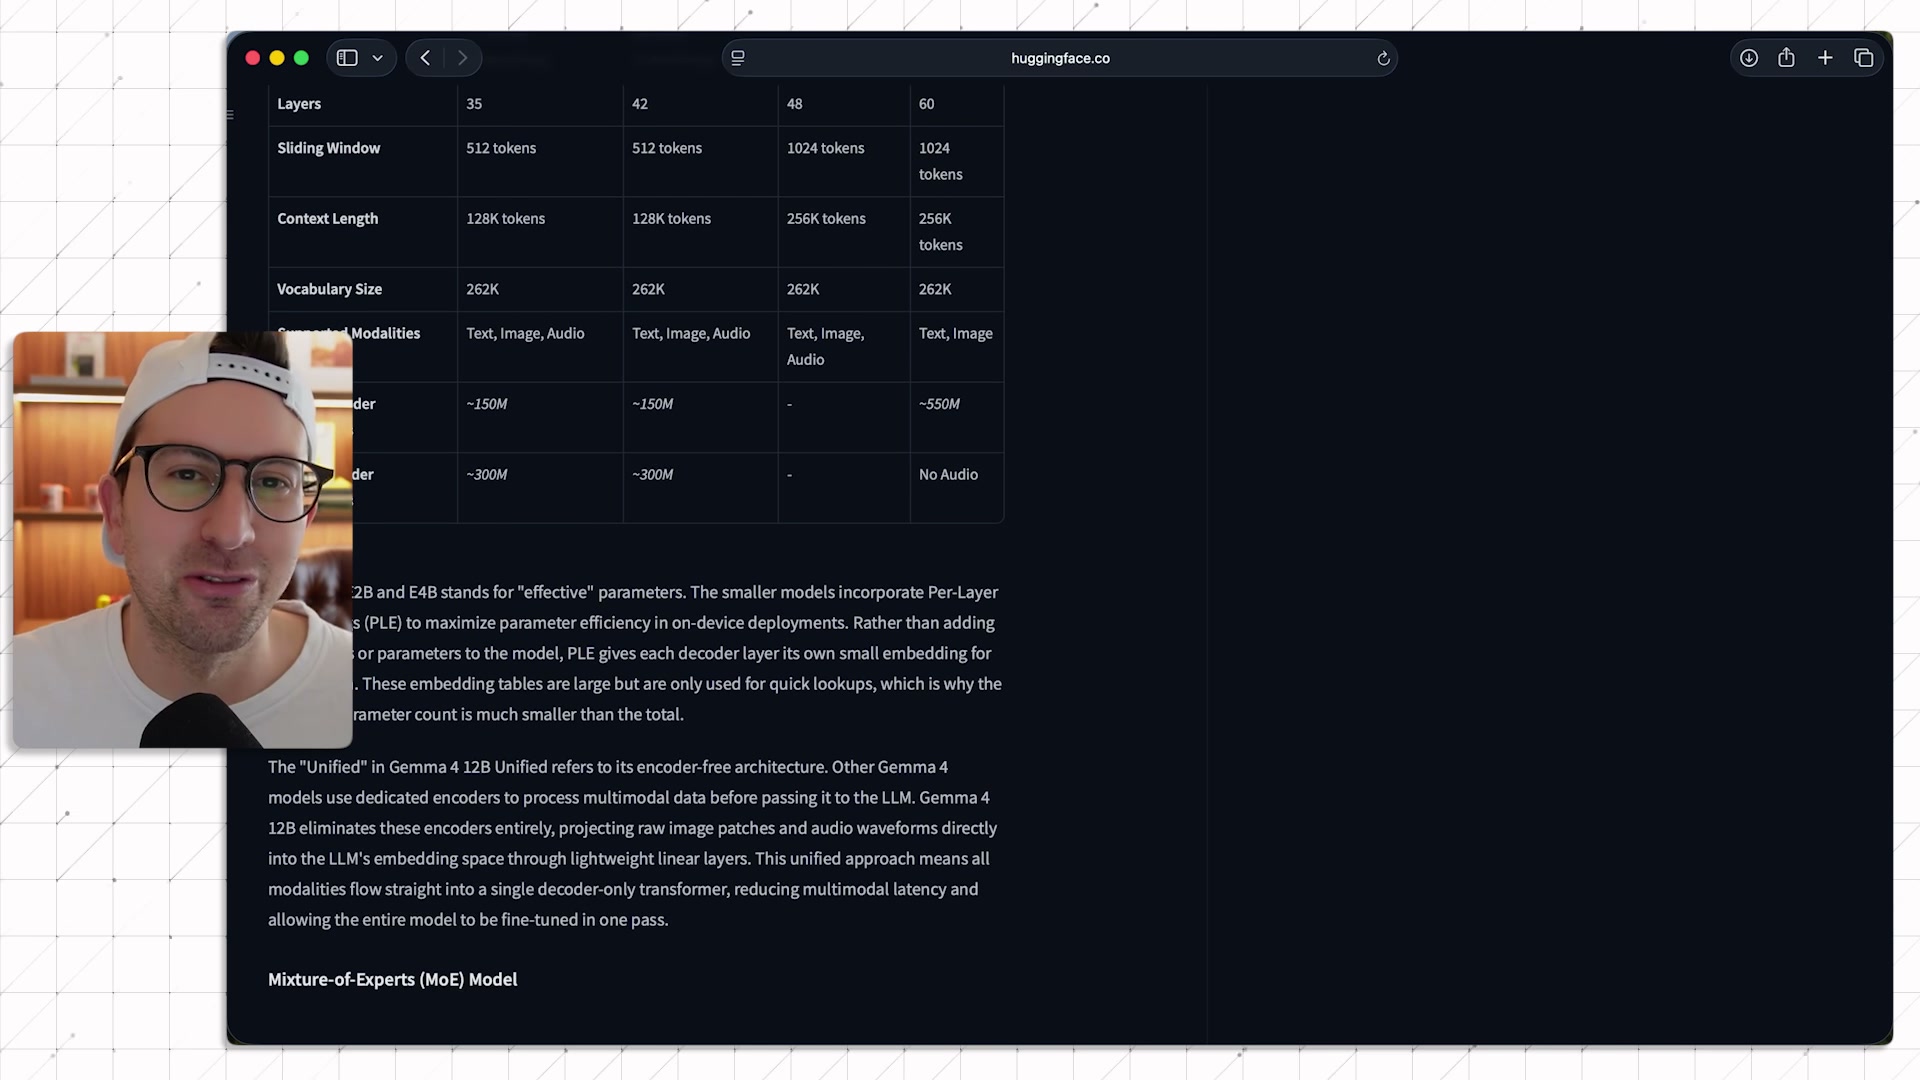
허깅페이스는 모델 창고라고 생각하면 제일 쉬워요. 거기 가면 모델 카드(model card, 모델의 용도와 조건을 적은 설명서), 라이선스, 파일 형식, 예제, 벤치마크, 커뮤니티 버전이 다 있어요. 로컬에서 돌리기 쉽게 이미 압축해 둔 버전도 있고요.
로컬 AI가 처음이라면 가장 좋은 연습은 허깅페이스에서 모델 카드 하나를 정말 천천히 읽어 보는 거예요. 배우는 게 많습니다.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
처음엔 무섭게 생긴 세부 사항의 절반은 무시해도 돼요. 이 모델은 뭘 하려고 만들었나, 크기는 얼마인가, 라이선스는 뭔가, 사람들은 어떤 하드웨어에서 돌리나, 텍스트·이미지·음성·도구 사용·임베딩 중 뭘 지원하나, 양자화한 파일이 있나. 이것만 답할 수 있으면 돼요.
Q. 모델을 돌리는 소프트웨어는요?
대부분은 LM 스튜디오나 올라마로 시작하면 됩니다. LM 스튜디오는 평범한 데스크톱 앱처럼 느껴져요. 내려받고, 모델을 검색하고, 다운로드를 누르면 바로 대화할 수 있어요. 비개발자에게는 가장 친절한 첫 경험 중 하나라고 봐요.
올라마는 조금 더 만드는 사람 쪽이에요. "ollama run gemma4:e4b" 같은 명령어를 치면 모델이 로컬에서 돌아가고, 내 앱이 말을 걸 수 있는 API까지 생깁니다.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
그 밑으로 내려가면 llama.cpp와 MLX라는 이름을 듣게 될 거예요. llama.cpp는 로컬 모델 추론의 상당 부분을 떠받치고 있고, MLX는 애플 실리콘 맥을 쓴다면 중요해요. 구글 생태계에서 진짜 온디바이스 앱을 내놓고 싶다면 구글 AI 엣지(Google AI Edge)와 LiteRT-LM이 등장합니다.
"노트북에서 모델을 돌려 봤다"에서 "이 모델을 iOS·안드로이드·웹 앱 안에 넣고 싶다"로 넘어갈 때 공부하는 게 이쪽이에요.
단어만 알면 절반은 끝나요
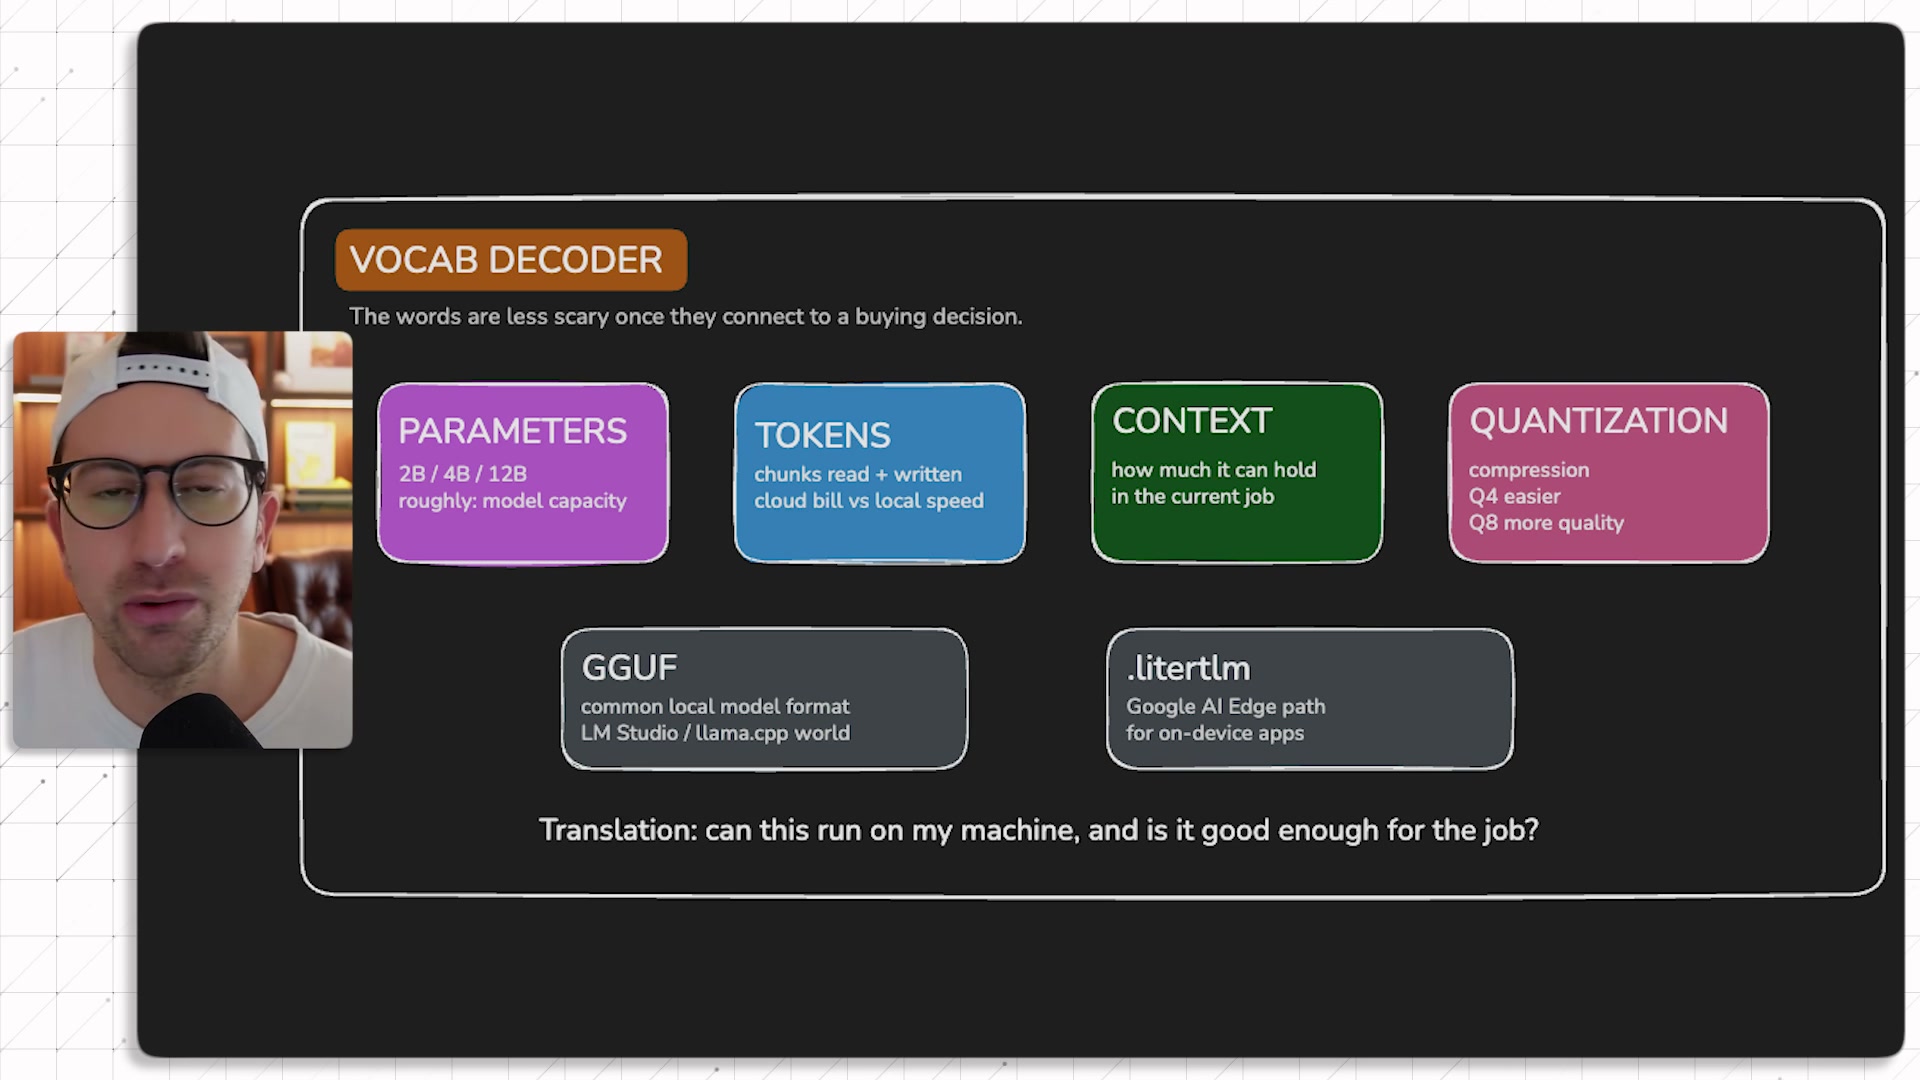
Q. 모델 이름에 붙는 2B, 4B 같은 숫자는 뭔가요?
파라미터(parameter, 모델 내부의 가중치) 수예요. 파라미터가 많을수록 보통 어려운 일을 해낼 역량이 커지지만, 그만큼 메모리를 더 먹어요. 결국 메모리, 속도, 하드웨어와의 줄다리기죠.
20억(2B)이나 40억(4B) 파라미터 모델은 휴대폰 같은 엣지 기기, 빠른 워크플로, 작은 작업에 써요. 120억(12B)은 중간 지대고, 260억이나 310억(26B, 31B)부터는 워크스테이션 영역에 들어갑니다.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
그렇다고 지금 5천, 1만, 2만 달러(약 700만, 1,400만, 2,800만 원)짜리 워크스테이션을 사러 가지는 마세요. 이번 에피소드가 끝날 즈음이면 휴대폰이나 2021년에 산 남는 노트북으로도 충분히 시작할 수 있다는 걸 알게 될 거예요.
Q. 토큰, 컨텍스트 윈도우, 양자화도 자주 보여요.
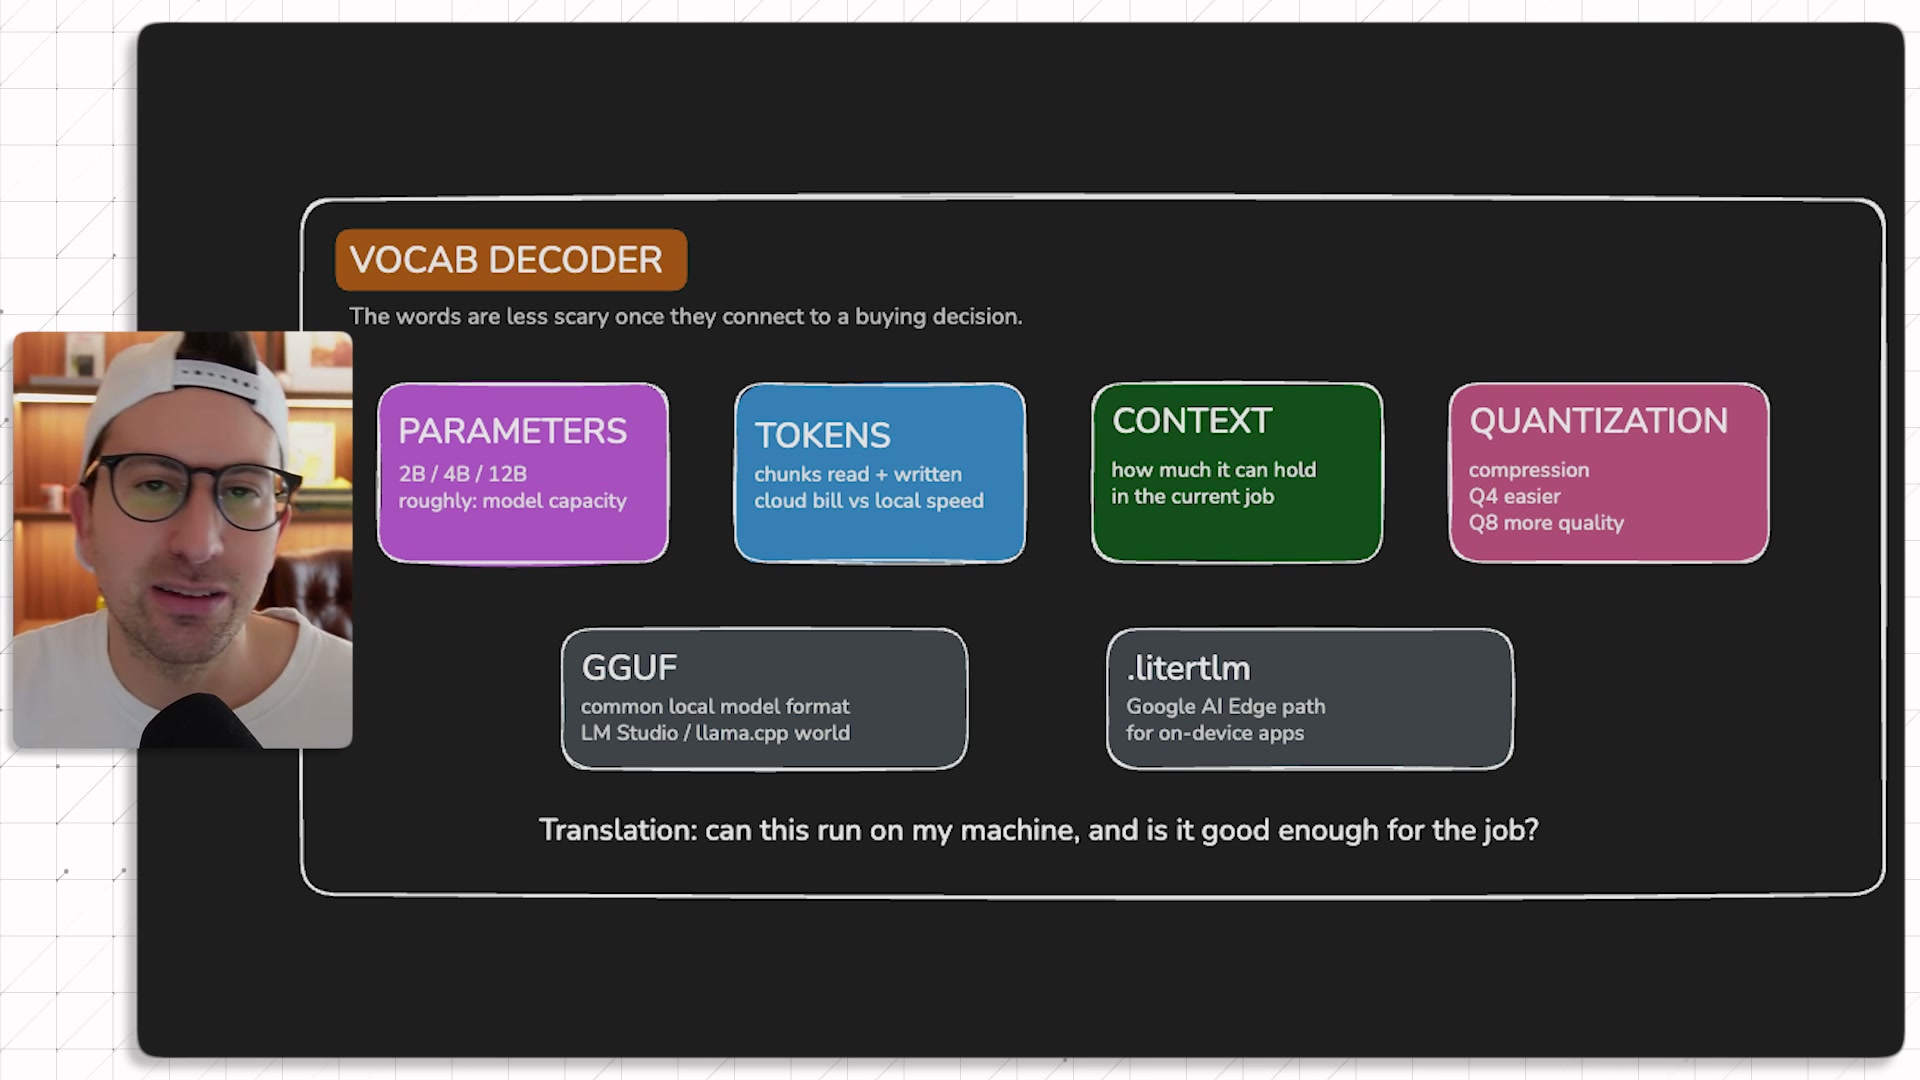
토큰은 모델이 읽고 쓰는 텍스트 조각이에요. 로컬에서는 토큰당 요금이 아니라 속도와 메모리를 신경 쓰게 돼요. 컨텍스트 윈도우(context window)는 모델이 한 번에 다룰 수 있는 정보의 양이고요.
양자화(quantization)는 이름이 실제보다 훨씬 어렵게 들려요. 솔직히 저도 발음이 잘 안 돼요. 쉽게 말하면 모델 압축이에요. 거대한 모델을 평범한 노트북에 들어가게 해 주죠. 품질이 조금 떨어질 수는 있지만 갑자기 마법처럼 돌아갑니다.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
Q4, Q8 같은 표기를 보게 될 텐데, 초보자 규칙은 이래요. Q4는 돌리기 쉽고, Q8은 품질을 더 지키는 대신 메모리가 더 필요해요. 이제 막 시작한다면 Q4면 충분합니다.
Q. GGUF는요?
GGUF는 로컬 모델에서 흔히 쓰는 파일 형식이에요. 구글 AI 엣지 쪽에서는 LiteRT-LM 형식을 보게 되는데, 온디바이스 앱을 만들 때 신경 쓰는 모델 형식이자 실행 경로예요.
정리하면 지도는 간단해요. 허깅페이스는 모델을 찾고 이해하게 도와주고, 젬마는 구글의 오픈 모델 패밀리예요. LM 스튜디오는 마찰 없이 모델을 써 보게 해 주고, 올라마는 조금 더 기술적인 사람이 앱에 꽂아 쓰게 해 줘요.
GGUF는 흔한 로컬 모델 형식이고, 구글 AI 엣지와 LiteRT-LM은 온디바이스 AI 제품을 내놓는 길이에요. 저는 제 사업을 구글 위에서 돌리고 있어서 젬마부터 보는 게 자연스러웠어요.
첫날은 젬마 4 E4B 하나면 됩니다
Q. 구글 젬마는 종류가 많던데, 뭘 골라야 하나요?
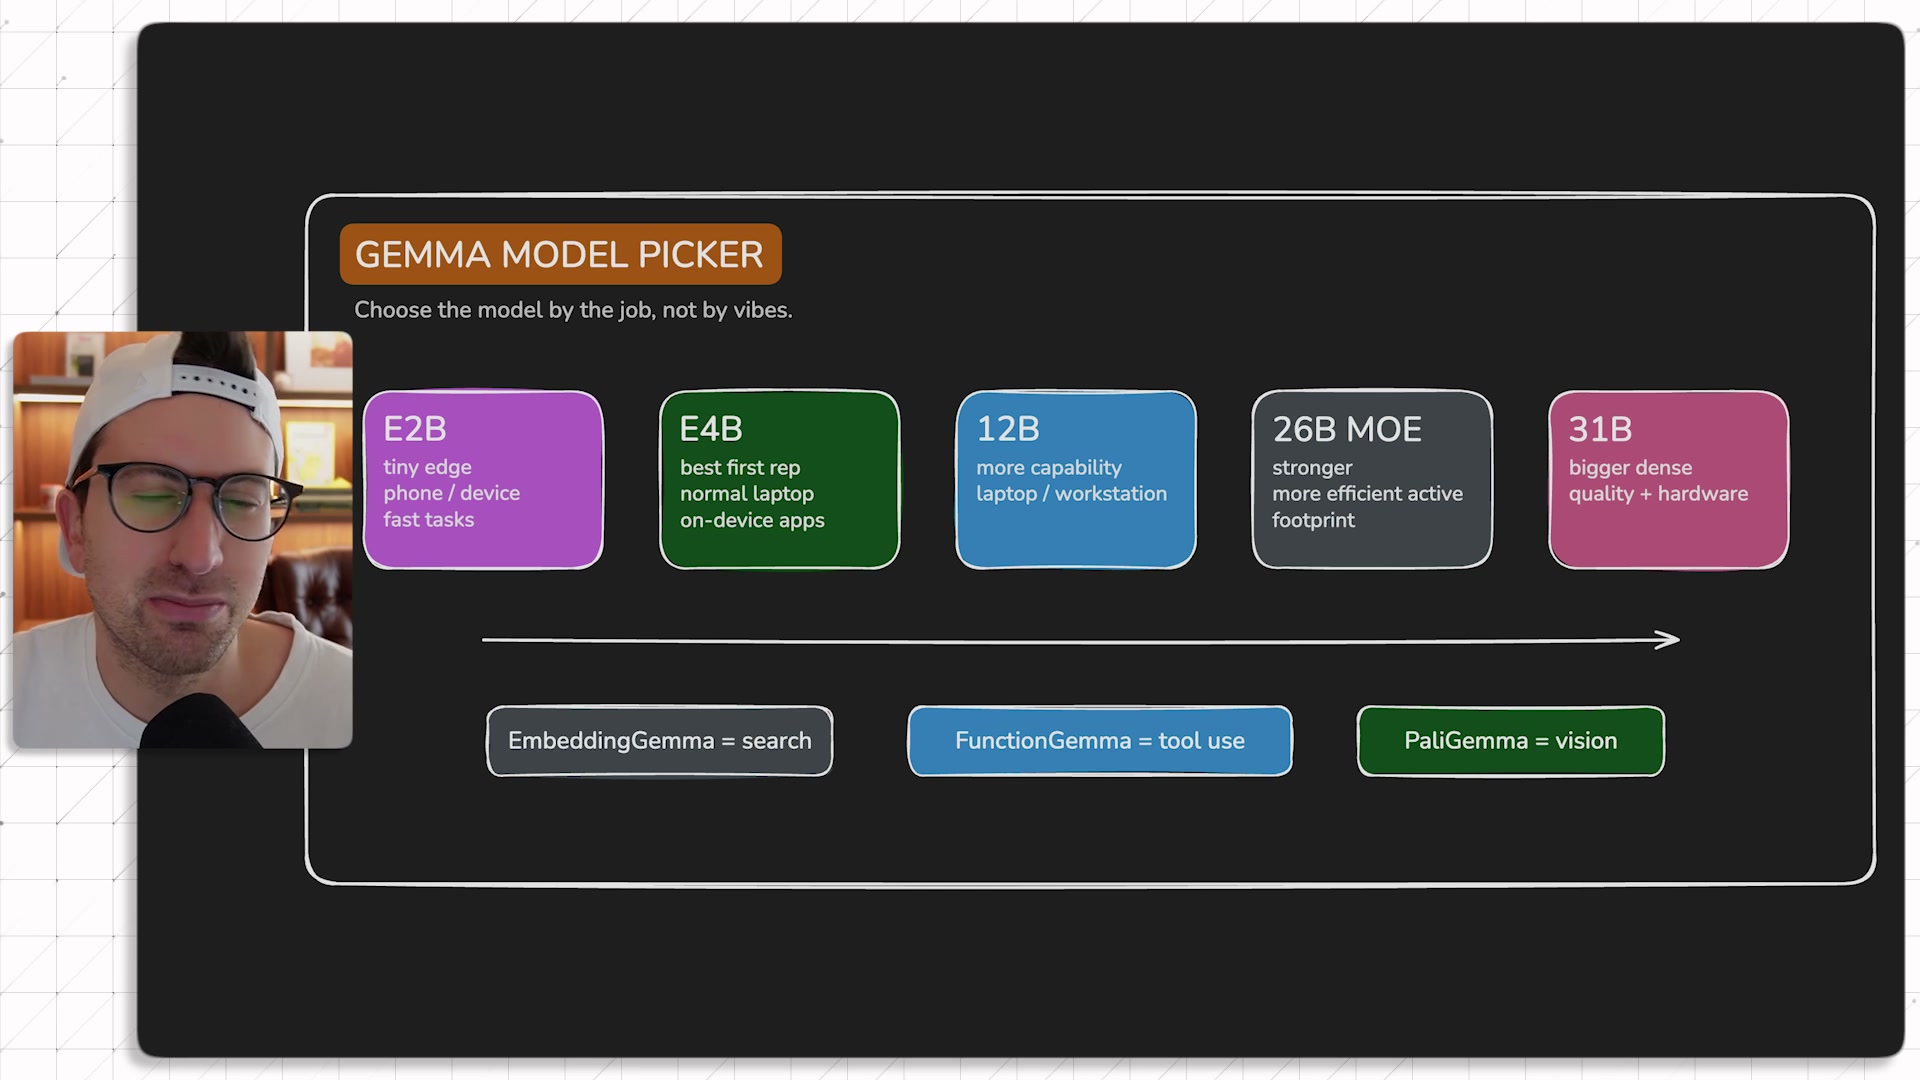
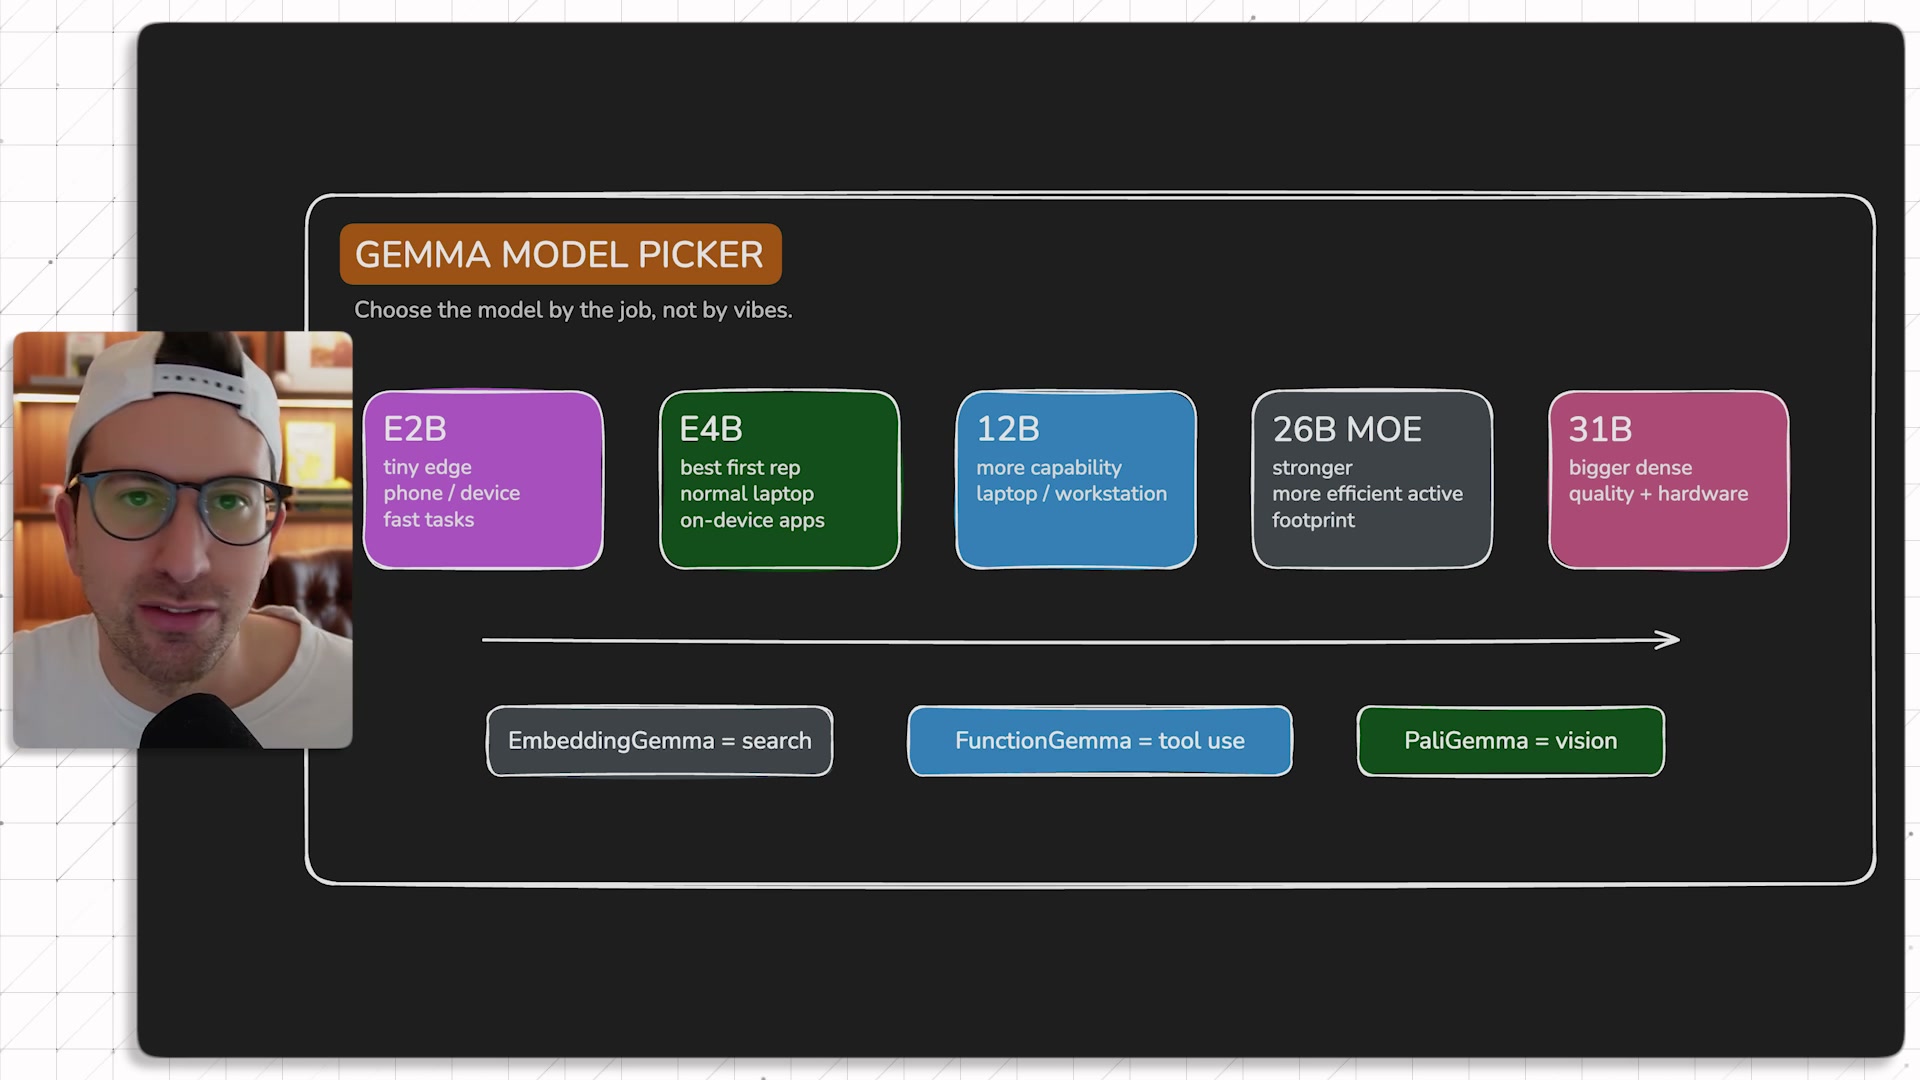
젬마 4는 효율적인 로컬·온디바이스 사용을 위해 만든 모델이에요. 가장 작은 E2B는 휴대폰 워크플로용 엣지 모델이고, 그보다 큰 E4B가 대부분의 로컬 작업에서 가장 현실적인 출발점이에요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
12B는 노트북에서 역량을 좀 더 끌어올린 중간 지대고, 26B와 31B는 더 강한 워크스테이션 영역이에요. 이게 기본 모델 선택지입니다.
Q. 특화 모델도 있다고요?
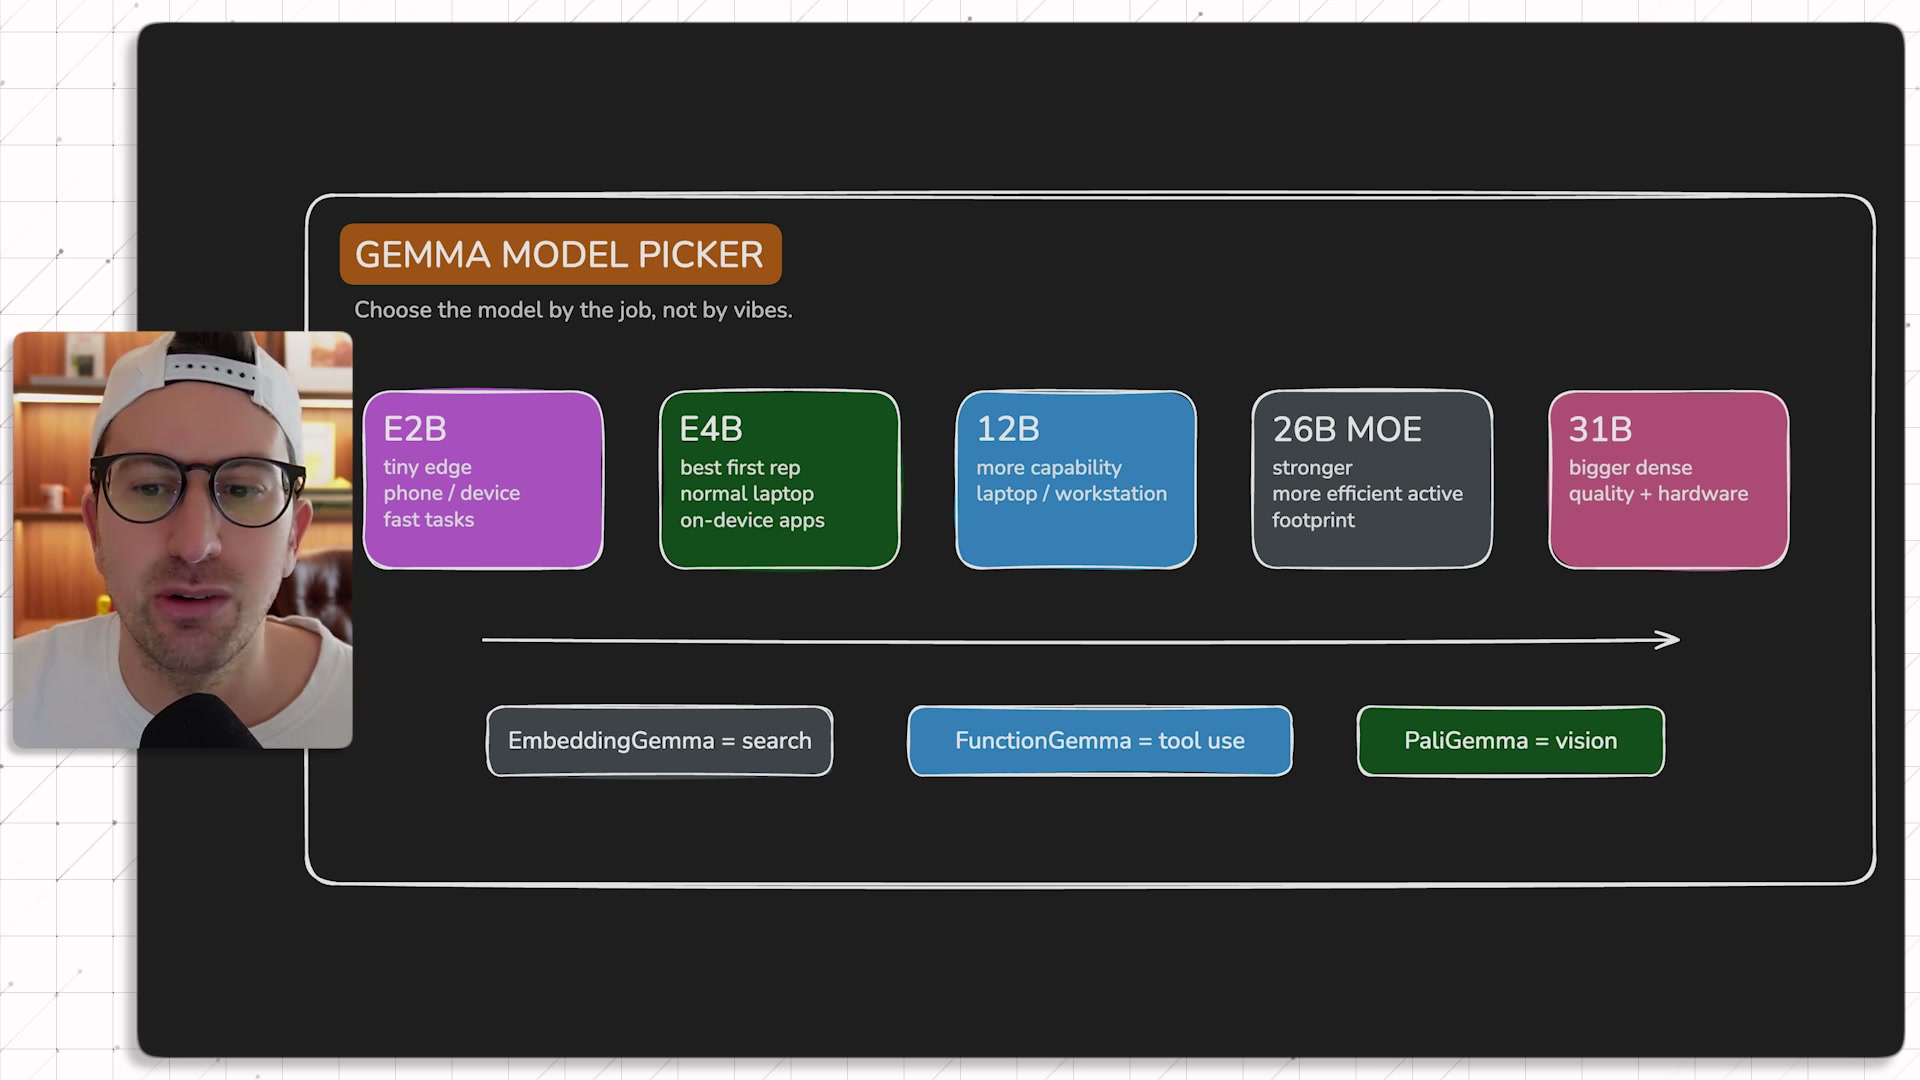
네, 많은 분들이 모르는데 알아 두면 정말 쓸모 있어요. 임베딩젬마(EmbeddingGemma)는 검색용이에요. 텍스트를 임베딩(embedding, 뜻을 숫자로 바꾼 것)으로 바꿔서 단어가 아니라 의미로 찾게 해 줘요. 내 문서, 고객 메모, 지원 티켓, 영업 통화를 검색하고 싶다면 임베딩이 아주 중요해요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
펑션젬마(FunctionGemma)는 도구 사용과 구조화된 함수 호출을 맡아요. "모델이 답을 줬다"에서 "모델이 제품의 다음 단계를 도왔다"로 넘어가는 길목이죠. 시각용 팔리젬마(PaliGemma), 안전용 실드젬마(ShieldGemma)도 있어요.
Q. 결국 전부 로컬로 가는 건가요?
아니요. 크고 진지한 제품은 대부분 하이브리드로 갈 거예요. 구글 생태계로 보면 젬마가 오픈 모델, 구글 AI 엣지가 온디바이스 개발 생태계, LiteRT-LM이 여러 기기에서 언어 모델을 돌리는 런타임이에요. AI 엣지 갤러리(AI Edge Gallery)로 온디바이스 모델을 직접 체험해 볼 수 있고요. 거대한 규모나 최상위 추론이 필요하면 여전히 제미나이(Gemini)와 구글 클라우드, 또는 다른 프런티어 모델을 쓰면 돼요.
예를 들어 볼게요. 전문 서비스 회사를 위한 로컬 AI 도구가 있다고 해 봅시다. 로컬 모델이 민감한 초안을 읽고 문제를 찾아요. 개인 정보는 지우거나 요약해서 문제만 깔끔하게 정리하죠. 고객이 더 깊은 추론을 원하면 그때 클라우드 모델이 그 정리된 버전을 가지고 도와요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
로컬이 개인 파일을 먼저 훑고, 무거운 생각은 필요할 때만 클라우드가 하고, 중요한 건 나가기 전에 사람이 승인하는 구조예요. 전부 클라우드에 올리는 것보다 훨씬 자연스럽고, 사실 많은 사람이 전부 올리는 걸 원하지 않거든요. 요즘 제가 제품을 생각하는 방식이 이래요.
Q. 젬마 말고 다른 오픈 모델은 어떤가요?
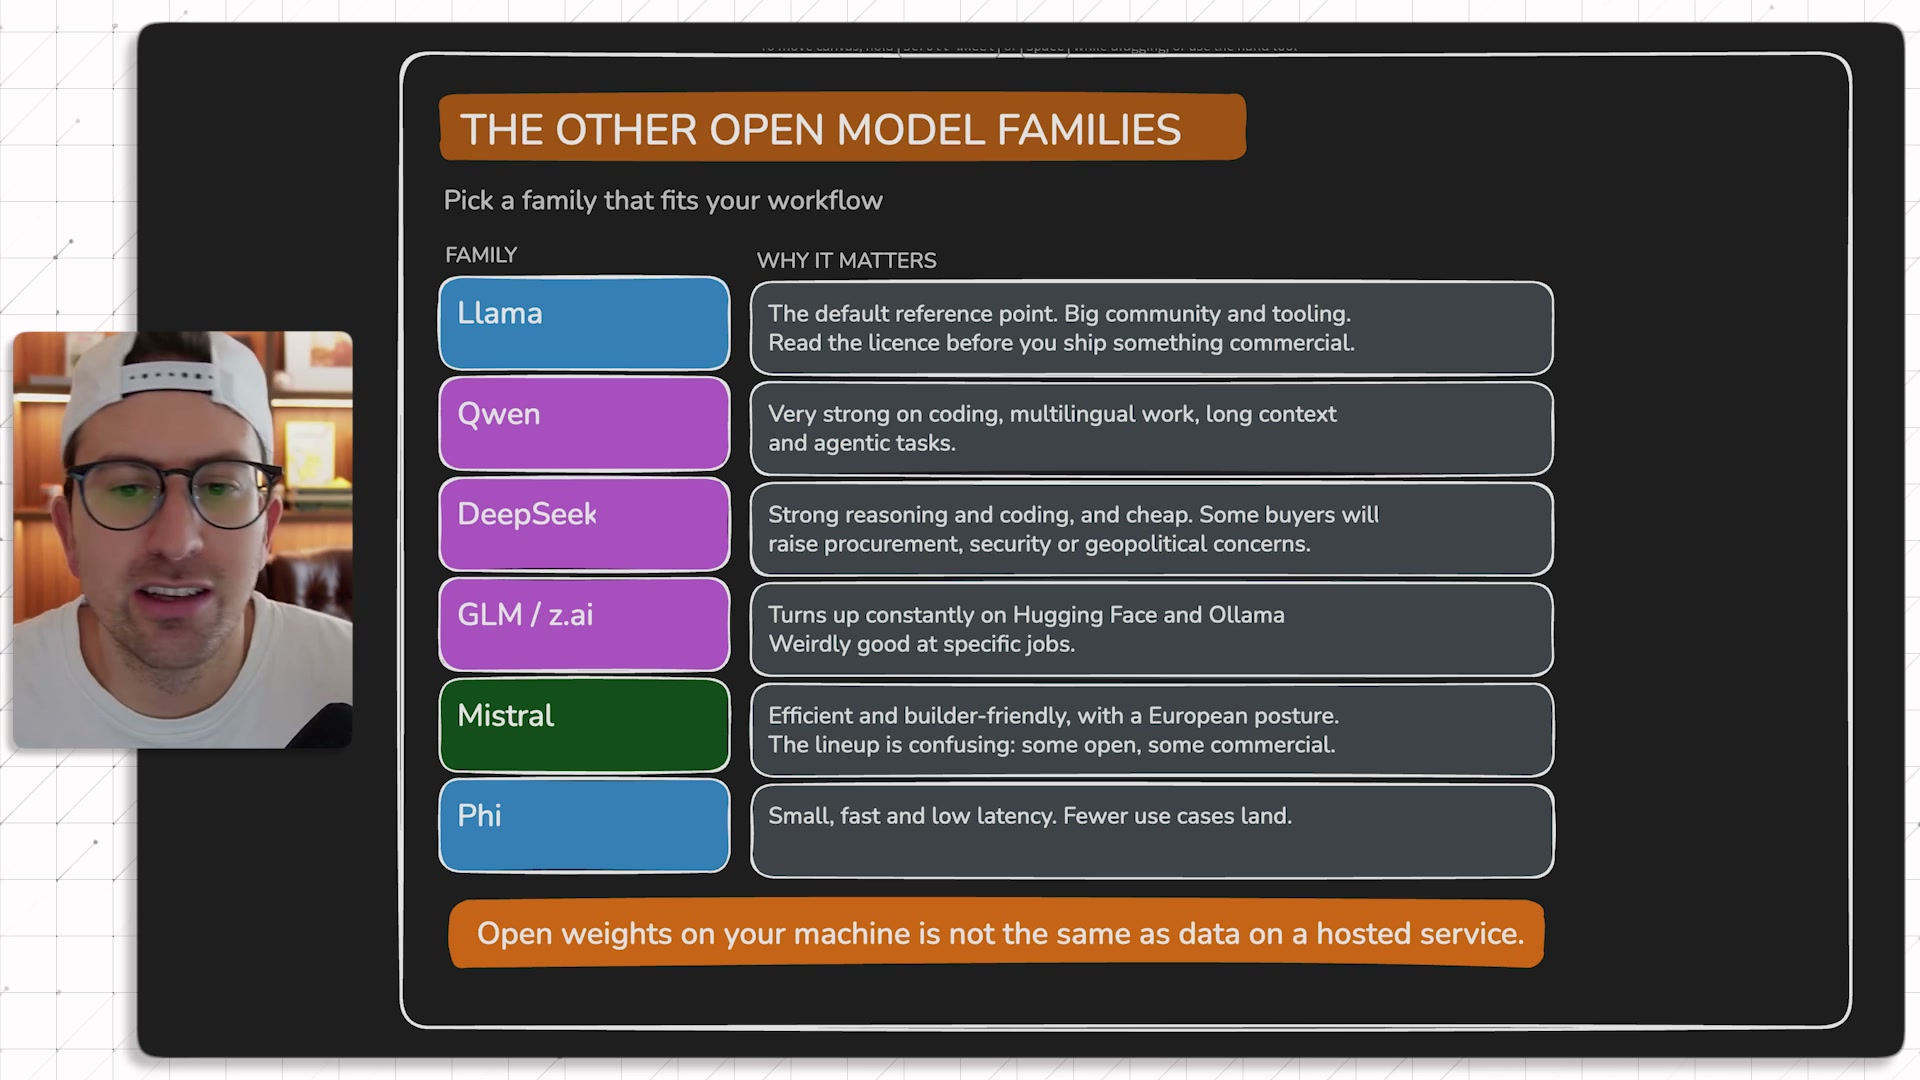
메타의 라마는 생태계가 커서 많은 개발자에게 기본 기준점이에요. 커뮤니티, 도구, 예제가 장점이죠. 다만 진지한 상업 제품을 만든다면 라이선스와 모델 카드는 꼭 읽어야 해요.
알리바바의 큐원(Qwen)은 코딩, 다국어, 긴 컨텍스트, 에이전트 작업에서 아주 강해졌어요. 그런데 중국 이슈는 실재해요. 민감한 데이터를 다루는 곳이라면 오픈 가중치를 내 컴퓨터에서 돌리는 것과 데이터를 외부 호스팅 서비스로 보내는 걸 분리해서 봐야 해요. 회사가 어디까지 괜찮은지도 확인해야 하고요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
딥시크(DeepSeek)도 추론과 코딩에서 성능 대비 가격이 좋지만, 보안이나 지정학적 이유로 꺼리는 고객이 있어요. GLM(Z.ai)도 허깅페이스나 올라마에서 자주 보일 텐데, 뻔한 브랜드가 아니라고 무시하지 말고 직접 테스트해 보세요.
프랑스 기반의 미스트랄은 오픈 모델과 상업용 모델이 섞여 있어 라인업이 좀 헷갈리고, 마이크로소프트의 파이(Phi)는 작고 빠르지만 저는 많은 용도에서 잘 되는 걸 못 봤어요.
다 외울 필요는 없어요. 창업자로서 할 일은 여러 개를 가지고 놀아 보고, 내 워크플로에 맞고 그 회사의 방식이 마음에 드는 모델 패밀리 하나를 고르는 거예요.
오늘 바로 돌려 보는 세 가지 길
Q. 직접 돌려 보려면 어디서부터 시작하나요?
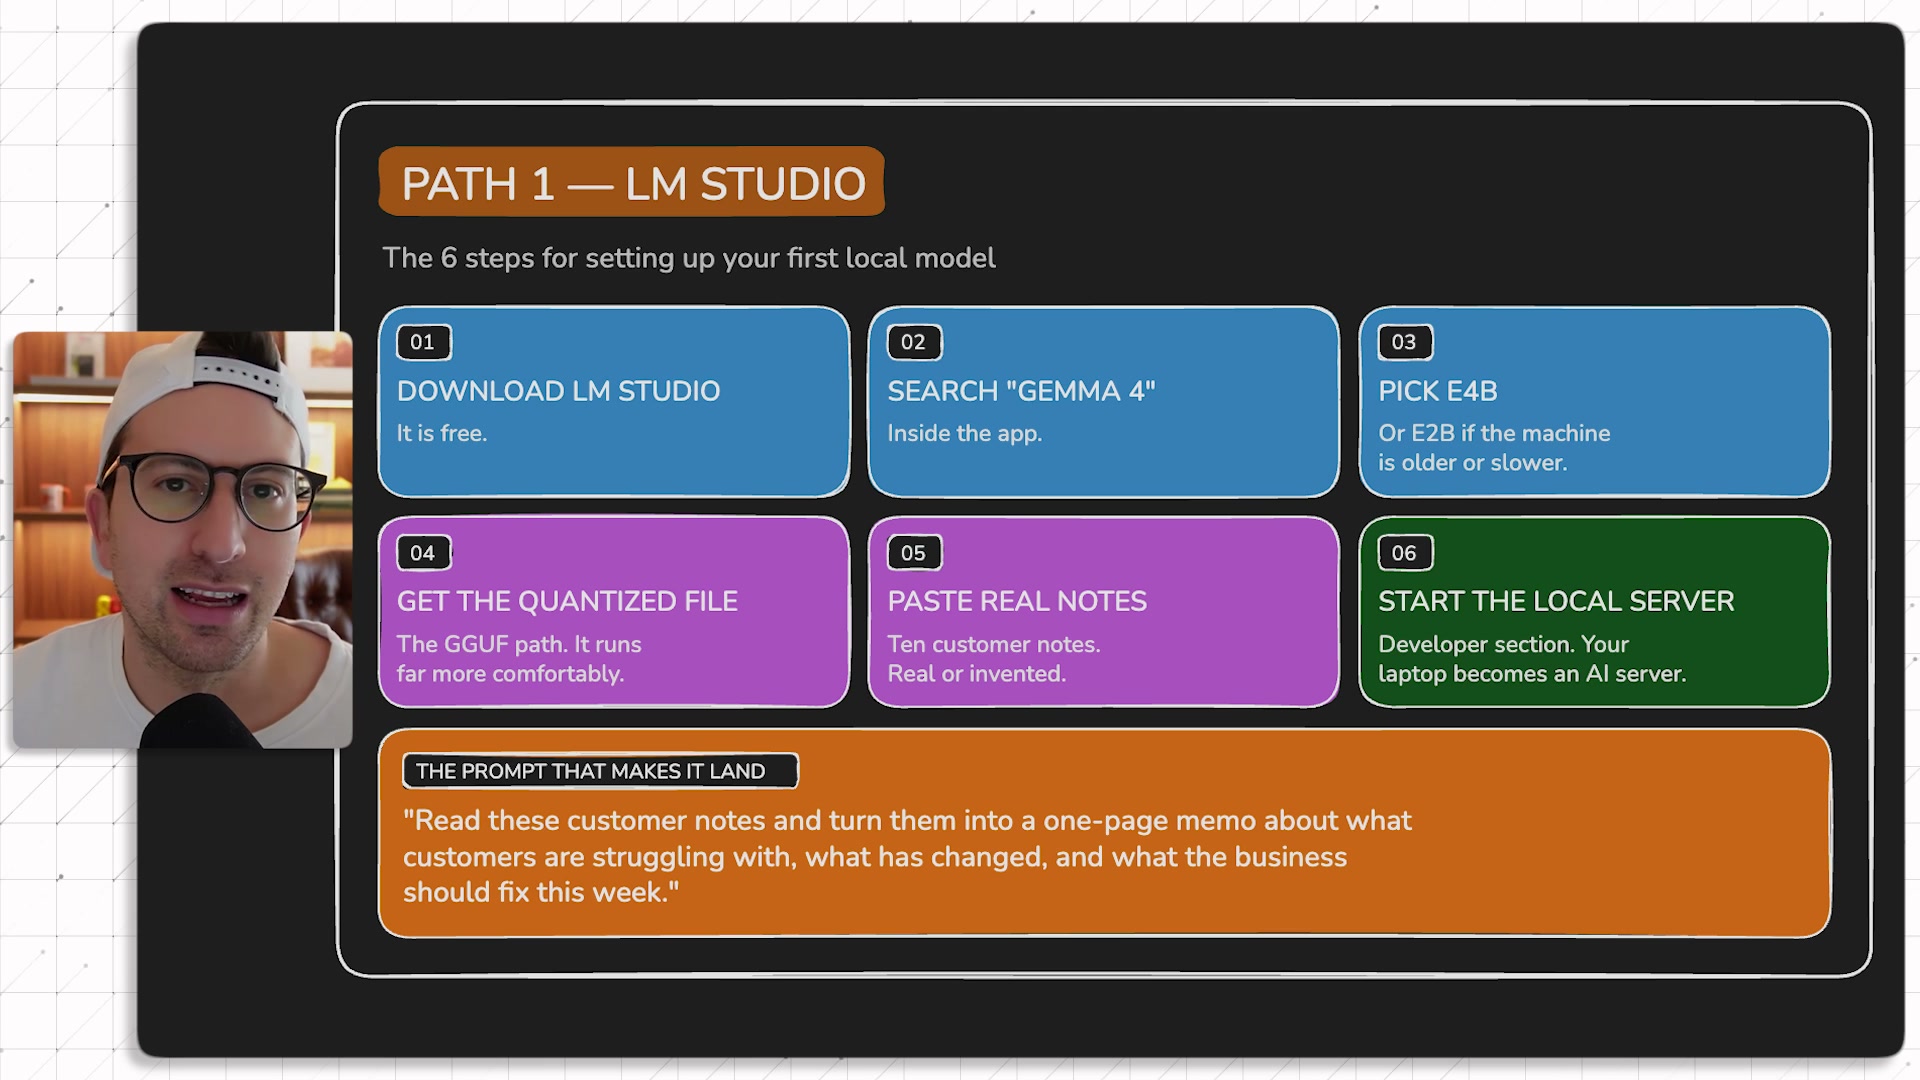
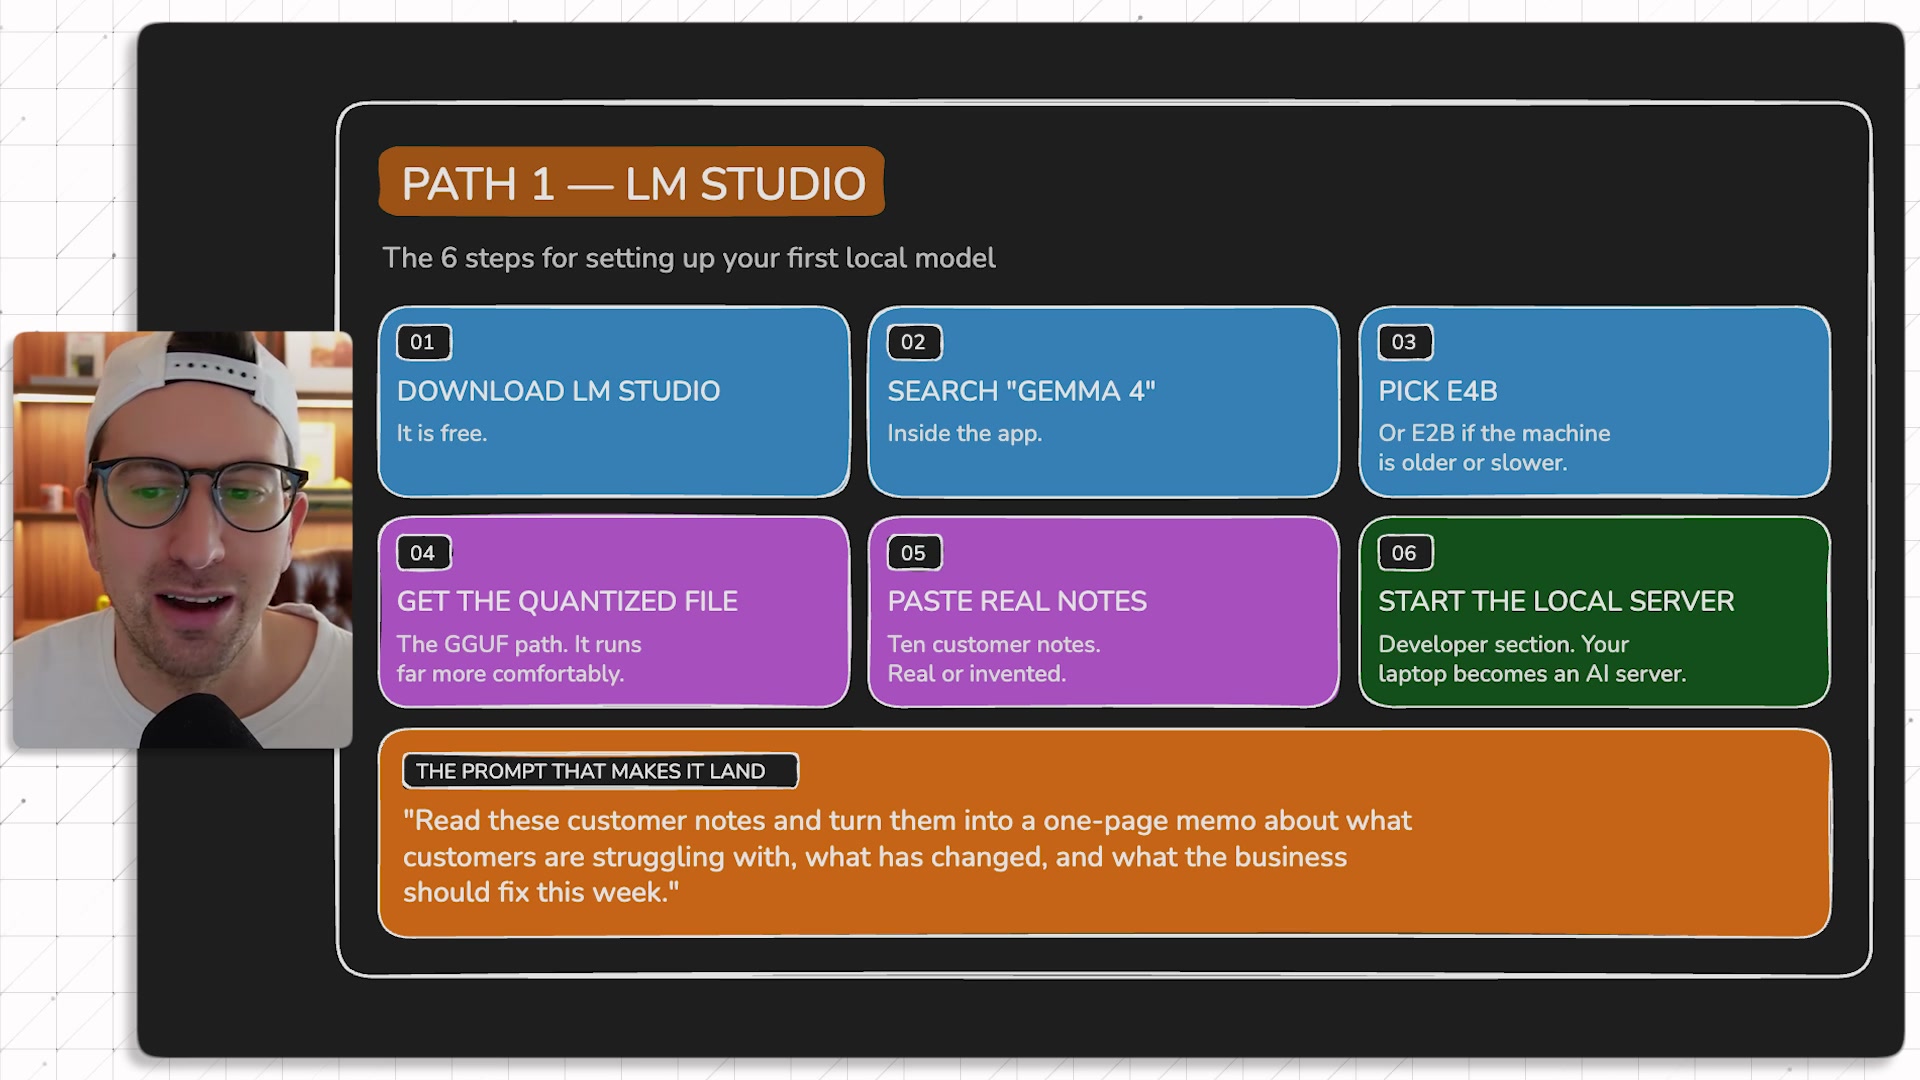
저라면 LM 스튜디오부터 시작해요. 무료로 내려받아서 앱을 열고 "Gemma 4"를 검색하세요. 컴퓨터가 튼튼하면 E4B를, 느리거나 오래됐으면 E2B를 고르세요. GGUF로 받는다면 양자화 버전을 고르는 게 좋아요. 훨씬 편하게 돌아가거든요.
다운로드가 끝나면 채팅을 열고 간단한 걸 물어보세요. 저는 바로 가치가 느껴지게 사업 관련 프롬프트를 권해요. "이 고객 메모를 읽고, 고객이 뭘 힘들어하는지, 뭐가 바뀌었는지, 이번 주에 뭘 고쳐야 하는지 한 페이지 메모로 정리해 줘." 그리고 고객 메모를 붙여 넣는 거예요. 가짜 메모라도 괜찮아요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
핵심은 모델이 지금 내 컴퓨터에서 돌고 있고, 프롬프트를 클라우드로 보내지 않고도 AI를 쓰고 있다는 거예요. 모두가 한 번은 이 느낌을 겪어 봤으면 해요. 머리가 완전히 새로운 방식으로 열리거든요.
Q. 그다음 단계는요?
LM 스튜디오의 개발자 섹션에 가서 로컬 서버를 켜세요. 여기서부터 훨씬 재밌어져요. 다른 앱이 내 노트북 속 모델에게 말을 걸 수 있게 되거든요. 내 컴퓨터가 작은 AI 서버가 되는 거죠.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
스크립트든 프로토타입이든 내부 도구든 localhost로 모델을 부르면 답이 돌아와요. 이걸 보는 순간 요즘 제품들이 어떻게 만들어질지가 보이기 시작해요.
Q. 두 번째, 세 번째 길은요?
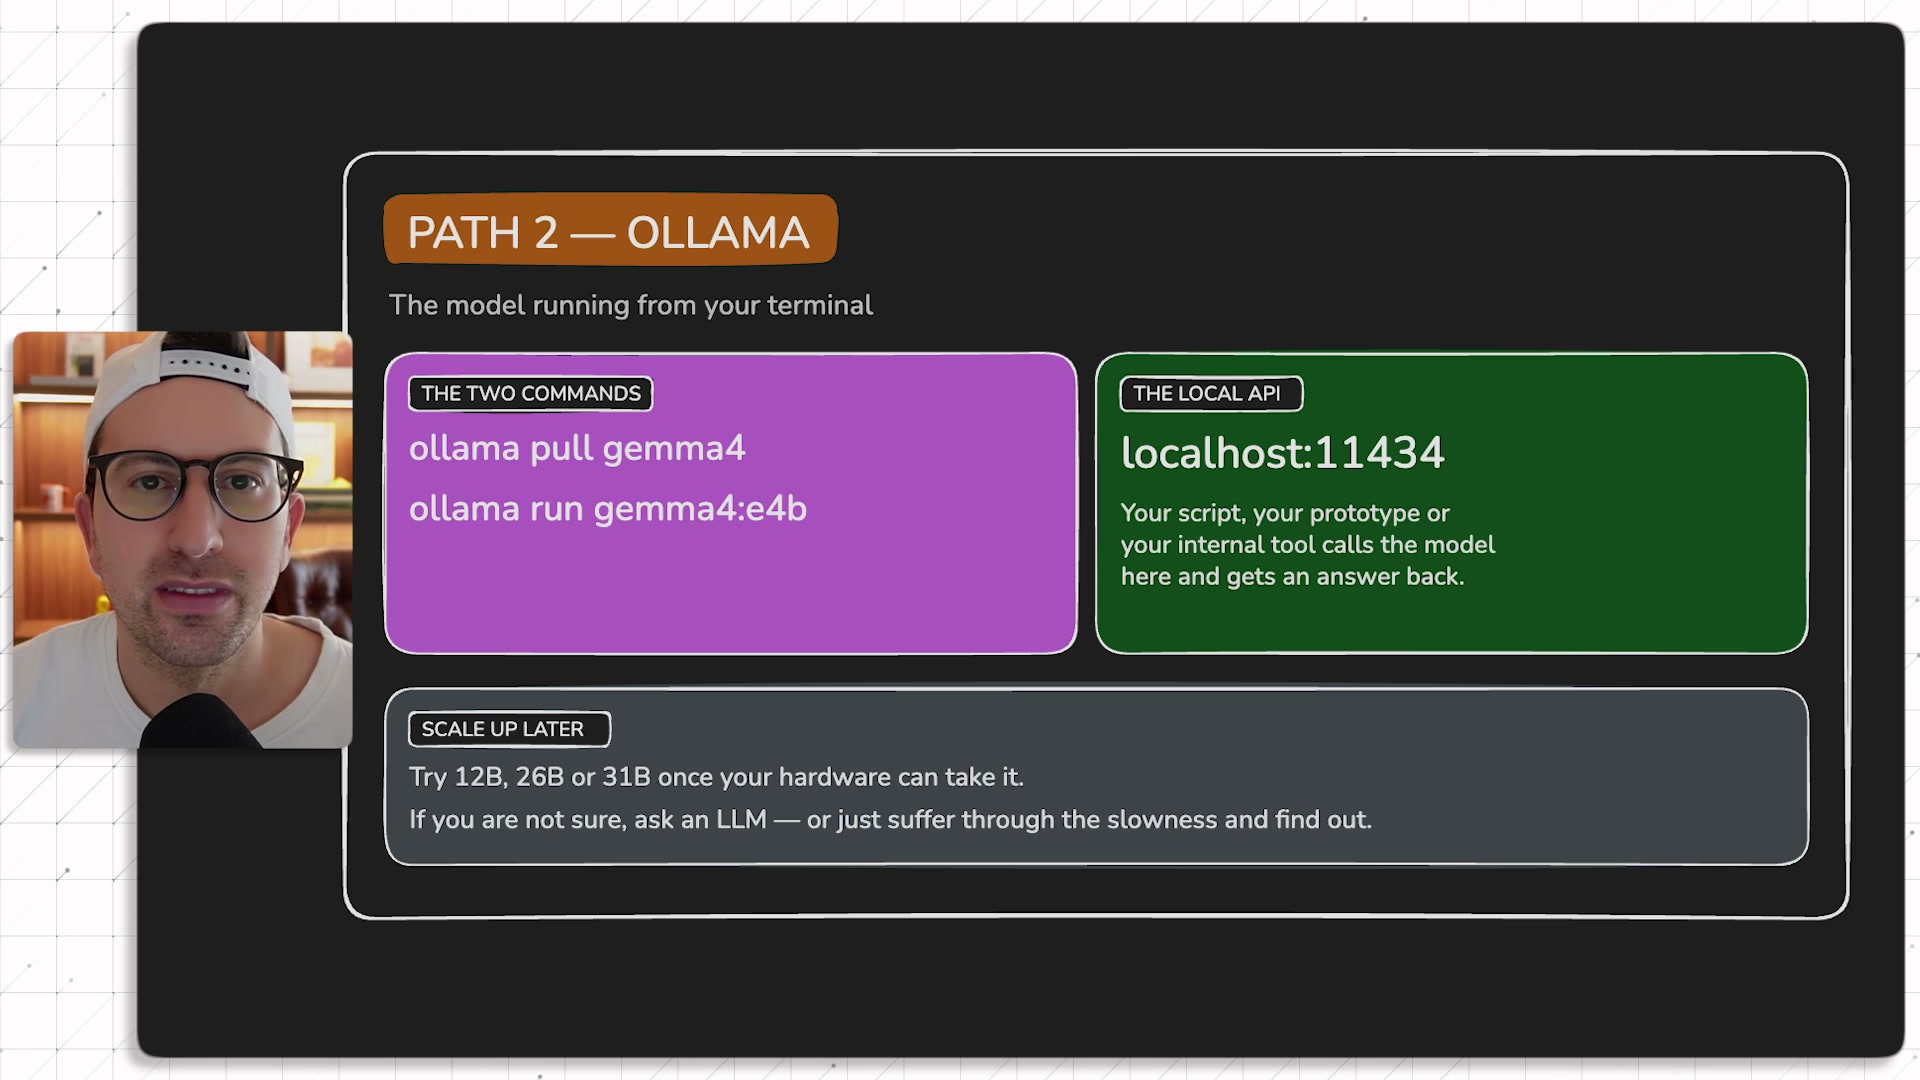
두 번째는 올라마예요. 올라마를 설치하고 "ollama pull gemma4", 이어서 "ollama run gemma4:e4b"를 실행하면 명령줄에서 젬마가 돌아가요. 올라마는 11434번 포트로 로컬 API도 열어 줘서 내 앱이나 스크립트를 붙일 수 있어요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
세 번째는 구글 AI 엣지와 LiteRT-LM인데, 실제로 모델을 품은 앱을 만들 때만 가는 길이에요. LiteRT-LM은 안드로이드, iOS, 웹, 데스크톱, 엣지 환경을 위해 설계됐어요. 데모로서의 로컬 AI에서 제품으로서의 로컬 AI로 가는 길이죠.
Q. 하드웨어는 어느 정도 있어야 하나요?
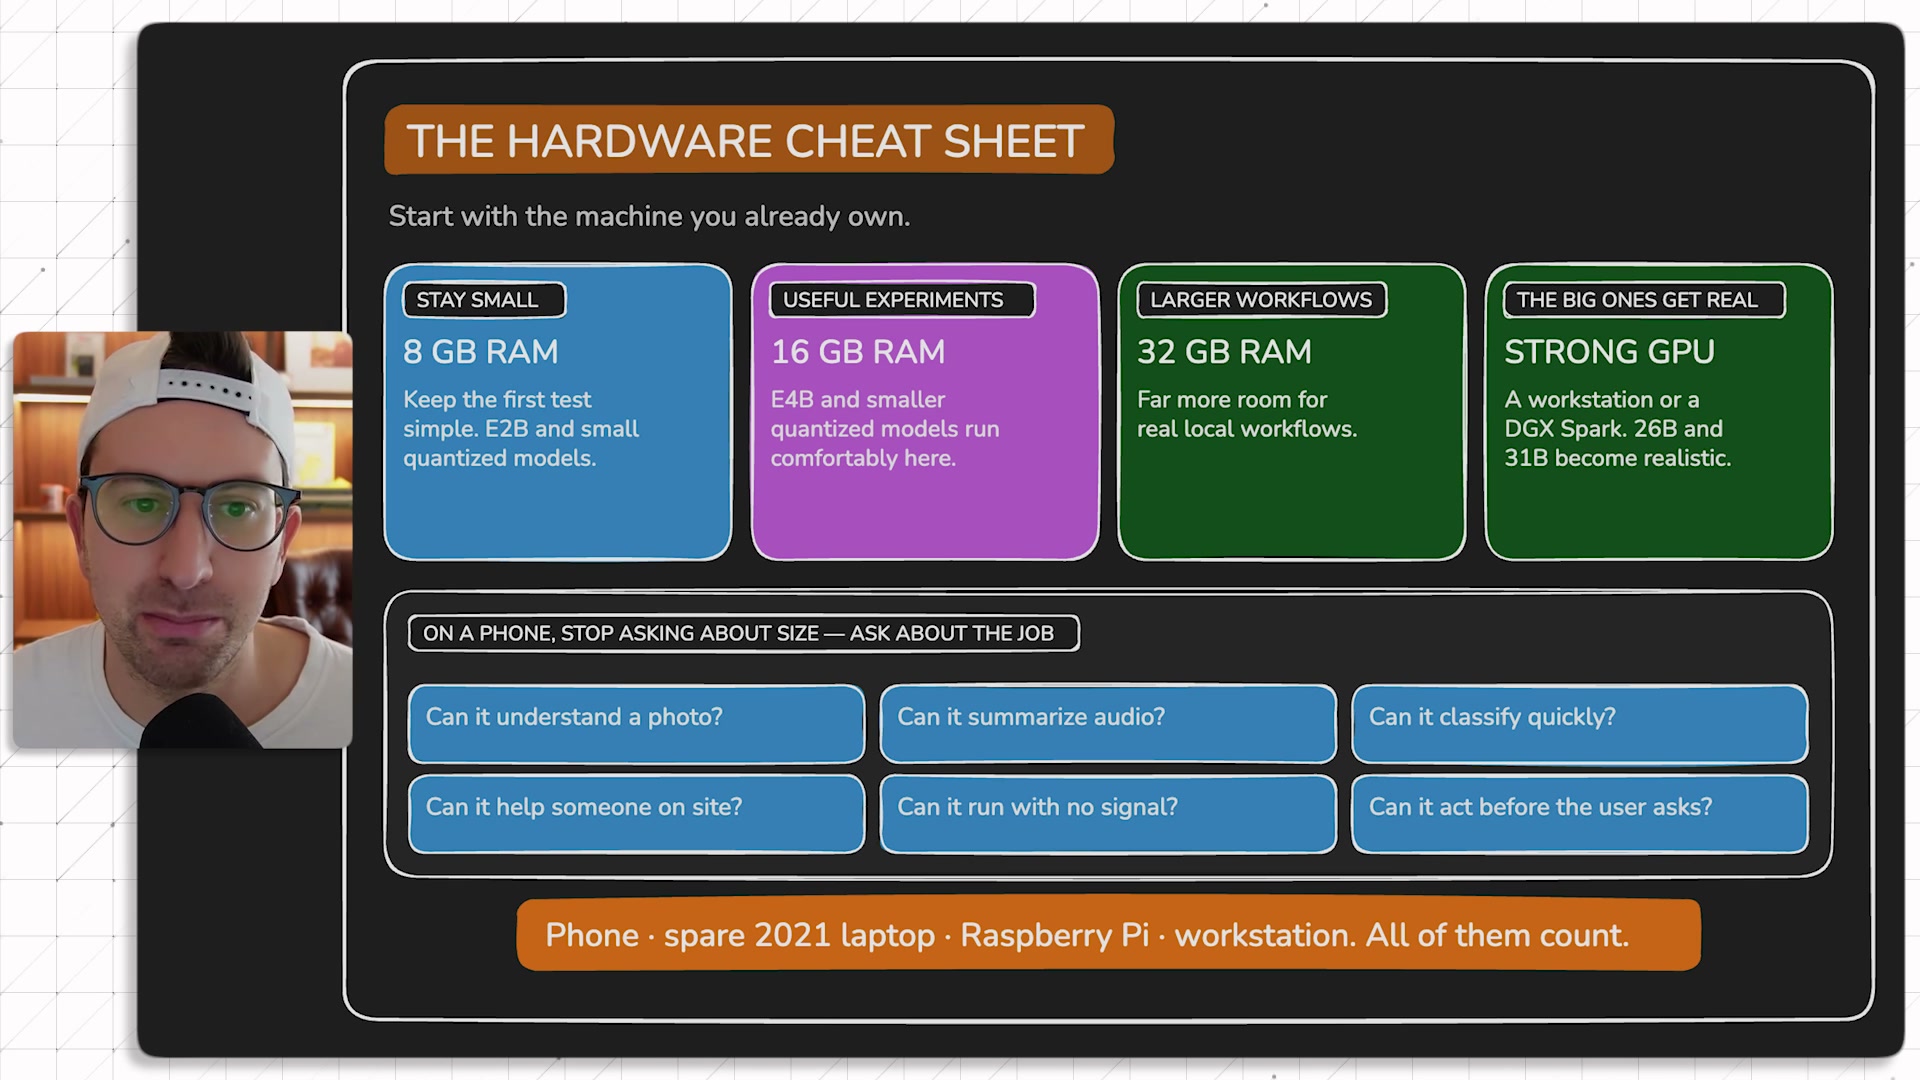
RAM이 8GB면 작게, 첫 테스트는 단순하게 가세요. 16GB면 E4B나 작은 양자화 모델로 쓸 만한 실험을 할 수 있어요. 32GB면 더 큰 로컬 워크플로를 돌릴 여유가 생기고, 강한 GPU나 DGX Spark 같은 워크스테이션이 있으면 큰 모델도 현실적이 돼요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
휴대폰이라면 모델 크기보다 할 일을 생각하세요. 사진을 이해하나, 음성을 요약하나, 현장 작업자를 돕나, 연결이 약해도 돌아가나를 보는 거예요.
폴더 하나, 모델 하나, 결과물 하나
Q. 첫 워크플로로 뭘 만들어 보면 좋을까요?
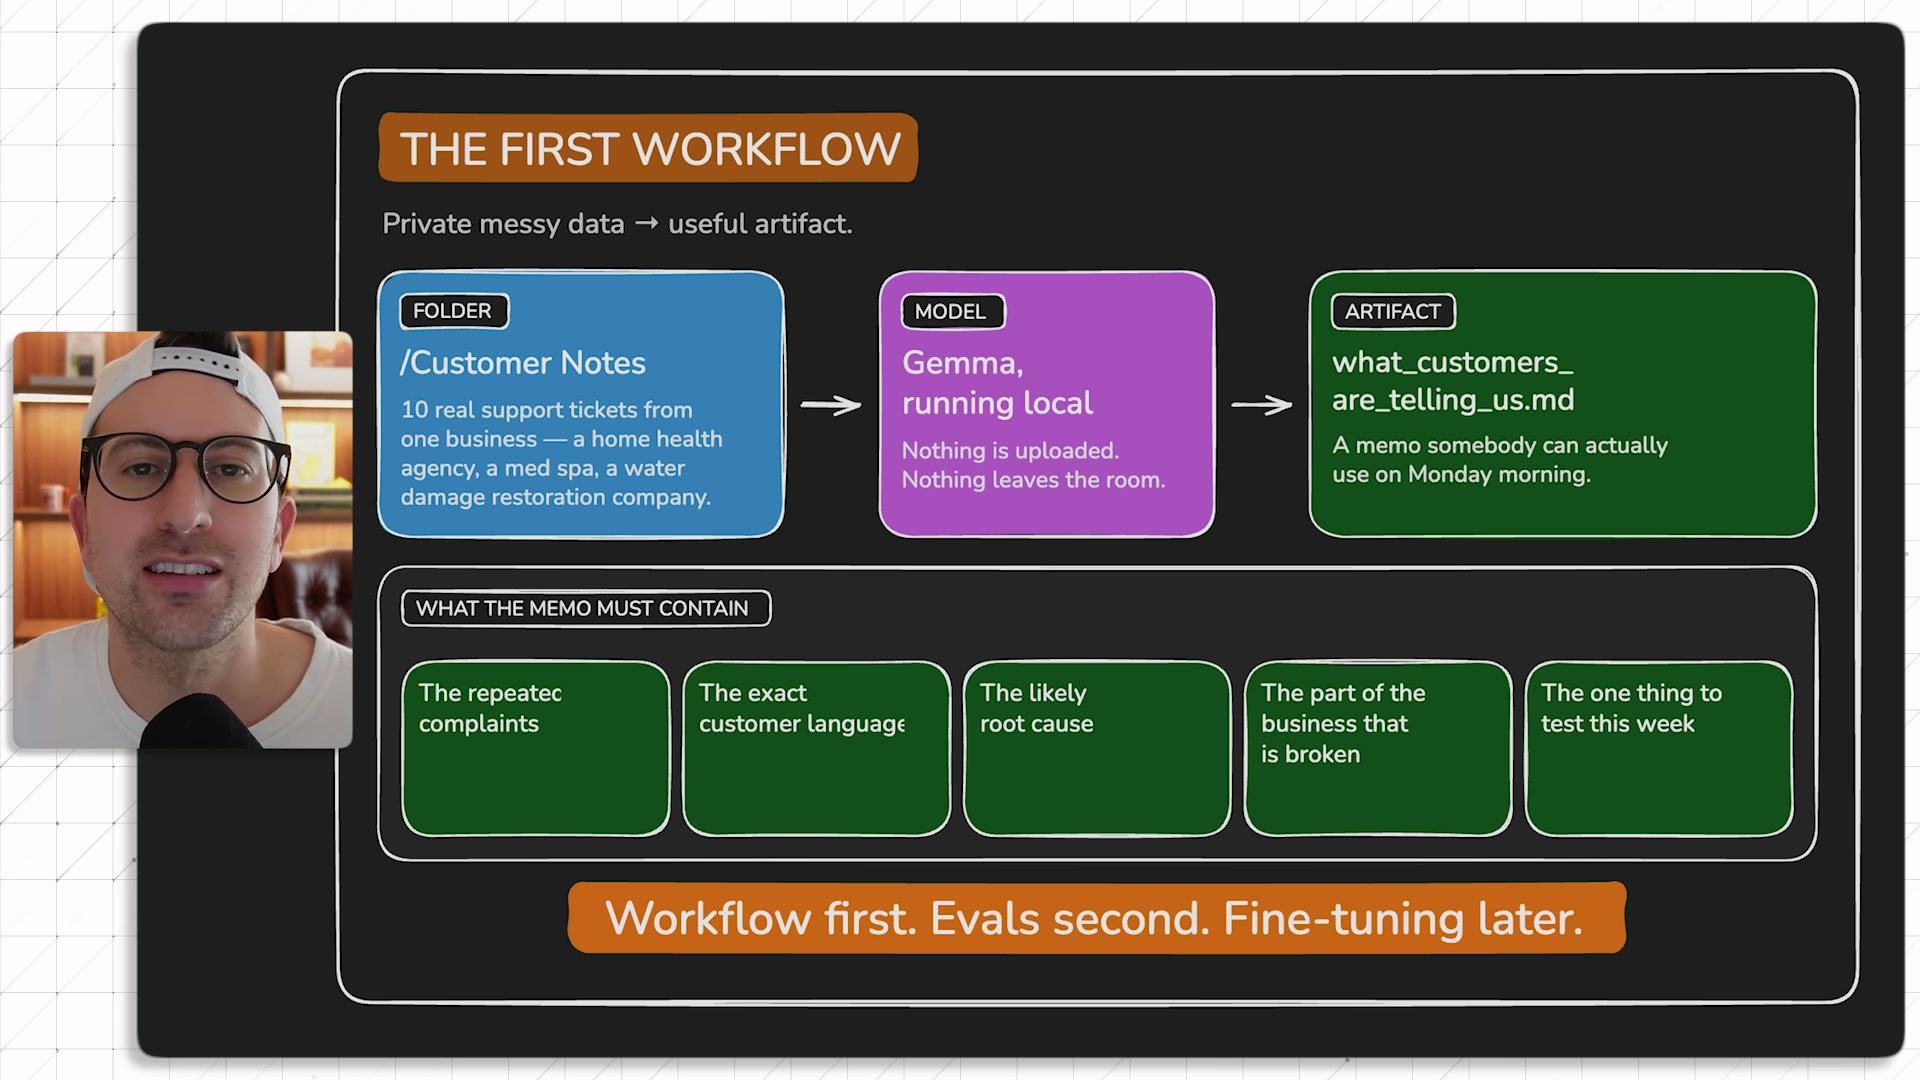
바탕화면에 "customer notes"라는 폴더를 만들고, 방문 간호 업체나 메드스파, 누수 복구 업체 같은 특정 사업의 지원 티켓 10개를 넣어 보세요. "일정을 바꾸려고 했는데 링크를 못 찾았어요", "기사님이 다음에 뭘 하는지 설명을 안 해 줬어요", "예약 확인을 아무도 안 해 줬어요", "두 번 결제됐어요" 같은 내용이겠죠.
그리고 젬마 같은 로컬 모델에게 "고객이 우리에게 하는 말.md"라는 마크다운 파일을 만들게 해요. 반복되는 불만, 고객이 쓴 표현 그대로, 추정 원인, 사업에서 고장 난 부분, 그리고 이번 주에 운영자가 시험해 볼 일 한 가지를 담게 하는 거예요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
지저분한 개인 데이터가 있고, 모델이 바로 옆에서 돌고, 결과물은 누군가 실제로 쓸 수 있는 메모예요. 단순하지만 쓸모 있어서 첫 워크플로로 좋아요.
한 번 해 보면 이 패턴이 어디서나 보여요. 고객 통화 폴더는 시장 조사 메모가 되고, 지원 티켓 폴더는 제품 로드맵 신호가 되고, PDF 폴더는 위험 체크리스트가 되고, 초안 폴더는 발송 전 검토기가 돼요.
Q. 모델을 직접 학습시키는 파인튜닝부터 하고 싶은 사람도 많잖아요.
이해해요. 저도 그랬어요. 멋있게 들리거든요. 그런데 파인튜닝은 고급 기술이고, 초보자는 반복되는 워크플로부터 찾아야 해요. 폴더 하나, 모델 하나, 결과물 하나를 정해서 10번쯤 돌려 보세요. 어디서 헷갈려 하는지 보고, 프롬프트를 고치고, 예시와 체크리스트를 넣고, 작은 평가를 만드는 거예요.
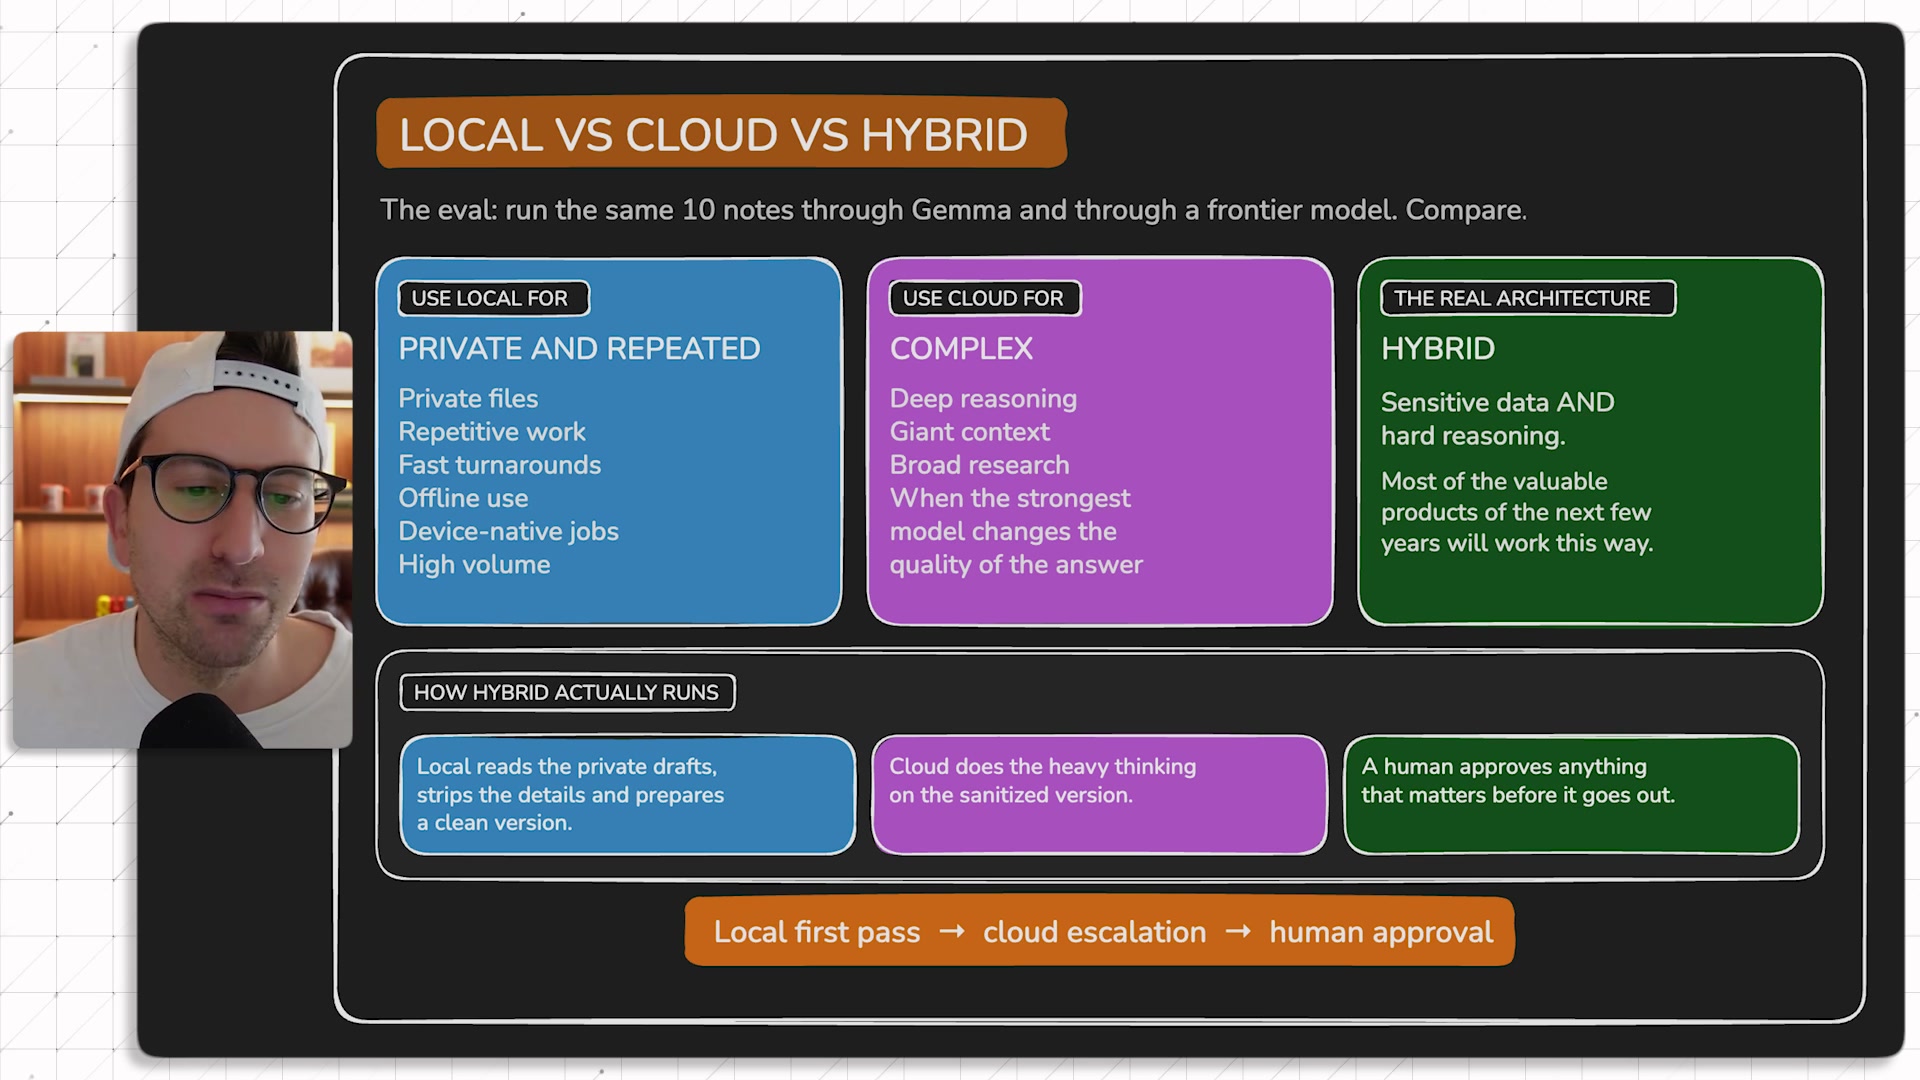
평가(eval)는 모델이 일을 충분히 잘했는지 알려 주는 작은 시험이에요. 이 워크플로라면 간단해요. 같은 고객 메모 10개를 로컬 젬마에도 넣고 강한 클라우드 모델에도 넣어서 결과를 비교하는 거예요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
젬마가 같은 불만을 잡아냈나, 맞는 인용을 뽑았나, 형식을 지켰나, 놓친 게 있나. 이 비교가 로컬이 이미 쓸 만한 곳과 아직 클라우드가 필요한 곳을 알려 줘요.
Q. 로컬과 클라우드는 결국 어떻게 나누나요?
개인적이고, 반복적이고, 빨라야 하고, 오프라인이거나 기기에 붙어 있고, 양이 많은 일은 로컬이에요. 늘 돌리고 싶은 일이죠. 깊은 추론, 거대한 컨텍스트, 넓은 리서치처럼 가장 강한 모델이 답의 질을 바꾸는 일은 클라우드예요.
민감한 데이터와 어려운 추론이 둘 다 있는 제품이면 둘 다 써요. 로컬이 먼저 한 번 처리하고, 필요하면 클라우드로 올리고, 중요한 건 사람이 승인하는 거죠. 가치 있는 제품 상당수가 이렇게 돌아갈 거고, 일도 이렇게 처리될 거라고 봐요.
가져가서 창업해도 되는 아이디어 세 개
Q. 로컬 AI 창업 아이디어는 어떤 기준으로 고르세요?
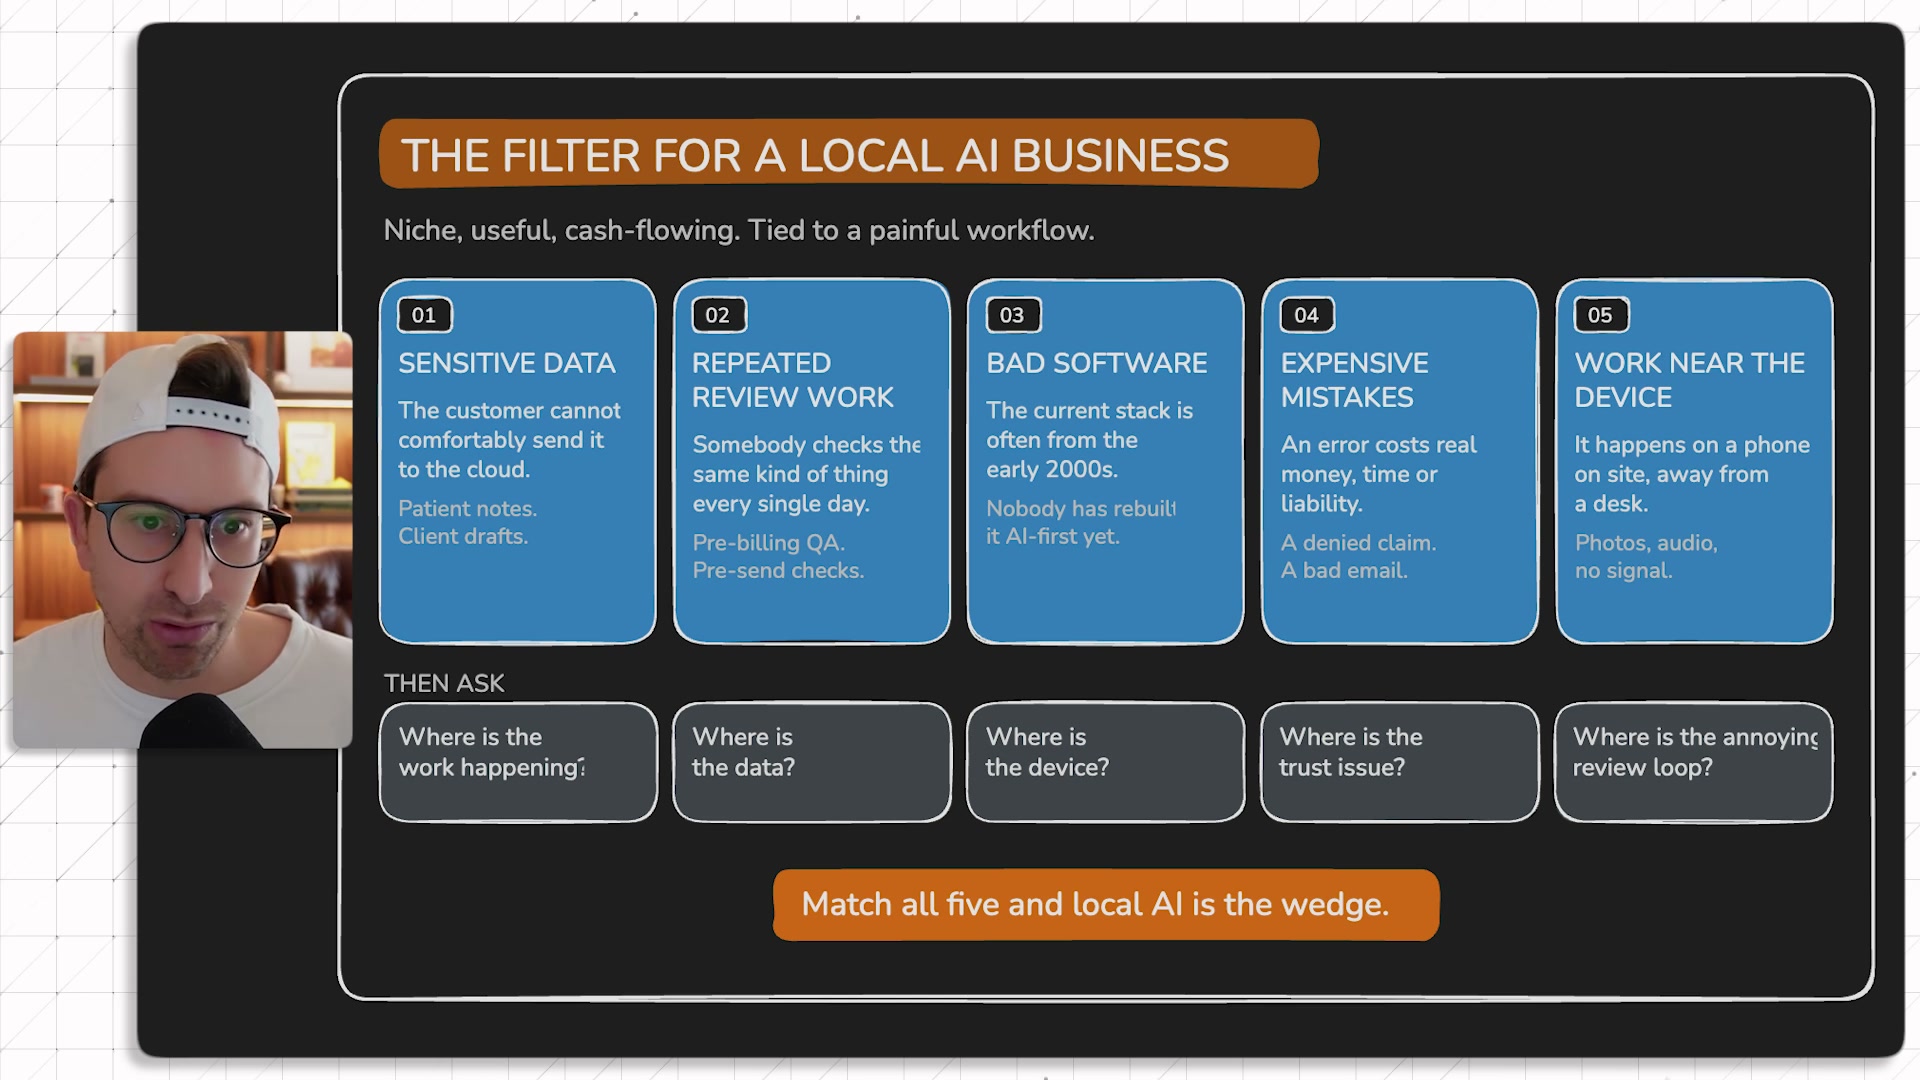
제가 찾는 건 틈새에 있고, 쓸모 있고, 투자 없이도 현금이 도는 사업이에요. 그리고 고통스러운 업무에 붙어 있어야 해요.
필터는 단순해요. 민감한 데이터를 가진 고객, 반복되는 검토 업무, 대체로 형편없는 소프트웨어, 비싼 실수, 그리고 기기 가까이에서 일어나는 업무. 이게 다 겹치는 곳이 제가 흥미를 느끼는 구역이에요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
지금부터 말할 아이디어는 가져가셔도 돼요. 최소한 로컬 AI로 돈을 버는 방법에 대한 상상력은 자극될 거예요.
Q. 첫 번째 아이디어는요?
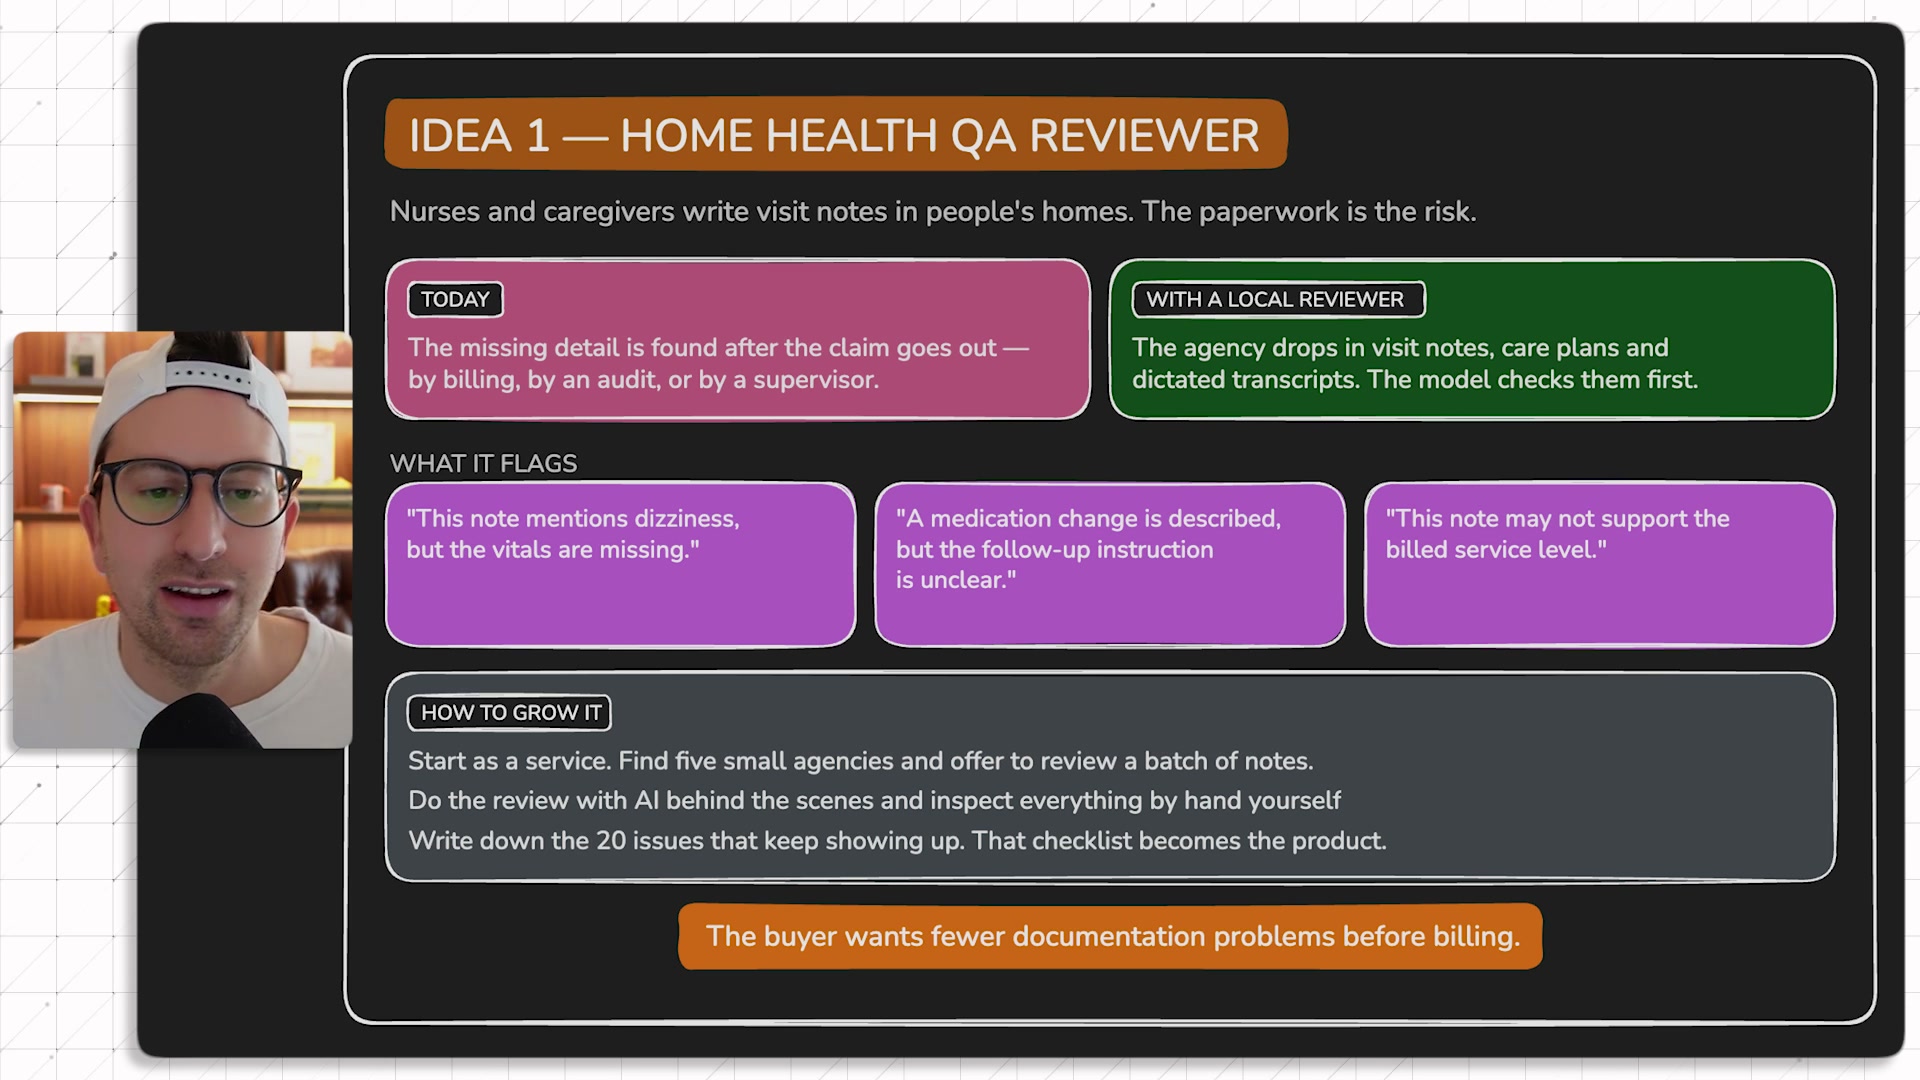
방문 간호 업체를 위한 로컬 품질 검토기예요. 방문 간호 업체에는 간호사와 요양 보호사가 있고, 이들은 집집마다 다니며 방문 기록을 쓰고, 돌봄 계획을 고치고, 청구와 규정 준수까지 챙겨요. 서류 작업이 엄청 고되고 시간을 잡아먹는데, 정말 중요해요. 빠진 정보 하나가 청구를 늦추고, 모호한 기록 하나가 행정 업무를 늘리고, 방문 내용과 돌봄 계획이 안 맞으면 큰 위험이 돼요.
첫 버전은 업체용 로컬 데스크톱 앱이에요. 방문 기록, 돌봄 계획, 받아 적은 녹취를 넣으면 제출 전에 모델이 검토해서 걸리는 걸 표시해요. "어지럼증이 적혀 있는데 활력 징후가 없어요", "투약 변경을 적었는데 후속 지시가 불분명해요", "이 기록으로는 청구한 서비스 등급이 뒷받침되지 않을 수 있어요" 같은 식이죠.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
구매자가 원하는 건 청구나 감사, 관리자 검토 전에 기록 문제가 줄어드는 거예요. 이걸 풀면 관심을 얻을 수 있어요.
Q. 그걸 어떻게 사업으로 키우세요?
저라면 서비스로 시작해요. 작은 방문 간호 업체 다섯 곳을 찾아서 기록 한 묶음을 검토해 주겠다고 제안하는 거예요. 뒤에서는 로컬 AI가 돕고, 처음엔 제가 직접 전부 눈으로 확인해요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
그러다 보면 계속 나오는 문제 20개를 적게 되고, 그게 체크리스트가 되고, 그 체크리스트가 결국 제품이 돼요. 기록 문제가 업체의 시간과 돈을 잡아먹기 전에 잡아 주는 단순한 쐐기에서 시작해 넓혀 가는 거죠. 저는 이 사업이 정말 좋고, 제가 하라면 할 거예요.
Q. 두 번째 아이디어는요?
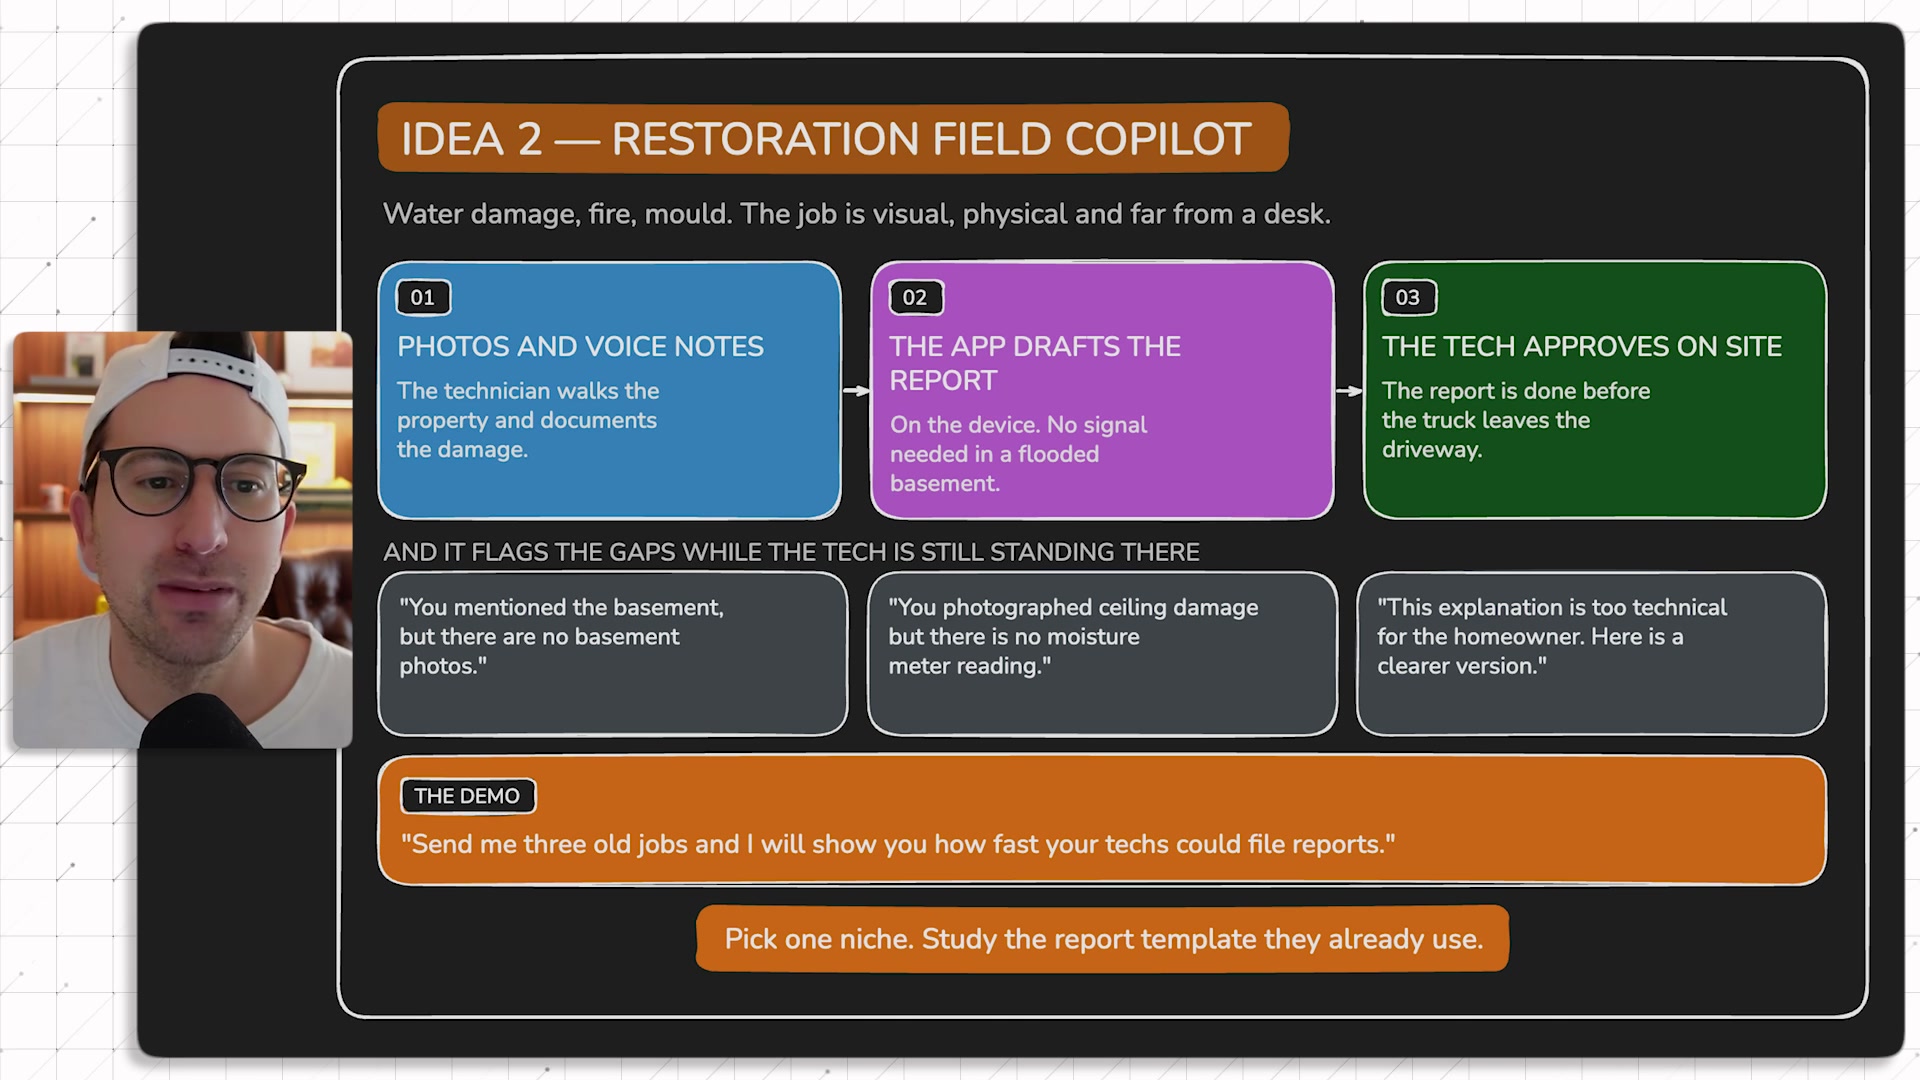
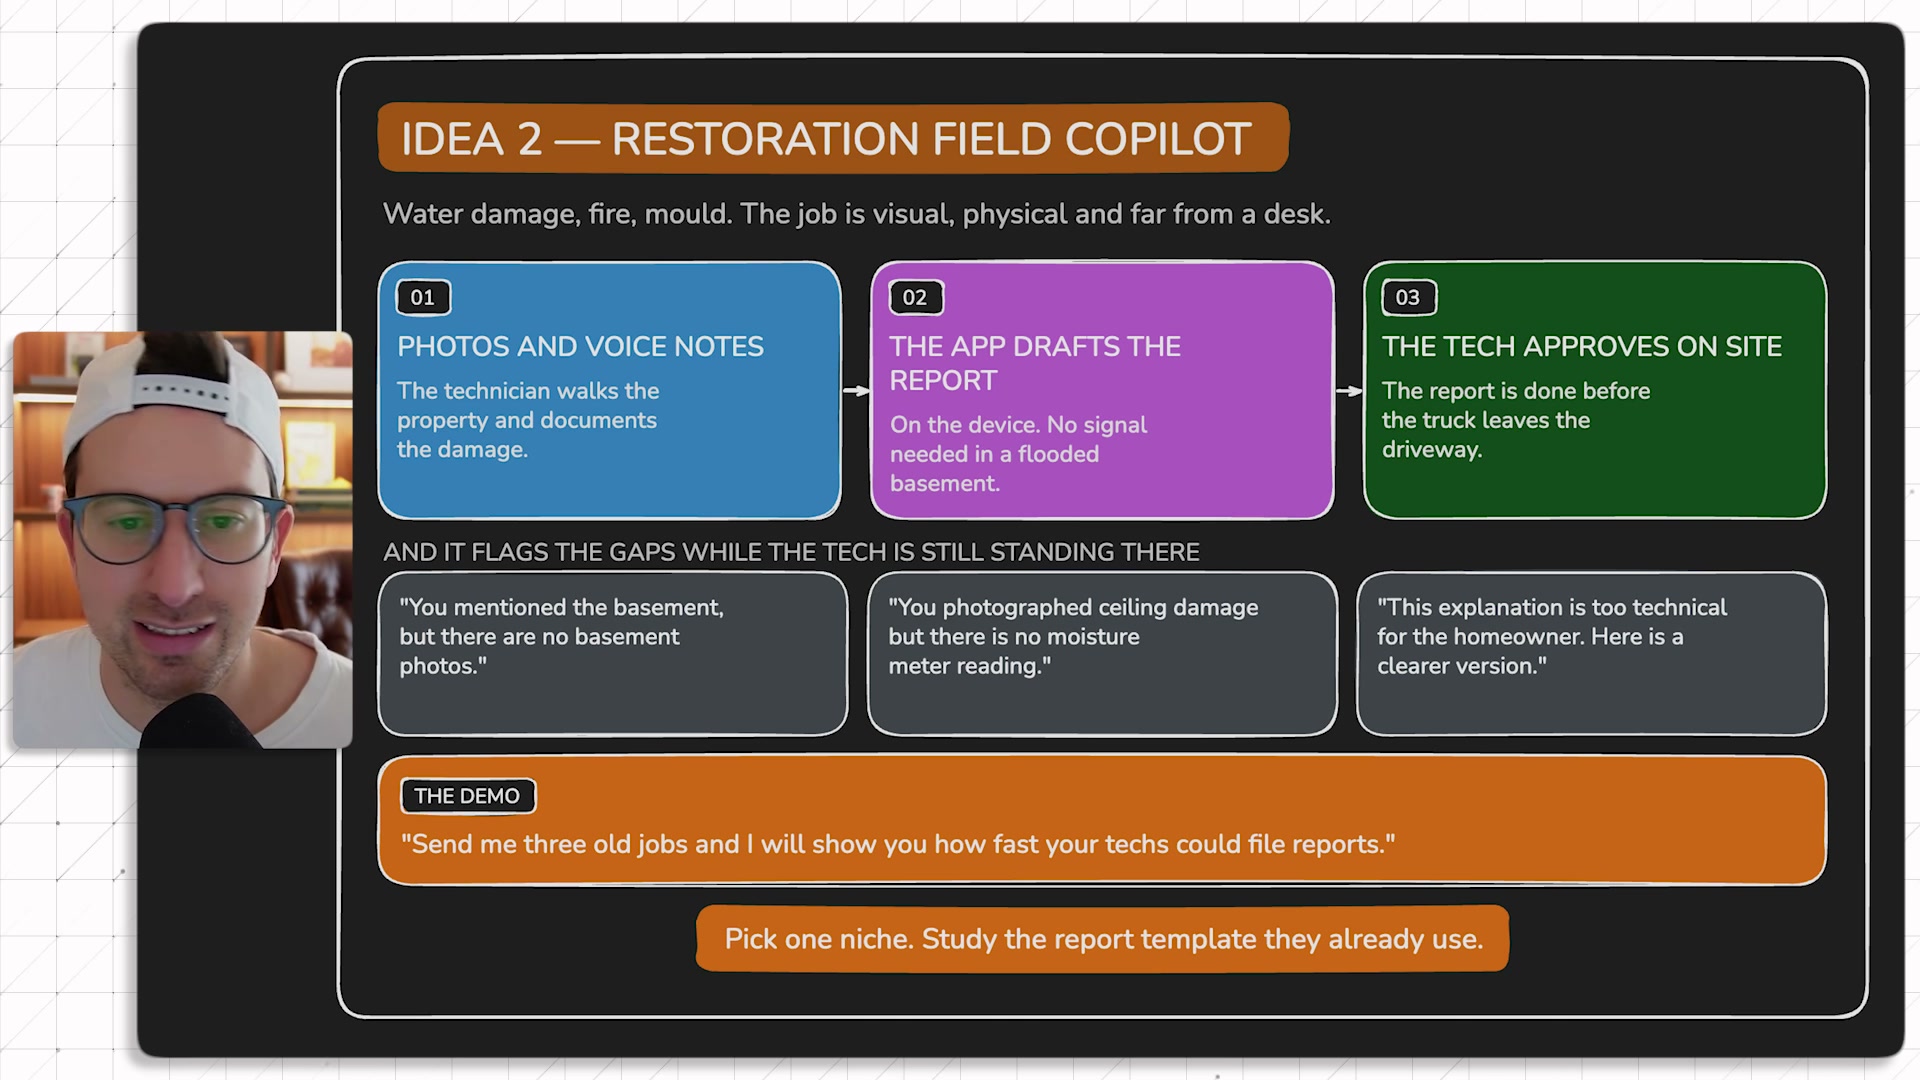
복구 업체를 위한 오프라인 현장 보고서 코파일럿이에요. 누수, 화재, 곰팡이 제거 같은 일을 하는 팀들이요. 이들은 현장에서 사진을 찍고, 메모를 녹음하고, 피해를 기록하고, 집주인과 보험 손해사정사에게 보낼 보고서를 만들어요. 안타깝게도 제가 이걸 겪어 봐서 좀 알아요.
일은 시각적이고 몸으로 하는 거라 책상에서 떨어져 있어요. 그런데 보고서가 기술자, 고객, 사무실, 보험 처리 사이의 인수인계 문서가 되니까 중요하죠.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
첫 버전은 모바일 앱이에요. 기술자가 집을 돌면서 사진을 찍고 음성 메모를 남기면, 현장을 떠나기 전에 앱이 보고서 초안을 써요. 아직 현장에 있을 때 빠진 걸 짚어 주고요. "지하실을 언급했는데 지하실 사진이 없어요", "천장 피해 사진은 있는데 습도 측정값이 없어요", "집주인 설명이 너무 전문적이에요, 이해하기 쉬운 버전은 이거예요."
마지막 부분이 과소평가돼 있어요. 집이 망가져 스트레스받는 상황에서는 분명한 소통 자체가 제품의 일부거든요.
Q. 이건 어떻게 파세요?
틈새 하나를 먼저 골라요. 누수 복구라고 해 봅시다. 직접 현장을 뛰는 사장님들과 이야기하고, 지금 쓰는 보고서 양식과 오래된 소프트웨어를 살펴보고, 이미 그들 머릿속에 있는 체크리스트를 중심으로 만들어요.
데모는 오히려 쉬워요. "예전 작업 세 건만 보내 주시면 기술자분들이 보고서를 얼마나 빨리 만들 수 있는지 보여 드릴게요." 그게 통하면 품질 검토, 견적, 보험 서류, 고객 안내, 신입 교육으로 넓혀 갈 수 있어요. 그래도 시작은 구체적이고 누가 봐도 짜증 나는 현장 보고서예요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
최근 제 아파트에 누수가 났는데, 업체가 쓰는 소프트웨어를 보니 2000년대 초반 물건이더라고요. 그래서 로컬 AI 네이티브 소프트웨어로 지금 파고들 기회가 있다고 봐요. 처음에 24개월짜리 창이 열려 있다고 말한 이유가 이거예요.
Q. 세 번째 아이디어는요?
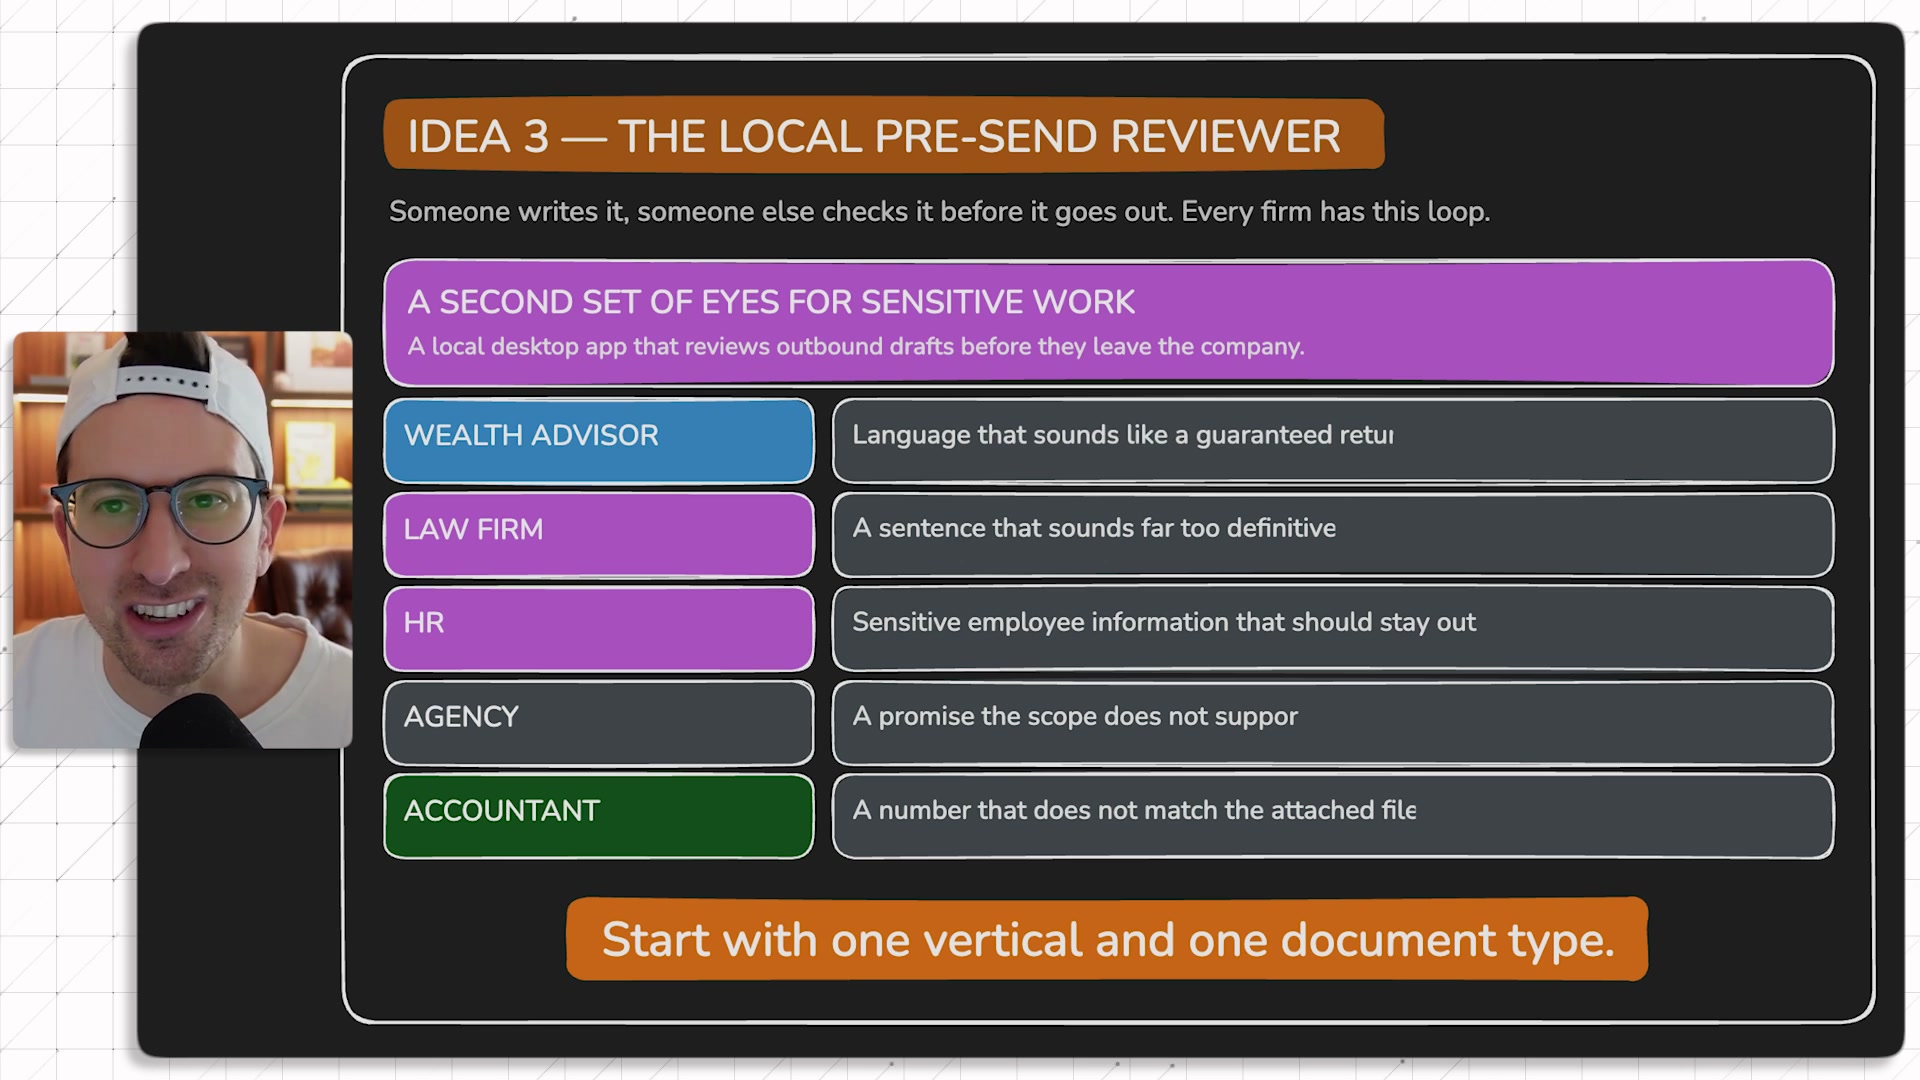
전문 서비스 회사를 위한 로컬 발송 전 검토기예요. 전문 서비스 회사라면 99.9%가 이 업무를 갖고 있어요. 누군가 고객 이메일, 제안서, 메모, 계약 요약, 투자 노트, 인사 메모를 쓰면, 다른 누군가에게 나가기 전에 봐 달라고 하죠.
첫 버전은 회사 밖으로 나가는 초안을 검토하는 로컬 데스크톱 앱이에요. 자산관리사라면 수익을 보장하는 것처럼 들리는 표현을 잡아요. 절대 해선 안 되는 말이거든요. 로펌이면 너무 단정적인 문장을, 인사팀이면 스레드에 들어가면 안 될 직원 민감 정보를, 에이전시면 계약 범위가 뒷받침하지 않는 약속을, 회계사면 첨부 파일과 안 맞는 숫자를 잡아요. 이런 일이 얼마나 자주 일어나는지 알면 놀라실 거예요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
결국 민감한 일에 두 번째 눈을 붙여 주는 제품이에요. 저는 이걸 "바보짓 보험(schmuck insurance)"이라고 생각해요. 이름을 schmuckinsurance.com으로 해도 되겠네요. 이미 누가 가져갔으면 알려 주세요.
Q. 이것도 서비스처럼 시작하나요?
업종 하나, 문서 종류 하나로 시작해요. 예를 들면 대형 은행이 아니라 독립 자산관리사의 이메일 검토요. 자산관리사 10명을 인터뷰해서 어떤 이메일이 불안한지 묻고, 익명 처리한 예시를 모으고, 그들의 실제 걱정을 검토 체크리스트로 바꾸고, 그 체크리스트로 초안을 검사하는 로컬 도구를 만들어요.
이건 팔기가 정말 쉬워요. 구매자가 이미 누군가에게 초안 검토를 부탁하고 있거든요. 우리는 고객 데이터와 내부 규칙 가까이에 사는, 더 빠른 첫 검토를 주는 것뿐이에요. 몇 분이라도 이 아이디어를 가져가셨으면 좋겠어요.
벤치마크 말고 제품 이야기를 하세요
Q. 당장 창업할 생각이 없어도 로컬 AI를 배울 필요가 있을까요?
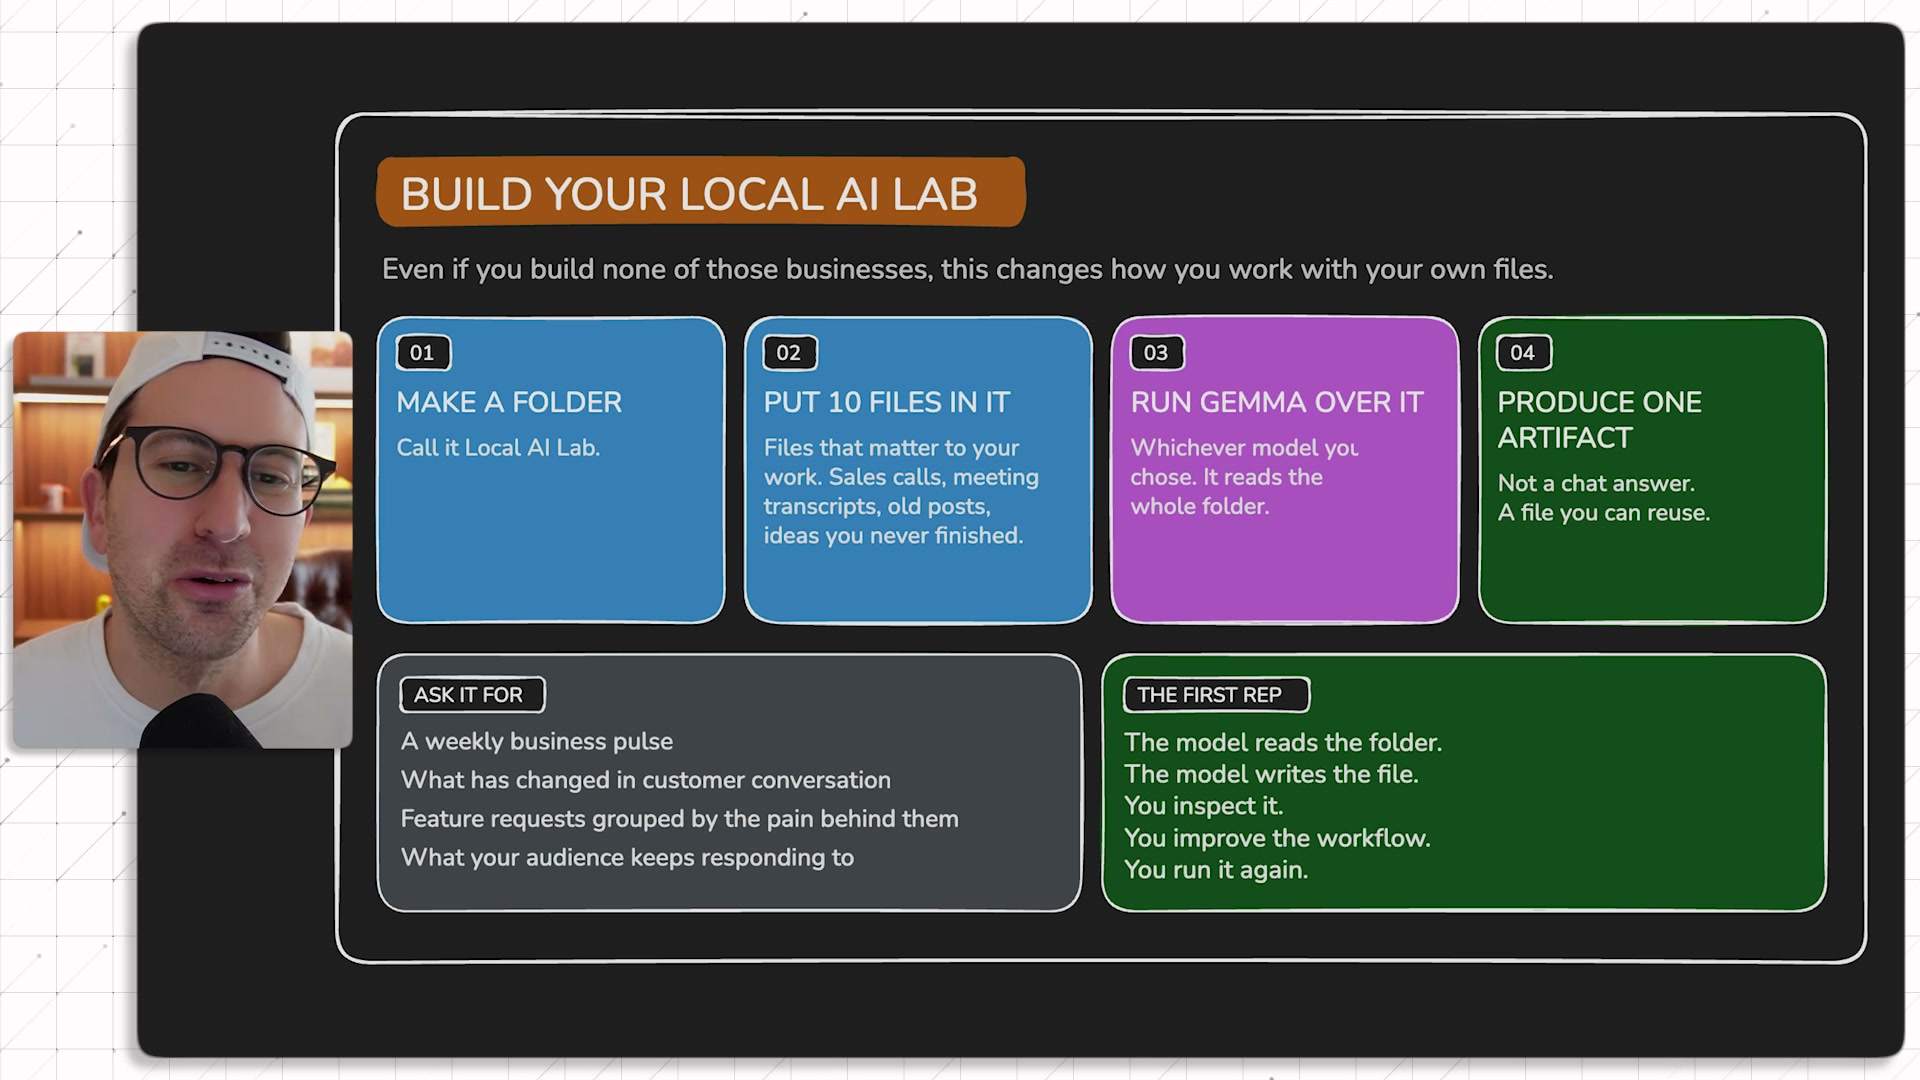
있어요. 내 파일을 다루는 방식이 바뀌거든요. 회사에 다니면서 일을 좀 더 빨리 끝내고 틱톡을 보든 영화를 보든 가족과 시간을 보내고 싶다면, "local AI lab"이라는 폴더를 만들고 내 일에 중요한 파일 10개를 넣어 보세요. 영업 통화, 회의 녹취, 옛날 트윗, 아이디어 메모 뭐든 좋아요.
그리고 젬마든 원하는 모델이든 돌려서 쓸모 있는 결과물 하나를 만들게 하세요. 주간 비즈니스 현황을 만들게 하거나, 고객 대화에서 뭐가 달라졌는지 찾게 하거나, 기능 요청을 그 뒤에 있는 진짜 고통별로 묶게 하는 거예요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
핵심은 다시 쓸 수 있는 파일을 만드는 거예요. 메모, 체크리스트, 브리프, 보고서, 검토서요. 채팅 답변도 좋지만 워크플로를 바꾸는 건 쓸모 있는 결과물이에요. 모델이 폴더를 읽고, 파일을 쓰고, 내가 살펴보고, 워크플로를 고치고, 다시 돌려요.
Q. 마지막으로, 오늘 시작한다면 뭘 하시겠어요?
저라면 젬마를 로컬에서 돌리고, 허깅페이스에서 모델 카드를 읽고, LM 스튜디오와 올라마의 차이를 익히고, 구글 AI 엣지를 만져 볼 거예요. 그리고 로컬 AI가 제품을 실제로 더 낫게 만드는 지루한 워크플로 하나를 찾을 거예요.
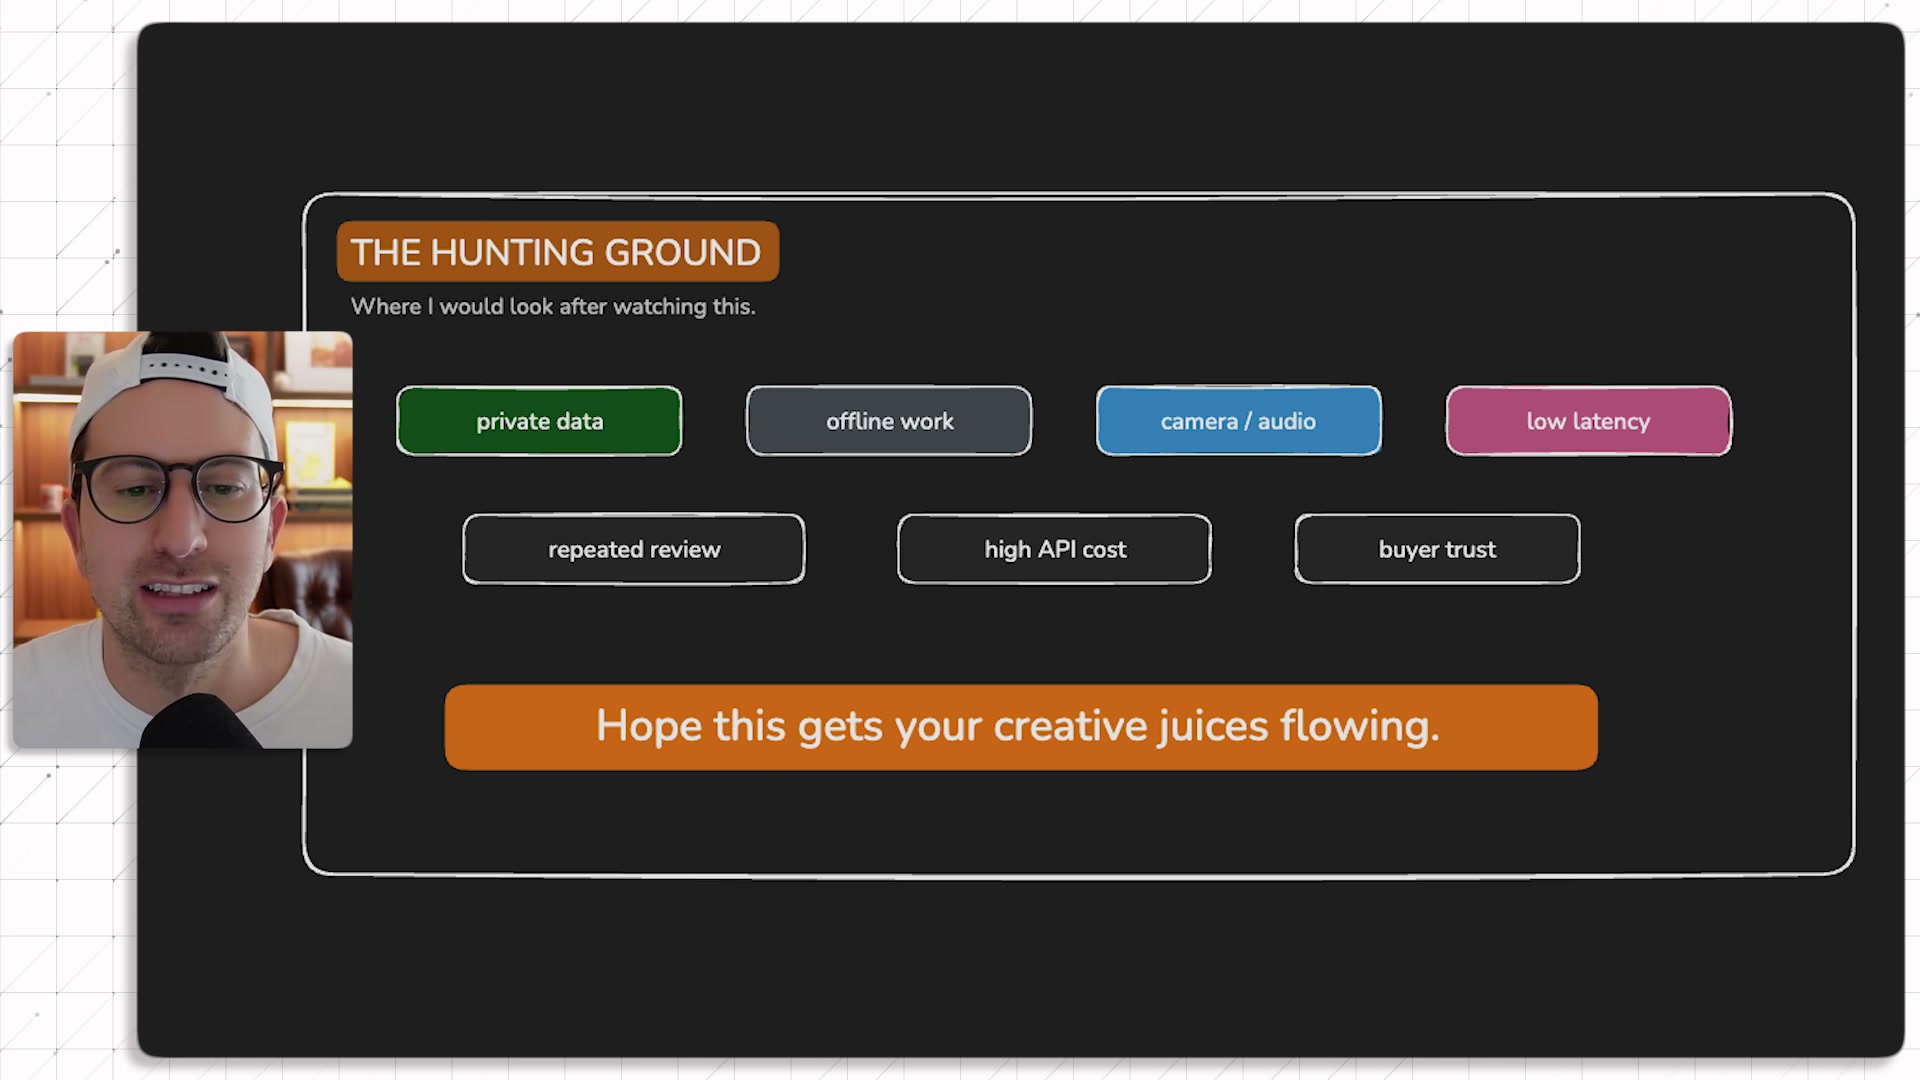
개인 데이터, 오프라인 작업, 카메라나 음성 맥락, 낮은 지연 시간, 반복되는 API 비용이 큰 곳. 모델이 가까이 있을 때 더 안심하는 구매자. 작은 에이전트 팀이 매일 다시 확인하고 요약하고 일을 준비해 줄 수 있는 업무. 거기가 사냥터예요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg
로컬 AI는 모델 벤치마크 이야기로 보지 않고 제품 이야기로 보는 순간 훨씬 쉬워져요. 일은 어디서 일어나나, 데이터는 어디 있나, 기기는 어디 있나, 신뢰 문제는 어디 있나, 짜증 나는 검토 루프는 어디 있나. 이 질문에 답하다 보면 아이디어가 그냥 보여요.
기술을 모르는 사람이 로컬 AI를 가지고 노는 걸 아직 많이 못 봤어요. 저는 지난 두 달 동안 점점 깊이 들어갔고, 그러면서 점들이 이어졌어요. 그게 정말 고마워요.
이미지 출처 : Youtube 'I'm Obsessed With Local AI. Here's Why', by Greg Isenberg



의견을 남겨주세요