안녕하세요. ‘소리로 코딩하다’입니다.
이번 3호는 예정했던 시간보다 늦게 전해드리게 됐습니다. 기다려주신 분들께 죄송합니다. 그리고 기다려주셔서 감사합니다.
“저 저 학교에 갔어요.”
이 말을 AI가 “저 학교에 갔어요”로 적었다면 어떨까요? 내용을 요약할 때는 읽기 편할 수 있습니다. 하지만 반복이 어떻게 나타났는지 살펴보려는 기록이라면, 확인할 정보 한 조각이 빠진 셈입니다.
앞선 자동전사 글에서는 전사문과 원음을 다시 비교하는 문제를 다뤘습니다. 이번에는 한 걸음 더 들어가 보겠습니다. 말더듬 음성을 살펴보는 도구를 만든다면, 무엇을 분리하고 어떤 기록부터 남겨야 할까요?
이번 호에서 얻어갈 것 3개입니다.
- 전사·시간 정렬·사건 후보 검출·설명을 나누는 설계 기준
- 음성을 올리지 않고도 해볼 수 있는 전사 비교 프롬프트와 수정 예시
- 내 컴퓨터와 클라우드 비용을 같은 계산 틀에 놓는 방법
이번 글은 공개 문서를 확인하고 가상 텍스트로 비교 과정을 설계한 기록입니다. 아래 모델들을 실제 한국어 말더듬 음성에 실행한 성능 실험은 아닙니다. 진단이나 치료를 위한 도구 사용을 권하는 글도 아닙니다.
1. ‘무슨 말을 했는지’와 ‘어떻게 말했는지’
말더듬에는 소리·음절·낱말의 반복, 소리의 연장, 막힘 등이 나타날 수 있습니다.[1] 다만 반복이나 간투사가 보인다는 이유만으로 말더듬이라고 판단할 수는 없습니다. ASHA도 누구나 비유창하게 말할 수 있으며, 평가에는 말하기에 대한 반응과 생활에 미치는 영향 등을 함께 살펴야 한다고 설명합니다.[2]
그래서 도구의 첫 화면에 ‘진단 결과’를 놓기보다, 다시 들어볼 구간과 확인 근거를 놓는 설계부터 생각하고 있습니다.
저장할 기록은 네 가지로 나눕니다.
- 원음: 다시 들을 수 있는 자료
- AI 원출력: 모델이 처음 만든 전사, 수정하지 않고 보관
- 사람 검토본: 수정한 내용과 불확실한 부분을 남긴 전사
- 분석·설명본: 무엇을 관찰했고 무엇을 확인하지 못했는지 적은 기록
여기서 ‘사람 검토본’도 자동으로 정답이 되지는 않습니다. 잘 안 들리는 곳은 잘 안 들린다고 남겨야 다음 검토가 가능합니다.
2. 모델 하나에 네 가지 일을 맡기지 않기
다음은 구현 완료된 시스템이 아닌, 제가 비교 실험을 위해 정리한 역할 분담안입니다.
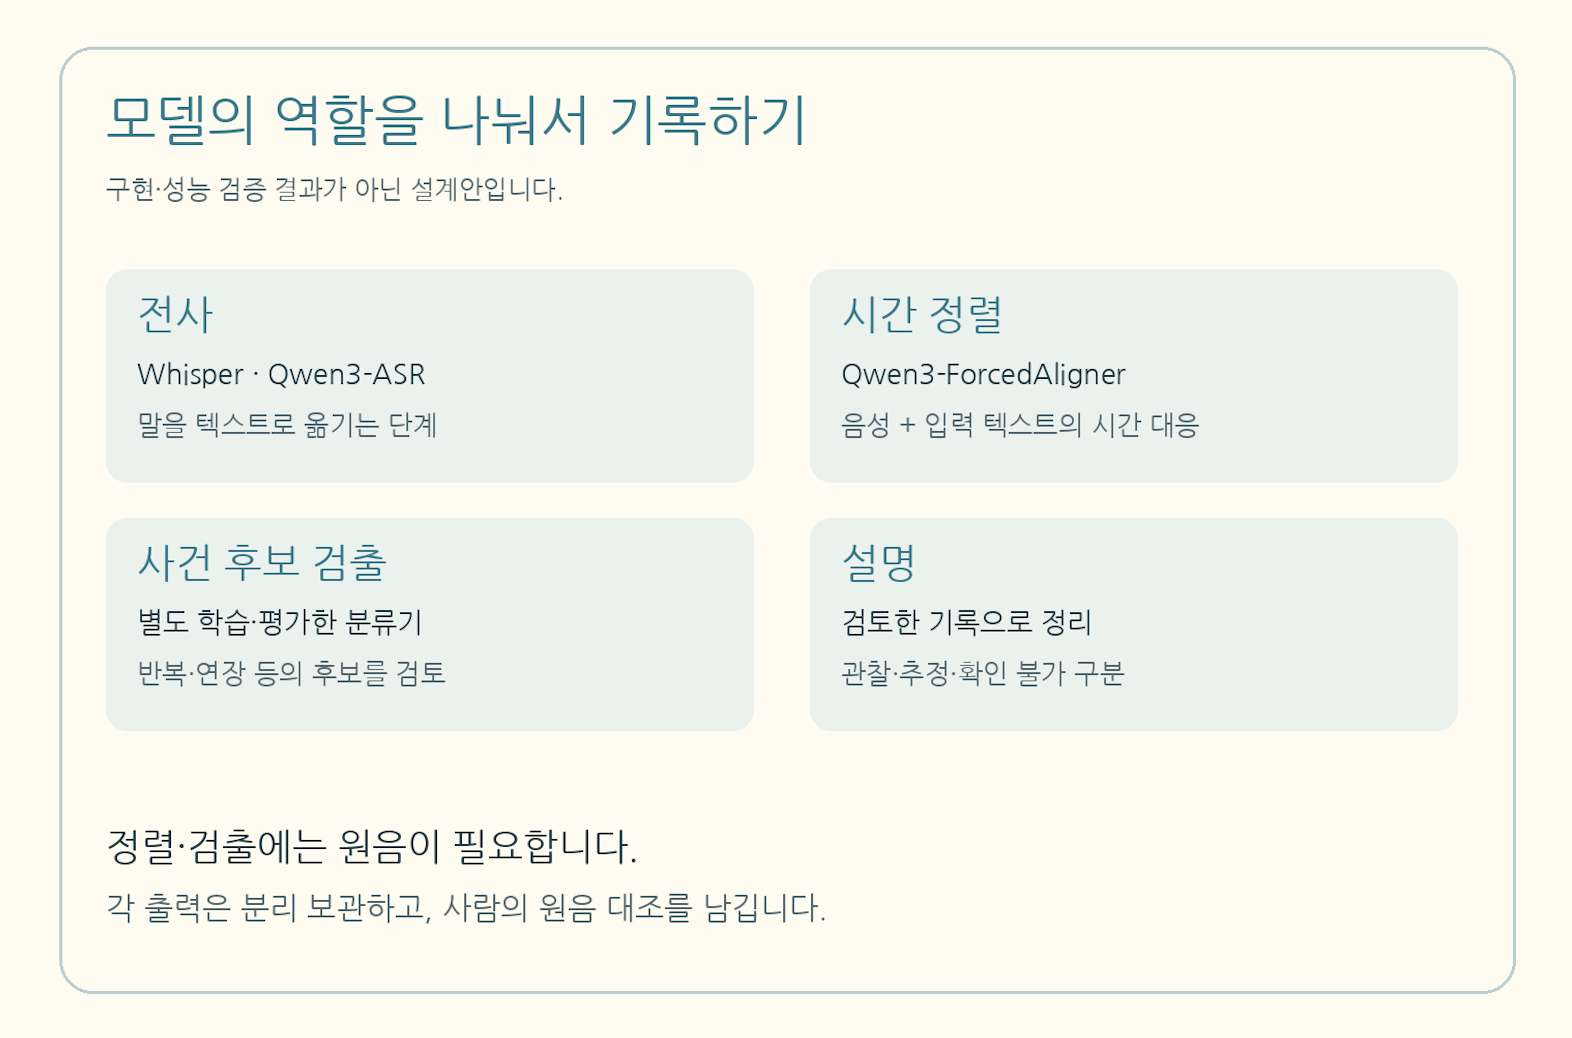
전사·시간 정렬·사건 후보 검출·설명의 역할을 나눈 설계 안내. 실제 구동 결과가 아닙니다.
| 역할 | 시작 후보·방식 | 이 단계에서 확인할 것 |
|---|---|---|
| 전사 | Whisper 다국어 모델, Qwen3-ASR | 실제로 말한 단어·반복이 남았는가 |
| 시간 정렬 | Qwen3-ForcedAligner 등 | 음성과 입력 텍스트의 시간 대응이 맞는가 |
| 사건 후보 검출 | 별도로 학습·평가한 wav2vec 2.0 기반 분류기 등 | 반복·연장 등 후보의 누락·오탐은 어떠한가 |
| 설명 | 검토한 기록을 바탕으로 한 텍스트 정리 | 관찰·추정·확인 불가를 구분하는가 |
Qwen 공식 자료에는 Qwen3-ASR와 Qwen3-ForcedAligner의 한국어 지원이 명시돼 있습니다.[3] 한국어를 지원한다는 설명은 한국어 말더듬을 정확히 보존한다는 검증과 다릅니다.
시간 정렬도 마찬가지입니다. 제공한 문장을 음성 구간에 대응시키는 일과, 전사에서 빠진 반복을 찾아 복구하는 일은 같다고 볼 수 없습니다. 정렬에 넣을 텍스트부터 원음과 대조해야 합니다.
wav2vec 2.0은 그 이름만으로 말더듬을 판정하는 완성품이 아닙니다. 관련 연구에서는 이를 바탕으로 분류기를 학습하고 평가했습니다. Haas와 Bayerl의 다국어 연구는 영어·독일어·중국어를 다루며, 그 결과를 한국어 정확도로 옮겨 적을 수는 없습니다.[4]
설명용 언어모델은 마지막에 둡니다. 모델이 그럴듯하게 설명하기 전에, 설명의 바탕이 될 기록이 남아 있어야 하기 때문입니다.
3. 작은 실습: 두 모델이 같은 말을 지웠다면?
실제 음성이나 개인정보를 넣지 않고 시작해 보겠습니다. 아래는 이 글을 위해 만든 가상 자료입니다. ASR A와 B는 특정 서비스의 실제 출력이 아닙니다. 시간 표시도 설명을 위한 가상 구간입니다.
| 구간 | 사람 표기 | ASR A | ASR B |
|---|---|---|---|
| S1 · 00:03–00:05 | 저 저 학교에 갔어요 | 저 학교에 갔어요 | 저 학교에 갔어요 |
| S2 · 00:08–00:10 | 어 오늘은 쉬어요 | 오늘은 쉬어요 | 어 오늘은 쉬어요 |
| S3 · 00:12–00:14 | [청취불명]에 갔어요 | 학교에 갔어요 | 학원에 갔어요 |
S1에서는 두 모델의 출력이 같습니다. 그렇다고 반복이 없었다고 결론 내릴 수 있을까요? 사람 표기를 기준으로 비교하면, 두 출력 모두 두 번째 ‘저’가 없습니다.
S3에서는 어느 쪽이 더 자연스러운지 고르는 대신, 현재 자료만으로는 알 수 없다는 상태를 유지해야 합니다.
복사할 프롬프트 — 써보기 전 초안
아래 프롬프트는 텍스트 차이를 표시하는 용도입니다. 원음을 듣거나 임상적 판단을 수행하는 도구가 아닙니다.
역할: 전사 텍스트 비교를 돕는 기록 보조자.
아래 입력에는 사람 표기, ASR A, ASR B, 구간 표시가 있다.

규칙:
1. 입력을 매끄러운 문장으로 고치거나 사람 표기를 덮어쓰지 않는다.
2. 사람 표기를 비교 기준열로 두되, 완전한 정답이라고 단정하지 않는다.
3. 반복된 토큰·간투사·낱말의 삭제/차이를 입력에 있는 그대로 표시한다.
4. A와 B가 같으면 '모델 간 일치'라고만 쓴다. 정확하다고 판정하지 않는다.
5. [청취불명]은 그대로 남긴다. 문맥이나 다수결로 낱말을 채우지 않는다.
6. 음성이 없으므로 실제 발음·막힘·연장·정확한 시간 경계를 판정하지 않는다.
7. 타임스탬프는 입력에서 복사할 뿐 새로 추정하지 않는다.
8. 진단·치료 권고·중증도·말더듬 비율을 산출하지 않는다.

출력:
구간 ID | 사람 표기 | A | B | 텍스트 차이 | 원음 재확인 질문
마지막에 이 비교로 알 수 없는 것 2개를 적는다.

[가상 입력 — 실제 음성·모델 실행 아님]
S1 | 구간 00:03–00:05 | 사람 표기: 저 저 학교에 갔어요 | ASR A: 저 학교에 갔어요 | ASR B: 저 학교에 갔어요
S2 | 구간 00:08–00:10 | 사람 표기: 어 오늘은 쉬어요 | ASR A: 오늘은 쉬어요 | ASR B: 어 오늘은 쉬어요
S3 | 구간 00:12–00:14 | 사람 표기: [청취불명]에 갔어요 | ASR A: 학교에 갔어요 | ASR B: 학원에 갔어요
모의 응답과 읽는 방법
아래는 현재 대화에서 작성한 교육용 모의 응답을 읽기 쉽게 편집한 표입니다. 별도 ASR 실행·독립 모델 재실행·임상 검증 결과가 아닙니다.
| 구간 | 텍스트에서 찾은 차이 | 다음에 확인할 질문 |
|---|---|---|
| S1 | A와 B 모두 사람 표기의 두 번째 ‘저’가 없음 | 원음에도 ‘저’가 두 번 있는가? |
| S2 | A에는 ‘어’가 없고 B에는 남아 있음 | 실제 산출과 사람 표기가 일치하는가? |
| S3 | A는 ‘학교’, B는 ‘학원’을 제시 | 원음에서 낱말을 식별할 수 있는가? 불명확하면 그대로 남길 수 있는가? |
이 표는 차이를 찾아주는 메모입니다. S1의 반복이 어떤 유형인지, S2의 ‘어’가 임상적으로 무엇을 의미하는지, S3의 정답이 무엇인지는 이 표만으로 판단하지 않습니다.
이런 결론은 고쳐야 합니다
아래 ‘잘못된 해석’은 오류를 설명하기 위해 만든 문장입니다. 실제 모델이 출력한 실패 기록은 아닙니다.
| 잘못된 해석 | 수정 | 수정 이유 |
|---|---|---|
| A와 B가 같으니 정확하다 | 두 모델이 일치한다. 원음 확인은 남아 있다 | 같은 오류를 낼 가능성을 배제하지 못함 |
| 문맥상 ‘학교’가 맞다 | 청취불명을 유지하고 재청취한다 | 문맥 추정이 실제 산출을 대신할 수 없음 |
| 반복이 하나 있으니 말더듬이다 | 텍스트 차이만 기록한다 | 진단과 비유창성의 단순 계수는 다른 일 |
사람이 확인할 일을 없애는 프롬프트보다, 무엇을 다시 확인해야 하는지 남기는 프롬프트를 먼저 만들고 싶습니다.
4. 내 컴퓨터에서는 어디까지 시작할까?
Whisper 공식 저장소가 안내하는 대략적인 GPU 메모리 요구량은 다음과 같습니다.[5]
| 다국어 모델 | 공식 안내의 대략적 VRAM |
|---|---|
| tiny / base | 약 1GB |
| small | 약 2GB |
| medium | 약 5GB |
| large | 약 10GB |
| turbo | 약 6GB |
VRAM은 그래픽카드 메모리입니다. 컴퓨터의 일반 메모리인 RAM과 구분해야 합니다. 위 숫자는 특정 실행의 피크 사용량을 보장하는 값이 아니며, 오디오 길이·배치·구현·정밀도에 따라 조건이 달라집니다. 다른 구현이나 양자화 설정에 그대로 적용하지 않습니다.
독자 전체가 시작점을 잡는다면 이렇게 생각해볼 수 있습니다. 아래는 실측 결과가 아닌 실험 순서 제안입니다.
| 현재 환경 | 먼저 해볼 범위 | 뒤로 미룰 일 |
|---|---|---|
| 저사양·GPU 없음 | 위 가상 텍스트로 비교·기록 방식 설계. 필요하면 작은 모델의 CPU 실행 가능 조건 확인 | 긴 음성 일괄 처리, 실시간 처리 약속 |
| 일반 PC·노트북 | 지원되는 구현과 메모리를 확인하고 짧은 파일 하나로 시간·사용량 측정 | 여러 모델 동시 적재 |
| 8GB급 GPU | 메모리 여유를 확인하며 작은 모델부터 단독 실행 후 medium/turbo 등 비교 검토 | 큰 모델·정렬기·설명 모델을 모두 동시에 실행한다고 가정하기 |
| 메모리 여유 있는 서버·클라우드 | 같은 파일·설정으로 비교하고 피크 메모리·처리시간 기록 | 사용량을 모르는 상태에서 상시 운영 |
모델을 순차 실행하면 동시에 올려둘 때와 메모리 조건이 달라집니다. 8GB라는 숫자 하나로 가능·불가능을 단정하지 않는 이유입니다.
‘로컬’이라는 이름도 확인이 필요합니다. 사이트 접수, 작업 대기열, 분석 기기, 결과 저장소와 백업이 실제로 어디에 있는지 따로 살펴야 합니다.
5. 비용은 단가보다 ‘켜 둔 시간’부터
이번에는 Runpod 공개 가격표의 Pods 표시값으로 계산해봤습니다. 확인일은 2026년 10월 24일입니다.[6] 실제 배포 화면의 지역·가용성·구성에 따른 견적과는 다를 수 있습니다. Serverless 요금과 혼용하지 않습니다.
계산을 위한 환율은 1달러=1,500원이라는 가정입니다. 현재 환율을 조회한 값이 아닙니다. 상시 가동은 24시간×30일=720시간으로 통일했습니다.
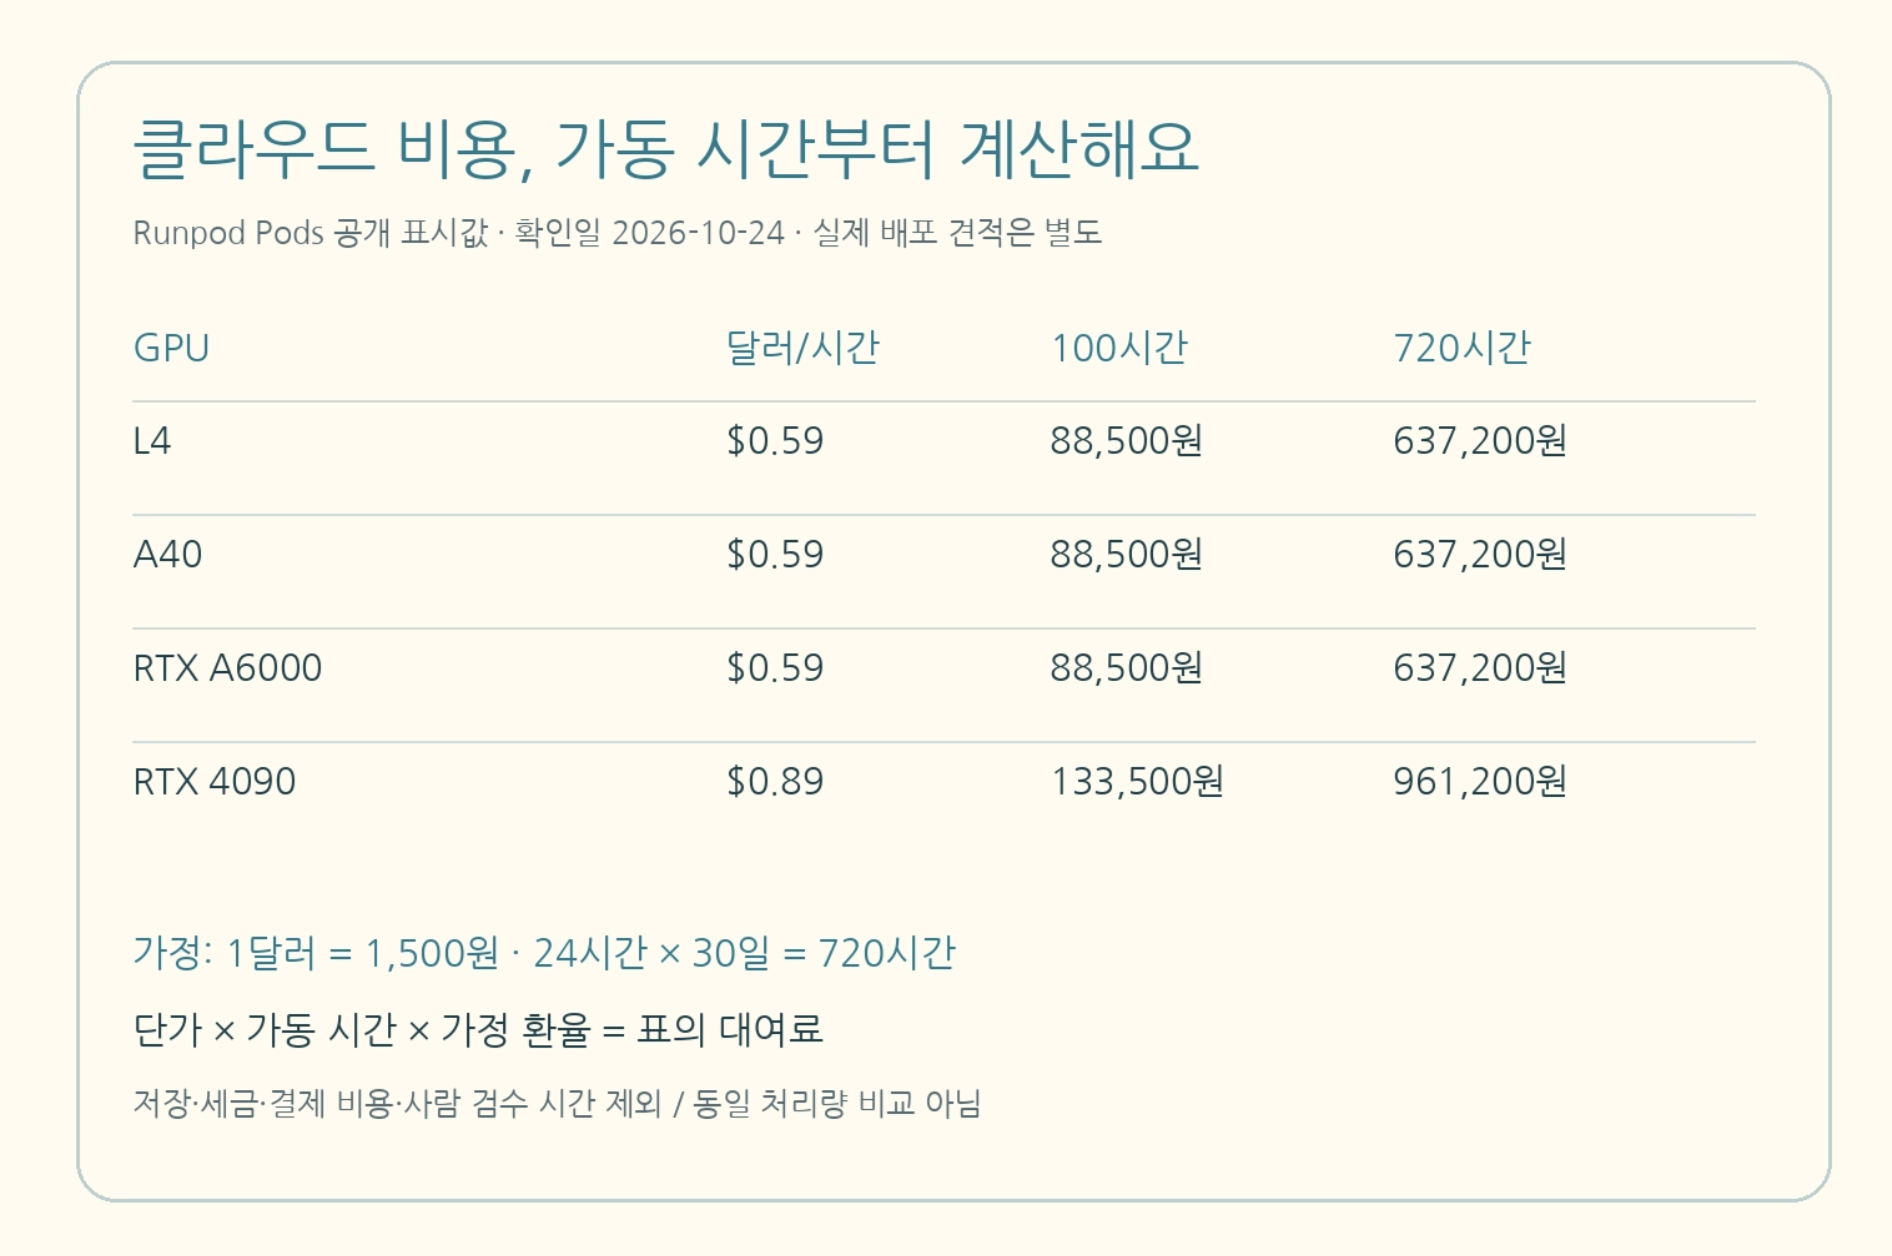
2026-10-24 확인한 Runpod Pods 공개 표시 단가로 계산한 비용 예시. 환율·시간 가정과 제외 비용을 함께 표시했습니다.
| GPU | 공개 표시 단가 | 100시간 가동 시 | 720시간 가동 시 |
|---|---|---|---|
| L4 | $0.59/시간 | 88,500원 | 637,200원 |
| A40 | $0.59/시간 | 88,500원 | 637,200원 |
| RTX A6000 | $0.59/시간 | 88,500원 | 637,200원 |
| RTX 4090 | $0.89/시간 | 133,500원 | 961,200원 |
계산식은 시간당 단가 × 가동 시간 × 가정 환율입니다. 위 표는 GPU 대여료의 계산 예시이며 저장공간·환전/결제 비용·세금 등 추가 항목과 사람의 검수 시간은 포함하지 않았습니다. GPU 이름이 다르므로 같은 시간에 같은 양을 처리한다는 뜻도 아닙니다.
집 PC는 평균 소비전력을 200W라고 가정하고 하루 8시간씩 30일 켜면 48kWh입니다. 실제 기기에서 측정한 값이 아니며, 원화 전기료는 가정 전체 사용량·요금 조건에 따라 달라져 여기서는 확정하지 않았습니다.
따라서 ‘PC 전기료만’과 ‘클라우드 대여료’를 나눠 몇 배 저렴하다고 결론 내리지 않습니다. 준비·실행·재시도·검수·저장까지 걸린 총시간도 함께 남겨야 합니다.
6. 모델을 돌리기 전에 만들 기록표
처음부터 큰 평가 세트를 약속하기보다, 짧은 자료 몇 개로 기록표가 작동하는지 확인하는 것부터 시작하려 합니다. 여기서 ‘몇 개’는 임상 검증에 충분한 표본 수라는 뜻이 아닙니다.
남길 항목은 다음과 같습니다.
- 자료 ID와 과제·녹음 조건: 실명 등 불필요한 식별정보는 기록표에 넣지 않기
- 모델·버전·설정·실행일과 원출력
- 사람이 검토한 표기, 검토자 사이의 불일치와 해결 과정
- 반복·간투사 등의 삭제·추가·대치, 원음 재확인 구간
- 준비·처리·재시도·사람 검수 시간과 메모리 사용량
- 판단할 수 없는 부분, 접근·보관·삭제 조건
실제 음성을 쓰기 전에는 자료 사용 권한·동의 범위와 기관의 처리 조건부터 확인해야 합니다. 이번 호는 가상 텍스트만으로도 연습할 수 있게 구성했습니다.
함께 쓰는 미니 실습팩
가상 전사 비교 문제와 해설, 빈 실험 기록지, 비용 계산지, 복사용 프롬프트를 묶었습니다. PDF는 인쇄해서, 수정용 TSV 양식은 복사해서 사용할 수 있습니다. 실제 음성 없이도 이번 호의 비교와 계산을 연습할 수 있습니다.
이 팩은 학습·개발 기록용이며, 임상 검사나 진단·치료 도구가 아닙니다.
오늘의 작은 과제
- S1에서 두 모델이 함께 빠뜨린 토큰을 찾아 표시해 보세요.
- S3의 청취불명을 문맥으로 채우지 않고 남겨보세요.
- L4를 10시간만 켠다면 대여료가 얼마인지 계산해 보세요. 위 가정에서는 8,850원입니다. 무엇이 빠진 금액인지도 적어보세요.
이 과제에서 확인하는 것은 텍스트 비교와 계산입니다. 음성 인식 성능이나 말더듬 평가 능력을 검증하는 과제가 아닙니다.
마무리 — 모델이 만든 설명 앞에 근거를 남기기
말더듬 AI 분석 도구를 생각하다 보면 큰 모델과 좋은 GPU부터 찾게 됩니다. 하지만 먼저 필요한 것은 조금 더 작고 구체적인 질문이었습니다.
무엇을 보존할 것인가. 무엇을 사람이 다시 들을 것인가. 무엇은 아직 알 수 없는가.
이번 호에서는 모델을 고르는 기준과 비교 기록의 틀을 만들었습니다. 다음 실험에서는 자료를 확보하고 사용 조건을 확인한 뒤, 짧은 음성의 원출력·검토본·수정 시간을 나란히 남기는 과정을 다뤄보려 합니다. 아직 실행 결과가 나온 단계는 아닙니다.
도움이 됐다면 함께 공부하는 전공생·동료에게 공유해주세요. 이어지는 실험 기록은 메일리 ‘소리로 코딩하다’에서 만나실 수 있습니다.
의견을 남겨주세요