| 본 메일은 국가과학기술인력개발원(KIRD)이 발행하는 미래형 교수학습 동향 브리프 구독자와 알파캠퍼스 강사 회원 가운데 수신에 동의하신 분께 발송되었습니다. |
2026.10.22 | No.05 | 구독하기
☝️01. 교육기획자를 위한 Q
🧪 금지해도 쓰고, 허용해도 선을 넘는다
Microsoft Research와 펜실베이니아대 등의 연구진이 ICML 2026 조직위와 함께 진행해 arXiv에 공개한 동료심사 실험은 2가지 정책을 비교했습니다. 보수적 정책은 심사 전 과정에서 LLM을 금지했고, 허용적 정책은 논문과 관련 연구를 이해하고 리뷰 문장을 다듬는 데만 쓰게 하되 강점과 약점을 판단하거나 리뷰 초안을 쓰는 일은 막았습니다.
보수적 정책에 무작위 배정된 논문 1,686편과 허용적 정책을 그대로 둔 논문 15,191편의 채택률은 27.0%와 26.5%로 거의 같았습니다. 허용적 정책 아래 작성된 리뷰가 평균 250자(약 7%) 길었을 뿐, 논문 점수와 심사자 확신도에는 거의 차이가 없었습니다.
눈여겨볼 대목은 심사 뒤 1,486명이 답한 설문입니다. 보수적 정책을 받은 심사자의 22.5%가 LLM을 썼다고 답했고, 허용적 정책을 받은 심사자의 36.5%는 허용 범위를 넘는 용도로 쓴 적이 있다고 답했습니다. 응답자들은 이런 위반의 이유로 과중한 심사 부담과 '어디까지 써도 되는지'에 대한 모호함을 많이 꼽았습니다.
연구진은 사용 방식을 제한하는 규정은 실제로 집행하기 어렵다는 점을 들어, 엄격한 제한보다 규범과 구체적 지침, 적절한 유인을 마련하는 편이 나을 수 있다고 보고, 학회가 검증된 LLM 도구를 직접 제공하는 방안과 사용 내역을 스스로 밝히는 'LLM 사용 신고서' 도입을 제안했습니다. 이 결과가 LLM 사용 자체의 효과가 아니라 정책을 다르게 배정한 효과라는 점도 함께 짚었습니다.
⚖️ 판단을 사람에게 남기는 기준, 국내에서도 나왔다
같은 문제의식은 국내 국가연구개발 현장에도 들어왔습니다. 과학기술정보통신부는 2026년 9월 국가과학기술자문회의 운영위원회 의결을 거쳐 「국가연구개발 AI 연구윤리 가이드」를 내놓았습니다. 가이드는 스스로 'AI 활용을 규제하기 위한 것이 아니'라고 밝히며, 연구자의 책임 있는 활용을 돕는 권고와 자가진단표를 함께 담았습니다.
AI는 도구로 제한되고 결과물의 책임과 권리는 연구자에게 있다는 원칙 아래 사실관계 검증부터 개인정보 보호까지 7대 권고사항을 제시했고, 평가 단계도 따로 다룹니다. 평가자는 연구계획서나 논문 같은 평가 대상 자료를 외부 AI에 입력하지 말아야 하는데, 보안 사항과 개인정보가 밖으로 새어 나갈 위험 때문입니다. 또 AI를 보조로 쓰더라도 자신의 전문 지식과 주체적 판단으로 평가해야 한다고 덧붙입니다. 한국연구재단 같은 전문기관은 이미 평가자가 자료를 AI에 올리는 것을 금지하고 있다고 가이드는 소개합니다.
AI의 판단을 그대로 받아들이기 어려운 이유는 2026년 8월 Scientometrics에 실린 한 소표본 연구에서도 엿볼 수 있습니다. 오스트리아 과학기금(FWF: Austrian Science Fund)에 2021년 제출된 연구제안서 139건을 GPT-4o로 비교해 선정해 보니 실제 심사와 판정이 일치한 비율은 60%로 적지 않았습니다. 다만 판정이 어긋난 경우와 통계적으로 유의하게 관련된 항목은 4개 평가 항목 가운데 '새로움(novelty)' 하나뿐이었습니다. 새롭다고 평가된 제안일수록 심사위원은 선정하고 AI는 떨어뜨리는 경향이 있었습니다.
저자는 특정 기관과 연도, 모델에서 나온 결과라 일반화에는 한계가 있다고 밝히면서도, AI를 평가에 도입할 때는 명시적인 안전장치가 필요하다고 제안합니다.
<과기정통부 AI 활용 연구자 자가진단표(일부)>
1. 허위 참고문헌, 변형된 데이터 및 왜곡된 이미지 등이 포함되지 않도록 검토하고 출처 표기 및 원본 자료를 확인하였는가
2. 연구개발 과정에서 핵심 분석과 판단을 연구자가 직접 수행하여 맥락과 내용, 독창성 및 차별성 등을 검토하였는가
5. AI 도구의 사용 여부, 모델 이름·버전, 활용 기간 및 활용 방법 등을 관련 규정에 따라 투명하게 공개하였는가
8. 보안이 요구되는 자료(예: 미발표 연구 데이터, 원 자료(raw data), 특허 출원 예정 기술 등)를 상용 AI 서비스에 업로드하지 않도록 유의하였는가
연구자의 판단은 금지 조항의 세기만으로는 지켜지지 않습니다. 어디까지 맡기고 어디부터 직접 판단할지를 미리 정해 두고, 제출 전에 스스로 점검하게 하는 절차가 그 자리를 채웁니다.
*아래 버튼을 눌러 KIRD 블로그에서 자세한 내용을 확인하실 수 있습니다.
✌️02. 교육운영자를 위한 Q
⏱️ 짧게 나눈 교육과 바로 쓸 수 있는 도구
영국 고용연금부(DWP: Department for Work and Pensions)와 Skills England가 2026년 6월 펴낸 What Works for AI Upskilling in the UK 사례집에 실마리가 있습니다.
제약기업 Roche는 2025년 하반기 전 세계 직원 10만여 명이 AI 교육을 의무로 이수하게 하면서 세션을 대개 30~45분으로 짧게 짜고, 생산성 목표를 '1인당 주 1시간 이상 절약'으로 정했습니다. 규제 업무 부서에서는 이 목표를 넘어 직원의 약 절반이 AI 도구로 주 4시간 이상을 아꼈다고 보고됐고, 약 4분의 1은 주 1시간가량, 나머지는 1시간 미만을 아꼈습니다. 교육 전에는 이런 절감 효과가 거의 없었다고 합니다.
사례집은 교육과 함께 승인된 AI 도구(Gemini)를 업무 환경에서 바로 쓸 수 있게 열어 둔 점도 배운 내용을 곧바로 적용하게 한 요인으로 꼽았습니다. 이 부서는 AI 챔피언을 중심으로 격주로 자발적인 사례 공유 자리를 열어 매회 150명 안팎이 모였습니다. Roche는 또 챔피언과 함께하는 10명 안팎의 소그룹 채팅방에서 질문하게 하고, 직급 간 위계가 끼어들지 않도록 조를 무작위로 짰습니다.
같은 사례집에는 더 짧은 설계도 있습니다. 교육 기업 100 School의 15 Days of AI 과정은 평일 하루 15분씩 3주, 모두 합쳐 4시간이 안 되는 분량으로 매일 실제 업무 결과물을 하나씩 만들게 합니다. 한 글로벌 전문서비스 기업 인사팀 122명에게 적용하자 첫날 참여율은 88%였고, AI를 자신 있게 정기적으로 쓴다는 응답이 49%에서 86%로 늘었습니다. 임원과 고위 관리자도 학습자로 함께 등록해 다른 참여자와 같은 Slack 채널에 매일 진행 상황을 공유한 점도 눈에 띕니다.
다만 사례집은 이 성과들이 참여 기관(100 School 사례는 교육 제공 기업)이 스스로 보고한 수치로, 독립적으로 검증되지 않았다고 밝히고 있습니다.
📋 보장한 시간이 실제로 쓰였는지 확인하는 장치
시간을 내어 주는 것만큼 그 시간을 실제로 쓸 수 있었는지 확인하는 장치도 필요합니다. 스코틀랜드 정부가 2025년 11월 NHS 스코틀랜드 각 보건위원회에 보낸 학습 시간 보장 지침(Protecting Learning Time)은 AI 교육이 아니라 법정 필수교육에 관한 것이지만, 보장한 시간을 점검하는 방식은 참고할 만합니다. 직원은 매년 필수교육을 근무시간 안에 마칠 수 있었는지 스스로 응답하고, 관리자는 연례 성과와 개발 면담에서 학습 시간을 다루되 개별 답변은 기록하지 않고 면담 완료율로 대화가 이뤄졌는지 확인하는 방식을 제시했습니다(구체적인 응답 형식은 확정 전).
기관은 이 결과를 반기마다 직원거버넌스위원회에 보고하고 해마다 스코틀랜드 정부에도 제출하며, 이행률이 낮으면 개선 계획 수립과 추가 조치로 이어지게 했습니다. 보건위원회마다 달랐던 필수교육을 전국 공통 9개 모듈로 묶어 2026년 3월부터 도입하고, 중복을 줄이려는 계획도 함께 담았습니다.
위 사례들을 바탕으로, AI 교육 과정을 운영할 때 학습 시간을 점검해 볼 항목을 다음과 같이 제안합니다.
<AI 교육 과정의 학습 시간 점검표>
① 교육 목표에 이수율만이 아니라 업무 지표(예: 주당 절약 시간)도 넣었는가
② 한 회차를 15~45분 정도로 짧게 나누고, 회차마다 실제 업무 결과물을 하나씩 만들게 했는가
③ 관리자나 임원이 학습자로 함께 참여하는가
④ 관리자 면담에서 학습 시간을 다루고, 근무시간 안에 마칠 수 있었는지 학습자에게 묻는가
배울 시간은 학습자가 틈을 내서 찾는 것이라기보다, 교육의 단위와 목표, 관리자의 역할을 어떻게 설계하느냐에 따라 만들어진다고 볼 수 있습니다.
*아래 버튼을 눌러 KIRD 블로그에서 자세한 내용을 확인하실 수 있습니다.
👌03. 교수자를 위한 Q
🎭 피드백을 더한 집단만 공감이 줄지 않았다
스탠퍼드대 연구진 등이 2026년 4월 CHI 2026에서 발표한 무작위 실험이 이 질문에 실마리를 줍니다. 초보 상담자 94명이 AI가 연기하는 가상 내담자와 텍스트 채팅으로 상담을 연습했는데, 절반은 연습만 했고 나머지 절반은 응답마다 공감, 반영, 질문 같은 상담 기술(counseling skills) 항목별로 강점과 개선점을 짚고 개선이 필요한 응답에는 대안 응답까지 담은 피드백을 받았습니다.
연습만 한 집단은 공감을 잘 쓴 발화의 비율이 오히려 9.6% 줄었고, 피드백을 받은 집단과는 15%의 차이(효과 크기 d=0.72)가 났습니다. 피드백을 받은 집단만 연습 전보다 반영하기와 질문하기가 유의하게 늘었고, 연습만 한 집단은 뚜렷한 변화가 없었습니다. 다만 이 두 기술은 두 집단 사이의 차이가 통계적으로 뚜렷하지 않았습니다. 연구진은 공감이 줄어든 이유로 AI 내담자가 공감 표현에 따라 반응을 바꾸지 않았다는 점, 그리고 사후 측정에 쓴 내담자가 감정을 덜 드러냈다는 점을 들었습니다.
자기평가의 변화도 눈여겨볼 만합니다. 연습만 한 집단은 탐색 기술 수행이 뚜렷하게 나아지지 않았는데도, 스스로 평가한 탐색 기술은 실제보다 낮게 보던 쪽에서 높게 보는 쪽으로 바뀌었습니다. 다만 이 변화는 피드백 집단과 비교했을 때 유의한 차이가 아니었고, 결과 전체가 75분짜리 1회 세션에서 측정한 단기 효과입니다.
연구진은 연습만으로는 부족하지만, AI가 주는 구조화된 피드백을 더하면 사람 지도자를 구하기 어려운 상황에서도 넓혀 갈 수 있는 훈련 방법이 된다고 보았습니다.
🔁 피드백을 선택으로 둘지, 기본 단계로 둘지
Amazon의 사용 기록에서는 관리자들이 이 도구를 어떻게 썼는지 볼 수 있습니다. 관리자들은 가장 어려운 면담을 앞두고 골라 썼고(연습 대상이 된 관리자와 직원 쌍의 43.3%가 최저 성과 등급 직원과의 면담), 재방문율은 22%였습니다. 연습을 시작한 세션 가운데 36%가 음성 대화를 끝까지 마쳤고, 그중 23%는 피드백까지 요청했습니다.
연구진은 이를 첫 진입 장벽을 넘은 사용자가 점점 깊이 참여하는 흐름으로 읽었고, 이용 실적만으로 코칭 효과를 입증할 수는 없다고도 밝혔습니다. 평가 마감 직전 2주에는 사용량이 기간 평균의 4배까지 치솟았습니다. 연구진은 이를 역량을 기르는 연습이라기보다 필요한 때 골라 쓰는 면담 직전의 준비로 보았습니다.
이 도구의 피드백은 대화를 마친 뒤 요청하는 방식이었고, 말의 내용과 규정 준수를 다룰 뿐 공감이나 어조 같은 전달 방식은 아직 다루지 않습니다. 앞의 상담 실험에서 공감의 차이와 연결된 것이 기술 항목별 피드백이었던 만큼, 피드백을 선택으로 둘지 연습의 기본 단계로 넣을지는 교육 설계에서 따로 정해야 할 문제로 볼 수 있습니다.
피드백을 누가 어떻게 다룰지도 정해야 합니다. 2026년 6월 Advances in Simulation에 실린 의료 시뮬레이션 디브리핑 논문은 AI가 디브리핑을 보강하는 4가지 방식을 정리하면서, 그중 학습자와 직접 대화하는 챗봇 디브리퍼에 대해서는 앞선 연구들을 인용해 이 방식이 지나치게 긍정적이거나 아첨하는 반응을 보이는 경향이 있어 성찰의 깊이에 영향을 줄 수 있다고 짚었습니다. 다만 그런 경향 속에서도 학습자들이 비판적 성찰을 이어 간 경우가 많았다고 덧붙였습니다. 이 논문은 AI가 대화록을 분석해 사건 요약과 디브리핑 안건, 질문 예시를 내놓는 보조 방식도 소개하고, 어떤 방식이든 사람의 감독이 필요하며, 대화록 분석 보조 방식에서는 결과물을 해석하는 권한을 진행자나 학습자가 갖는다고 강조했습니다.
두 연구와 사용 기록을 바탕으로, AI 롤플레이 실습을 설계할 때 확인해 볼 항목을 다음과 같이 제안합니다.
<AI 롤플레이 실습을 설계할 때 확인할 4가지>
① 피드백할 기술 항목(예: 공감, 반영, 질문)을 실습 전에 정했는가
② 피드백을 선택 버튼이 아니라 연습마다 반드시 거치는 기본 단계로 넣었는가
③ 학습자가 스스로 매긴 평가와 실제 대화록을 비교해 보는 순서가 있는가
④ 대화록 요약과 질문 초안은 AI에 맡기고, 어떤 질문을 던지고 어떻게 해석할지는 교수자가 정하도록 했는가
AI 롤플레이가 실제 역량으로 이어지는지는 연습 상대가 얼마나 그럴듯한지만큼이나, 연습하는 동안과 그 뒤에 무엇을 어떻게 돌아보게 하느냐에 달려 있다고 볼 수 있습니다.
*아래 버튼을 눌러 KIRD 블로그에서 자세한 내용을 확인하실 수 있습니다.
이달의 Q레이션, 어떻게 보셨나요?
앞으로도 함께 들여다보면 좋을 질문이 있다면 들려주세요!
보내 주시는 이야기 하나하나가 다음 호의 Q가 됩니다.
<미래형 교수학습 동향 뉴스레터>로 11월 첫 번째 월요일에 다시 찾아뵙겠습니다.
📮 <미래형 교수학습 동향 브리프> 5호가 나왔어요!
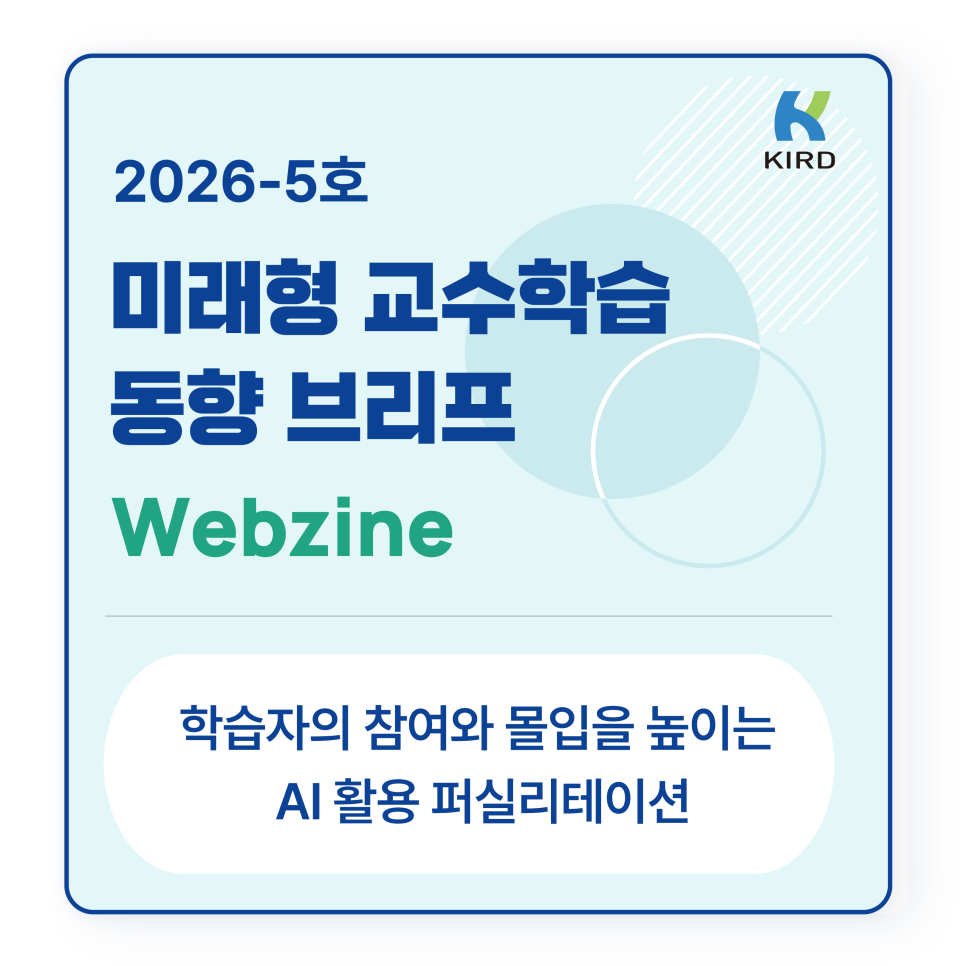
지난 6일 발행된 5호의 주제는 바로 <학습자의 참여와 몰입을 높이는 AI 활용 퍼실리테이션>!
"AI로 누구나 혼자 학습하는 지금, 함께 학습하는 시간을 가치 있게 만들려면 어떻게 해야 할까요?"
AI 에이전트가 협력학습에서 맡는 세 기능부터 퍼실리테이터 714명이 말한 '학습 임팩트'의 빈틈, 대면 시간의 쓰임새를 다시 정한 대학들의 사례까지!
여러분의 인사이트를 한 발 앞서게 할 최신 이야기들이 궁금하시다면
아래 웹진에서 확인해 보세요 🔎
- 10.30(금) | 학습분석학 시대의 자기조절학습: 이론, 증거, 그리고 미래 방향 | 서울
- 11.04(수) ~ 05(목) | 글로벌 인재포럼 2026 | 서울
- 11.04(수) ~ 06(금) | DevLearn Conference & Expo 2026 | 미국 라스베이거스
- 11.06(금) | AI Connect 2026 컨퍼런스 | 서울
- 11.20(금) | 2026 한국인력개발학회 추계학술대회: Human-AI Collaboration | 서울
- 11.26(목) ~ 28(토) | AI EDU EXPO 2026 | 청주
🌐 미래형 교수학습 동향, 더 가까이 만나기
전 세계 교수학습·HRD의 모든 동향을 한눈에! - 미래형 교수학습 동향 아카이브
기타 문의 - 📧 hspark@kird.re.kr
※ 구독 취소 안내
본 뉴스레터 수신을 중단하시려면 [KIRD 구독 취소 신청 폼]에서 신청해 주세요. 메일 최하단 'unsubscribe' 링크는 메일리(maily) 사이트에서 직접 구독하신 분들만 해당됩니다.

의견을 남겨주세요