안녕하세요, 이든이에요. 2024년 6월, 이 레터에 ChatGPT 안의 GPTs 열 개를 나란히 적어 두고 "이거면 된다"고 소개한 적이 있어요. 오늘은 그 목록 자리에 제 작업장을 열어 둘게요.
💡 2년 전엔 챗봇 열 개, 지금은 작업장 하나
그때 목록은 ChatPRD, Diagrams Show Me, Copywriter GPT, 네이버와 구글 SEO 글쓰기 도우미 같은 열 개였어요. 전부 프롬프트가 미리 설계된 챗봇이었고, 같은 호에서 CRISP-PM(Clear, Role, Intent, Specific, Process)을 처음 꺼냈죠.
지금 쓰는 도구는 질문에 답하는 데서 멈추지 않아요. 일을 맡기면 파일을 만들고, 명령을 실행하고, 브라우저를 조작합니다.
그럼 프롬프트는 이제 덜 중요할까요? 여전히 중요해요. 다만 에이전트는 프롬프트 한 장보다 그 주변에 적어 둔 규칙과 권한을 더 오래 따릅니다.
이 레터를 만드는 일도 요즘 조금씩 그 작업장 안으로 옮기는 중이에요.
정리하면, 2026년판은 도구 목록이 아니라 작업장 사용법이에요.
🗺️ 제 작업장은 이렇게 생겼어요
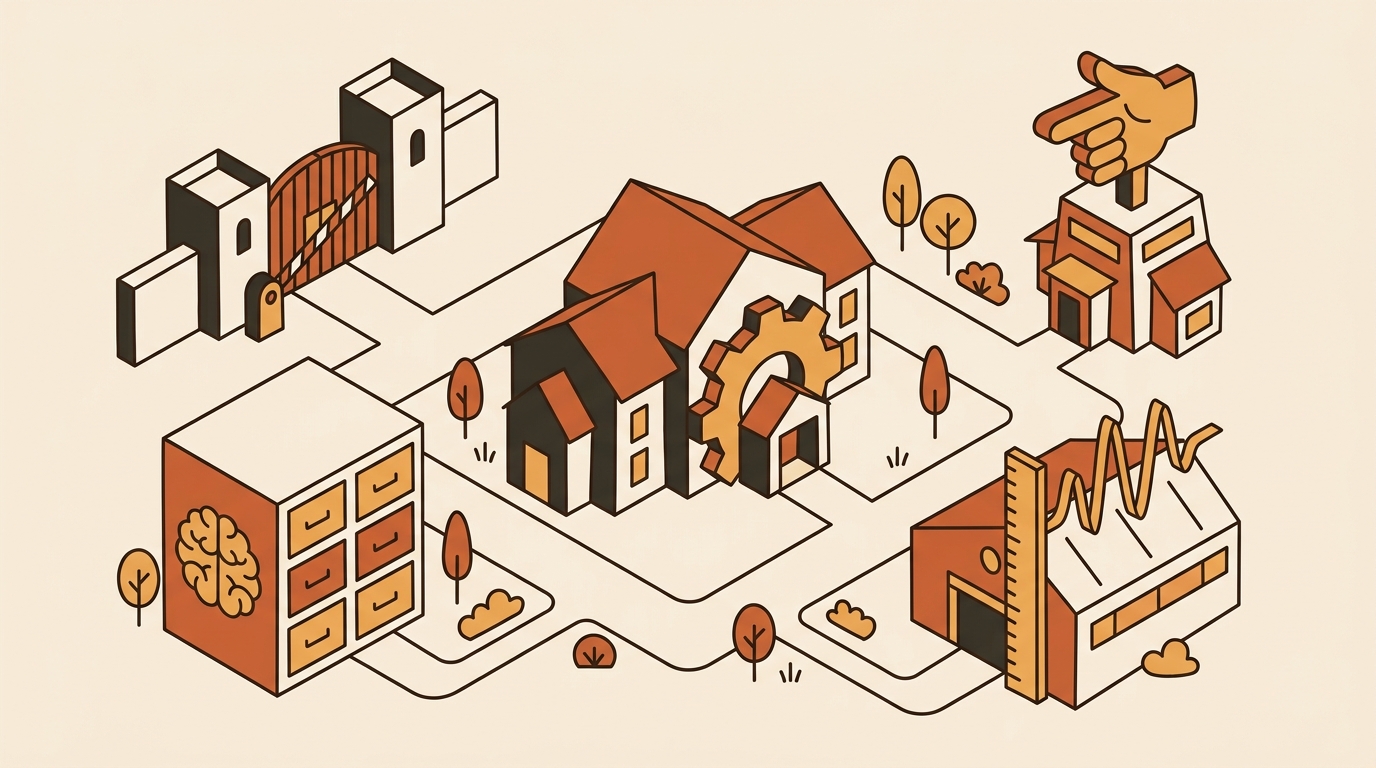
도구는 여섯 개이고, 맡은 역할이 전부 달라요.
| 역할 | 도구 | 제가 만든 것 |
|---|---|---|
| 본진 | Claude Code | CLAUDE.md 규칙 9개, 서브에이전트 26개, 스킬 58개, 훅 |
| 두 번째 눈 | Codex CLI | 적대 리뷰 절차 |
| 손 | Claude in Chrome | Maily 초안 업로드 절차, 계정 권한 표 |
| 게이트 | hplan(공개 저장소) | Evidence→Product→Build 3게이트 |
| 기억 | llm-brain(공개 저장소) | raw→wiki 컴파일, 5층 메모리 |
| 저울 | signal-to-growth(공개 저장소) | AI 검색 인용 측정 스킬 14개 |
가운데 열은 누구나 설치할 수 있어요. 여러분 작업장의 오른쪽 열에는 무엇이 적혀 있나요?
도구만 좋으면 오른쪽은 비어도 될 것 같죠. 저도 그렇게 시작했는데, 지난 호 실험에서 같은 모델의 완료율이 46.7%와 66.7%로 갈린 자리가 바로 오른쪽이었어요. 모델은 직원이고, 작업장은 제가 짓습니다.
🛠️ Claude Code: 규칙 9개가 관리자를 대신해요
홈 폴더의 CLAUDE.md는 모든 세션이 시작할 때 먼저 읽는 파일이에요. 프로젝트마다 같은 잔소리를 되풀이하지 않으려고 만들었어요.
규칙 9개, 전문 공개
- 생각 먼저: 가정을 적고, 모호하면 추측 대신 묻는다. 해석이 둘이면 둘 다 보이고 사람이 고른다.
- 최소 코드: 요청을 푸는 만큼만. 나중을 위한 기능은 만들지 않는다.
- 외과적 수정: 필요한 곳만 손대고, 안 깨진 것은 두고, 산출물이 아니라 원본을 고친다.
- 목표 주도 실행: "exit 0", "HTTP 200", "Deployed"는 완료 증거가 아니다. 라이브 URL과 브라우저를 직접 본다.
- 결정은 사람이, 생성은 모델이: 가격, 고객 약속, 범위(무엇을 뺄지)는 사람이 쥔다.
- 테스트는 의도를 검증: 로직이 바뀌어도 안 깨지는 테스트는 잘못 쓴 것이다.
- 매 단계 체크포인트: 한 일, 검증된 것, 남은 것을 적는다. 채팅 스크롤은 기록이 아니다.
- 실패는 크게: 미검증이 하나라도 있으면 "완료"라고 쓰지 않는다.
- 범위와 가역성: 삭제, 배포, 결제는 멈추고 사람 승인. 되돌리기 쉬운 일만 넓게 맡긴다.
파일 마지막 줄은 "이 파일은 내 Override가 쌓여 만들어진다"예요. Override는 AI가 낸 결과를 사람이 뒤집은 순간이고, 아홉 개 전부 그 순간을 옮겨 적은 거예요.
처음부터 규칙을 잘 설계하면 되지 않냐는 반박이 있어요. 솔직히 저도 그렇게 시작했는데, 머리로 먼저 쓴 규칙은 지켜지지 않았어요. 되돌린 기록을 옮겨 적은 규칙만 남았습니다.
서브에이전트 26개와 소재 투표
홈 폴더 agents/에는 역할별 에이전트가 26개 있어요. 몇 개만 보면 이래요.
- content-marketer: 후킹, 카피, AEO(AI 답변 노출) 설계
- pm-discovery-mentor: Discovery, ICP, JTBD 같은 PM 사고 검토
- harness-engineer: 스킬, 훅, 서브에이전트 구현
- geo-growth-engineer: habix.ai GEO 감사와 개선
- tax-manager: 부가세, 세금계산서 준비
소재를 정할 때는 콘텐츠 마케터, PM 멘토, GEO 엔지니어 셋에게 후보에 투표하게 해요. 혼자 고르면 쓰고 싶은 것만 고르게 되거든요.
스킬, 훅, 그리고 3라운드 상한
스킬 58개 중 매일 여는 건 네 개예요.
- /today: 오늘 맥락과 다음 행동 불러오기
- /wrapup: 세션 마무리, 배운 것과 메모리 변경 제안
- /newtask-prd: 에이전트 작업에 PRD 강제
- /socratic-question: 시키기 전에 AI가 나를 먼저 심문
훅(특정 순간에 자동으로 도는 스크립트)은 배포 뒤 push 안 된 커밋이 남으면 경고를 띄워요. 훅은 안전망이고, 판단은 규칙 9가 쥡니다.
Ralph Loop는 수정, 재검증, 처음 보는 에이전트의 재채점을 반복하는 절차예요. 대상 하나당 3라운드가 상한이고, 결함 0을 끝까지 쫓지 않고 상한에 닿으면 사람이 끝냅니다.
이번 주 실패담: 20분 퇴고 루프
글 초안을 claude -p(대화창 없이 한 번에 실행하는 모드)에 맡기면서 도구를 켠 채 "9,000~10,500자"라는 조건을 줬어요. 모델이 초안을 파일로 쓰고 글자 수를 세며 고치기를 반복했어요.
20분 넘게 출력이 없어 두 번 종료했고, 도구를 끄자(--tools "") 바로 끝났습니다. 측정할 수 있는 목표를 주면 에이전트는 도구로 재기 시작해요.
에이전트에게 숫자 목표를 줄 때 도구를 켜 두고 계신가요? 그 뒤로 글은 도구를 끄고 쓰게 해요.
👉 Claude Code · 플레이북 ch02: 작업장 차리기
👀 Codex는 두 번째 눈이에요
Codex는 주력이 아니에요. 돈이 오가는 경로(결제, 주문)와 되돌리기 어려운 변경에만, Claude 에이전트가 통과시킨 뒤 한 번 더 적대 검토를 맡깁니다.
7월 4일 결제 코드가 그랬어요. Claude 에이전트 5개가 전원 GO를 냈는데, Codex가 CRITICAL 1건을 포함해 4건을 더 찾았어요.
결함은 멱등성 처리(같은 요청이 두 번 와도 한 번만 처리하는 장치)에 있었어요. 동시 중복은 막았지만 실패한 뒤의 재시도까지 영구히 막고 있었죠. 네 라운드를 돌리자 발견 수가 4→2→1→1→0으로 줄었습니다.
Claude 다섯이면 충분하지 않냐고 할 수 있어요. 그런데 같은 계열 에이전트는 같은 사각지대를 공유해요. 설계 판단이 걸린 지적은 사람이 정합니다.
팀의 결제 코드는 몇 개의 서로 다른 눈을 거치나요? 정리하면, 두 번째 엔진의 가치는 성능이 아니라 다른 눈이에요.
👉 Codex CLI · hplan_codex
🚧 hplan: 만들기 전에 묻는 게이트
hplan은 무엇을 만들지를 코드보다 먼저 판단하게 하는 PM용 Build Gate예요. Claude Code 플러그인 묶음이고, 8월 16일 v1.2.0을 공개했어요.
| 게이트 | 보는 것 |
|---|---|
| Evidence | 경쟁 조사, ICP, JTBD, 인터뷰 킷, 5명 중 3명의 강한 Push 패턴 |
| Product | 문제 정의, 기회 트리, 사용자 여정, 사이트맵 |
| Build | 판정: build, interview, pivot, hold, CONDITIONAL_GO |
게이트마다 리뷰어 에이전트가 따로 심사해 결정 로그에 남기고, 사람 승인 지점은 hitl로 표시해요.
첫 장면은 외국인 근로자 한국어 앱이에요. 영어회화 앱에서 출발해 네 번 피벗한 끝에, 학습자는 일터 한국어를 얻고 고용주는 안전 이해 증빙을 사는 B2B2C 구조에 닿았어요.
판정은 HOLD였습니다. "이해 증빙이 중대재해처벌법 면책이 된다"는 가정의 법적 성립과 고용주 지불 의사가 미검증이었거든요.
두 번째는 habix.ai 플레이북 첫 사용자 루프예요. 5명에게 직접 씨딩해 3~4명이 성공(미확정)했고, 결정은 HOLD(DEC-20260810-001)였어요. 재개 조건은 셋이에요.
- 성공률 60% 이상 확정
- 자발적 재참여 1명
- 문의 폼에 "누구 소개로" 필드 계측
빌더 입장에선 일단 만들어 보는 게 빠르다는 말이 맞아요. 그런데 에이전트가 빨라질수록 실패는 "만들 수 있나"가 아니라 "만들어야 하나"에서 나요. 지금 진행 중인 일 중에 재개 조건을 적어 둔 HOLD가 하나라도 있나요?
hplan은 만드는 속도가 아니라 멈추는 속도를 위한 도구예요.
👉 hplan
🧠 llm-brain: 폴더가 기억하게
llm-brain은 raw 폴더의 원문(뉴스, 대화, 문서)을 LLM이 위키로 컴파일하는 개인 지식 컴파일러예요. 공개 저장소로 스타 10개를 받았어요.
테스트 514개가 다 통과했으니 끝인 줄 알았어요. 위키 109페이지로 첫 실운영을 돌리자 종합 큐가 103건으로 터져 상한 15건을 뒀어요. 실데이터 첫 실행은 테스트와 별개의 검증 단계예요.
매일 모은 뉴스와 대화가 여기서 증류되고, 이 레터의 소재 후보도 그 위키의 주제 색인에서 나와요. 같은 자료를 몇 번째 다시 검색하고 계신가요?
Karpathy는 gist "llm-wiki.md"(2026-04-04)에 이렇게 적었어요.
"지식은 한 번 컴파일하고 최신으로 유지한다, 질문마다 다시 만들지 않는다(The knowledge is compiled once and then kept current, not re-derived on every query)."
Karpathy가 먼저 적었고, 저는 같은 문제를 겪다 같은 자리에 닿았어요. 다음 절은 그 위키가 밖에서 어떻게 보이는지 재는 얘기예요.
👉 llm-brain · Karpathy, llm-wiki.md
📏 signal-to-growth: 인용되는지 재기
2024년 목록의 네이버, 구글 SEO 글쓰기 GPT 자리를 잇는 게 signal-to-growth예요. 우리 페이지가 ChatGPT, Perplexity, Google AI 요약에 인용되는지 재고 고치는 스킬 14개 묶음이에요.
AI 답변은 돌릴 때마다 달라서, 한 번 잰 점수는 소수점만 그럴듯한 숫자예요. 그래서 여러 번 돌려 중앙값과 범위로 적어요. "최초", "유일한" 같은 마케팅 형용사는 노이즈로 걸러져 오히려 인용을 낮추고요.
스키마는 문법만 맞으면 되는 줄 알았어요. 8월 29~30일 habix.ai의 Person 타입에 평점 스키마를 달았다가 Google 리치 결과 무효를 받았거든요.
지원 타입에 Person이 없었고, 마크업을 빼니 하루 만에 통과했어요.
지금 habix.ai는 GEO 점수 55→60 안팎, 색인 20/43(8월 30일 감사)이에요. 페이지 절반 이상이 아직 검색 밖이라는 뜻이에요.
Pew Research Center(2025-07-22)는 AI 요약이 뜬 방문의 링크 클릭이 8%, 요약이 없으면 15%라고 집계했어요. 요약이 뜨면 클릭이 절반 가까이 준다는 얘기예요.
우리 회사 페이지가 ChatGPT 답변에 한 번이라도 인용된 적 있는지, 확인해 보신 적 있으세요? 제가 매주 보는 숫자는 순위가 아니라 인용 횟수예요.
👉 signal-to-growth · Pew Research Center
✋ Claude in Chrome: 손을 빌려주는 대신 계정을 넘기는 일
8월 26일 일반 공개된 Claude in Chrome은 이미 로그인해 둔 세션을 그대로 쓰는 방식(using your existing logins)이에요. 공식 블로그가 든 대상은 사내 대시보드, 레거시 시스템, 벤더 포털이고요.
Maily 작업을 맡길 때 이렇게 써요. 로그인된 브라우저에서 에이전트가 구독자 87명의 오픈 이력을 모으고, 초안의 본문, 표, 이미지를 올립니다. 아이디와 비밀번호는 넘긴 적이 없어요.
함정은 두 번 만났어요. 에디터가 "CLAUDE.md"를 도메인으로 착각해 자동 링크를 걸었는데, 새로고침 검증에서 잡았어요.
다른 하나는 제가 열어 둔 탭의 자동 저장이 에이전트의 저장을 덮은 일이에요. 같은 문서를 사람과 에이전트가 동시에 열면 마지막 저장이 이깁니다.
비밀번호를 안 줬으니 안전하다고 할 수 있어요. 그런데 로그인 세션을 쓴다는 건 그 계정의 권한을 통째로 빌려준다는 뜻이에요. 그래서 새 프로젝트에선 프롬프트보다 계정 권한 표를 먼저 만들어요.
| 확인할 것 | 예시 |
|---|---|
| 어느 계정으로 | 뉴스레터 운영 계정 |
| 어느 사이트에 | Maily 에디터 |
| 읽기인가 쓰기인가 | 통계는 읽기, 초안은 쓰기, 예약 발행은 사람 |
지금 브라우저에 로그인된 계정 중 에이전트에게 쓰기까지 맡겨도 되는 곳은 몇 개인가요? 그런데요, 이 질문이 곧 다음 절의 원칙이 돼요.
📝 위임 3원칙
2024년의 CRISP-PM이 프롬프트를 설계하는 틀이었다면, 이건 맡길 것과 쥘 것을 가르는 틀이에요.
원칙 1. 결정은 사람이, 생성은 모델이
가격, 고객 약속, 범위(무엇을 뺄지)는 사람이 쥐어요. 분류, 초안, 요약, 추출, 생성은 모델에 넘겨요.
예: 소재 후보를 고를 때 점수는 코드가 매기고, 선택은 제가 해요.
원칙 2. 되돌릴 수 있는 일만 넓게 맡긴다
삭제, 배포, 결제, DB 스키마 같은 일방향 문은 실행 전에 멈춰 승인받아요. 초안, 시안, 실험은 넓게 맡겨요.
예: 초안 업로드까지는 에이전트가 하고, 예약 발행 버튼은 제가 눌러요.
원칙 3. 도구의 성공 신호를 완료 근거로 쓰지 않는다
HTTP 200, "Deployed", 테스트 통과, exit 0은 증거가 아니에요. 실제 상태를 다시 읽은 것만 완료예요.
예: 에디터가 "저장됨"을 띄워도 새로고침해서 문단을 다시 확인해요. "저장됨" 뒤에 문단이 비어 있던 적이 있거든요.
세 줄은 너무 단순해 보이죠. 그런데 이번 호에 적은 사고는 전부 이 셋 중 하나를 건너뛴 자리에서 났어요. 위임 전에 묻는 세 가지예요.
- 이 일은 되돌릴 수 있나요?
- 이 결정은 사람이 쥐어야 하나요?
- 완료를 무엇으로 확인하나요?
🔁 2024년과 2026년, 한 표로
한 표로 모으면 이래요.
| 구분 | 2024년 | 2026년 |
|---|---|---|
| 도구의 형태 | GPTs(챗봇) | 에이전트(파일·명령·브라우저) |
| PM의 입력 | 프롬프트 한 장 | 작업장(규칙 파일, 서브에이전트, 스킬, 권한 표) |
| 실패 방식 | 답이 틀림 | "됐다"고 하는데 안 됨(조용한 실패) |
| 프레임워크 | CRISP-PM(프롬프트) | 위임 3원칙(맡길 것과 쥘 것) |
| 검증 | 답을 읽어봄 | 실제 상태를 다시 읽음 |
가장 크게 바뀐 건 마지막 줄이에요. 답을 읽던 눈이 상태를 다시 읽는 눈이 됐습니다.
🎯 오늘의 한 줄
프롬프트는 한 번 쓰고 끝나지만, 작업장은 되돌린 기록만큼 자라요. 모델을 바꾸기 전에 규칙 파일부터 한 줄 늘려 보세요.
이번 주에 AI 결과를 되돌린 순간 하나를 골라, 그 이유를 한 줄로 적어 두세요.
📮 이번 주 질문
에이전트가 "됐다"고 했는데 실제로는 안 됐던 순간, 최근에 있으셨나요? 무엇으로 알아채셨는지 답장으로 들려주세요.
월요일 할 일: 지금 쓰는 에이전트 프로젝트 폴더에 CLAUDE.md 한 장을 만들고, 위 규칙 9개 중 세 개를 골라 내 말로 옮겨 적기. 10분이면 돼요.
이든 드림 · AI 네이티브 PM · Agentic AI 제품 리드
🔗 출처
Harness Engineering ch01: 똑똑한 AI가 일을 끝내지 못하는 이유
의견을 남겨주세요