1.뉴스
마비 환자가 말과 몸짓을 동시에 아바타로 내보낼 수 있게 되었습니다. 미국 스미스소니언 협회가 내는 Smithsonian Magazine은 2026년 10월 6일, 미국 캘리포니아대 샌프란시스코(UCSF) 연구진이 개발한 뇌 임플란트가 사용자의 말과 동작을 가상 아바타에 실시간으로 옮긴다고 전했습니다. 연구는 9월 14일 학술지 Nature Neuroscience에 실렸습니다.
기사가 짚은 새로움은 「동시에」라는 말에 있습니다. 지금까지의 실험적 뇌·컴퓨터 인터페이스는 대체로 말이면 말, 동작이면 동작 한쪽만 다루어 왔습니다. 이번 장치는 두 참여자의 감각운동 피질 위에 놓인 전극 253개짜리 판 하나로 둘을 함께 읽었습니다. 참여자들은 「hello」, 「nice to meet you」 같은 구절과 박수, 손 흔들기 같은 몸짓을 시도했고, 해독된 말은 화면에 글자로, 몸짓은 참여자에게 맞춘 전신 아바타의 동작으로 나타났습니다.
기사는 연구의 공동 저자 서맨사 브로슬러(Samantha Brosler)의 말도 옮겼습니다. “Saying ‘maybe’ and nodding your head has a very different connotation than if you shake your head.” ‘아마도’라고 말하면서 고개를 끄덕이는 것과 고개를 젓는 것은 뜻이 아주 다르다는 것입니다. 같은 말이라도 어떤 몸짓과 함께 오느냐에 따라 다른 말이 된다는 이 지적이, 이번 회차가 따라갈 출발점입니다.
2.공개된 구성
논문의 제목은 「Simultaneous speech and gesture decoding for multimodal communication in paralysis」입니다. 마비 상태에서의 멀티모달 소통을 위한 말과 몸짓의 동시 해독이라는 뜻입니다. 논문은 말과 몸짓을 각각 하나의 modality로 부릅니다. M4의 자리에서 보면 이 둘은 Modality가 아니라 Mode입니다. 논문은 누구나 읽을 수 있게 공개되어 있습니다.
참여자는 세 사람이고, 논문은 이들을 Bravo-1r, Bravo-3, Bravo-6이라는 식별명으로 부릅니다. 세 사람 모두 뇌졸중이나 근위축성 측삭경화증으로 알아들을 수 있는 말을 잃었습니다. 세 사람의 신호로 여러 신체 부위의 움직임을 읽을 수 있는지 먼저 확인했고, 말과 몸짓의 동시 해독은 Bravo-1r과 Bravo-6 두 사람과 진행했습니다. Bravo-6에게는 구절 10개와 몸짓 10개, 그리고 둘을 짝지은 100개의 조합을 썼고, Bravo-1r에게는 구절 5개와 몸짓 4개, 조합 12개를 썼습니다.
말을 읽는 해독기와 몸짓을 읽는 해독기는 따로 있고, 같은 전극판의 신호를 나란히 받아 동시에 작동합니다. 연구진은 세 가지 상황의 데이터를 모았습니다. 말만 시도하는 경우, 몸짓만 시도하는 경우, 그리고 둘을 함께 시도하는 경우입니다.
첫 결과는 다음과 같습니다. 말만, 몸짓만 따로 시도한 데이터로 학습한 해독기는 둘을 함께 시도하는 상황에 저절로 맞지 않았습니다. 따로 학습한 해독기는 함께 시도한 말과 몸짓을 아무것도 하지 않는 「쉼」으로 잘못 읽는 비율이 Bravo-6에서 14.5퍼센트, Bravo-1r에서 34.9퍼센트까지 올랐습니다. 따로 하는 데이터와 함께 하는 데이터를 모두 학습하자 이 비율은 각각 1.0퍼센트와 4.5퍼센트로 내려갔습니다.
실시간 대화 과제의 결과도 공개되었습니다. 실험자가 말을 걸면 참여자가 말과 몸짓으로 답하는 과제에서, Bravo-6은 다섯 블록 평균으로 몸짓 85.0퍼센트, 말 75.0퍼센트의 정확도를 보였고, Bravo-1r은 세 블록에서 두 해독기 모두 중앙값 100퍼센트를 기록했습니다. 논문은 스스로의 한계도 적었습니다. 어휘가 제한되어 있고, 함께 시도하는 상황으로의 일반화가 아직 불완전하며, 참여자 수가 적다는 것입니다. 신경 데이터는 임상시험 규정에 따라 심사를 거쳐 제한적으로 제공되고, 코드는 공개되어 있습니다.
3.같은 사태를 네 자리로 다시 세운 표
M4는 경험을 네 자리로 나누어 읽습니다. 감각과 표현의 자원이 모드(Mode)이고, 그 자원이 실현될 때 걸리는 조건과 태도가 모달(Modal)이며, 둘이 결합해 정서와 행동과 정체성까지 아우르며 성립하는 총체적 경험 구조가 모달리티(Modality)입니다. 이 모든 과정이 실현되는 환경적·기술적·사회적 기반이 미디엄(Medium)입니다. 미디엄이 모드와 모달이 설 수 있는 범위를 정하고, 그 안에서 모드와 모달이 결합해 모달리티를 낳으며, 그렇게 생긴 모달리티가 다시 미디엄을 고쳐 달라고 요구하는 순환을 이룹니다.
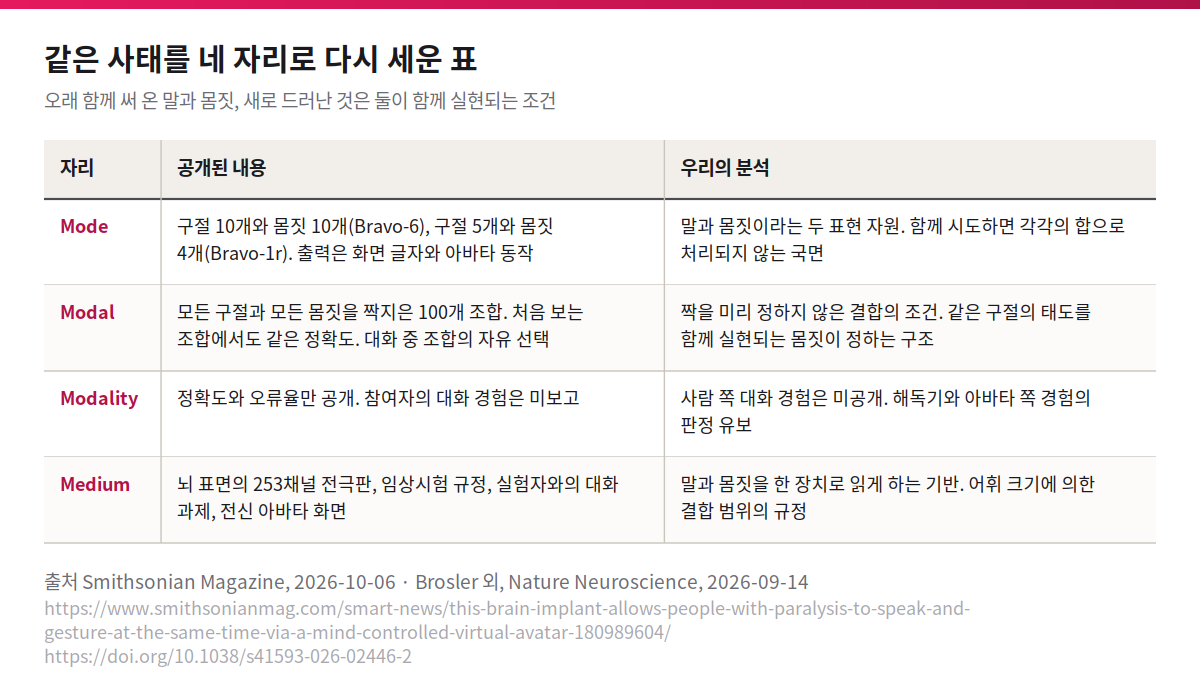
이 표에서 무게가 실리는 자리는 Modal입니다. 말과 몸짓은 사람이 늘 함께 써 온 자원입니다. 이 연구가 드러낸 것은 새로운 자원이 아니라, 두 자원이 함께 실현될 때 그 결합이 어떤 조건 아래 놓이는가입니다.
4.Mode · 말과 몸짓이라는 두 자원
이 사례의 Mode는 둘입니다. 하나는 「hello」나 「nice to meet you」 같은 구절이고, 다른 하나는 손 흔들기나 박수 같은 몸짓입니다. 출력 쪽에서는 이 둘이 화면의 글자와 아바타의 동작이라는 다른 모습으로 다시 나타납니다.
두 자원은 처음부터 따로 다루어졌습니다. 해독기도 둘이고, 학습한 어휘도 구절 목록과 몸짓 목록으로 나뉘어 있습니다. 여기까지만 보면 말과 몸짓은 각자의 자리에 놓인 두 자원이고, 두 해독기가 각자의 몫을 읽어 내면 그것으로 충분해 보입니다.
그런데 결과는 그렇지 않았습니다. 따로 시도한 말과 몸짓을 잘 읽던 해독기가, 둘을 함께 시도하자 그 시도를 쉼으로 놓쳤습니다. 논문은 이것을 각 행동의 신경 패턴이 따로 할 때와 함께 할 때 사이에서 달라지기 때문이라고 해석합니다. 이 해석은 신경 신호에 관한 것이고, M4의 층위를 직접 가리키지는 않습니다. 다만 이 결과가 알려 주는 사실 하나는 분명합니다. 말과 몸짓을 함께 하는 일은 말 하나와 몸짓 하나를 더한 일로 처리되지 않습니다. 두 자원 각각을 아는 것만으로는 둘이 함께 실현되는 국면을 읽을 수 없고, 그 국면에는 자원 바깥의 무언가가 걸려 있습니다.
5.Modal · 짝을 정하지 않은 결합
그 무언가를 찾으려면 연구진이 조합을 어떻게 설계했는지를 보아야 합니다. Bravo-6의 100개 조합은 구절 10개와 몸짓 10개를 빠짐없이 짝지은 것입니다. 「hello」에 손 흔들기를 붙인 자연스러운 조합만이 아니라, 대화에서 좀처럼 나오지 않을 어색한 조합까지 모두 들어 있습니다. 논문이 밝힌 이유는 이렇습니다. 「hello」가 늘 손 흔들기와 함께 나온다면, 몸짓 해독기는 몸짓을 읽는 대신 「hello」가 들렸으니 손 흔들기일 것이라고 추측하는 법을 배울 수 있습니다. 연구진은 그런 고정된 짝을 막으려고 모든 구절을 모든 몸짓과 만나게 했습니다.
M4로 옮기면 이 설계는 결합이 미리 정해진 짝으로 처리되는 길을 막은 것입니다. 말과 몸짓이 어떻게 결합할지는 목록에 적혀 있지 않습니다. 그 결합은 참여자가 그 순간 무엇을 함께 시도하느냐에 맡겨집니다.
그 결과가 이 설계의 의미를 확인해 줍니다. 연구진은 Bravo-6의 데이터에서 특정 조합을 학습에서 빼고, 해독기가 처음 보는 조합을 어떻게 읽는지 살폈습니다. 몸짓 해독기의 정확도는 학습한 조합에서 65.8퍼센트, 처음 보는 조합에서 66.7퍼센트였고, 말 해독기는 각각 79.3퍼센트와 80.0퍼센트였습니다. 차이는 통계적으로 의미가 없었습니다. 자연스러운 조합과 어색한 조합 사이에서도 차이가 없었습니다. 해독기가 배운 것은 특정한 짝의 목록이 아니라, 말과 몸짓이 함께 시도되는 상황 그 자체였다고 읽을 수 있습니다.
실시간 대화 과제는 이 조건이 실제 소통의 자리에서 어떻게 작동하는지를 보여 줍니다. 논문에 따르면 참여자는 실험자의 말에 답할 때 학습된 구절과 몸짓 가운데 무엇이든, 하나만이든 둘을 함께든 골라 쓸 수 있었습니다. 어떤 말에 어떤 몸짓을 붙일지, 몸짓 없이 말만 할지는 대화의 그 자리에서 정해졌습니다.
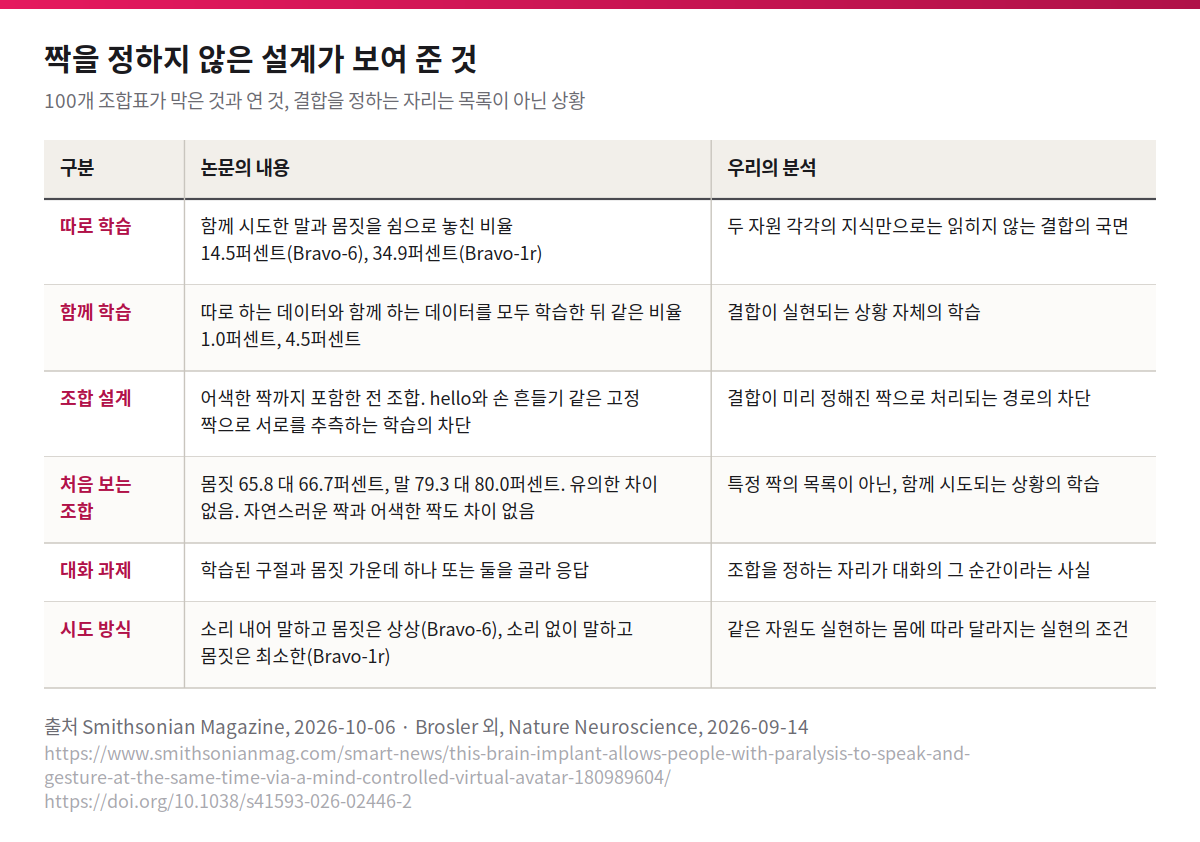
여기서 브로슬러의 ‘아마도’로 돌아가 볼 수 있습니다. 이 말은 논문이 아니라 인터뷰에서 나온 것이지만, 이 사례의 Modal을 정확히 짚습니다. ‘아마도’라는 Mode는 하나입니다. 그러나 그것이 끄덕임과 함께 실현되면 받아들임 쪽으로, 고개 젓기와 함께 실현되면 망설임이나 거절 쪽으로 기웁니다. Modal은 자원이 실현될 때 걸리는 조건과 태도입니다. 같은 구절이 어떤 몸짓과 함께 실현되느냐가 그 구절의 태도를 정하고, 그 짝은 목록이 아니라 상황이 정합니다. 연구진이 고정된 짝을 막은 것은 해독기의 성능을 위한 결정이었지만, 그 결정은 말과 몸짓의 결합이 본래 미리 정해져 있지 않다는 사실을 설계 안에 받아들인 것이기도 합니다.
참여자마다 시도 방식이 달랐다는 사실도 같은 쪽을 가리킵니다. Bravo-6은 말을 소리 내어 시도하고 몸짓은 머릿속으로 그렸습니다. Bravo-1r은 소리를 낼 수는 있었지만 지치는 일이라 소리 없이 말을 시도했고, 몸짓은 최소한으로만 시도했습니다. 논문은 시도 방식이 각자의 남은 능력과, 오래 지속할 수 있느냐에 따라 정해졌다고 적었습니다. 같은 말과 같은 몸짓도 누가 어떤 몸으로 실현하느냐에 따라 실현의 조건이 다릅니다.
6.Modality · 보고되지 않은 대화의 경험
Modality는 총체적 경험 구조의 자리입니다. 이 사례에서 그 자리를 채울 수 있는 것은 참여자가 아바타를 통해 대화하며 겪은 경험일 것입니다. 오랫동안 말을 잃은 채 머리의 움직임이나 손가락으로 글자를 짜 맞추어 소통해 온 사람이, 말과 몸짓이 함께 나가는 대화를 했을 때 그것이 어떤 경험이었는지가 이 자리의 내용입니다.
논문은 그 경험을 보고하지는 않았습니다. 공개된 것은 정확도와 오류율이고, 참여자가 그 대화를 어떻게 겪었는지, 아바타의 손 흔들기를 자기의 몸짓으로 느꼈는지는 적혀 있지 않습니다. 그래서 이 글은 사람 쪽 Modality를 미공개로 둡니다. 해독기와 아바타 쪽이 무엇을 겪는지는 이 글이 판정할 수 있는 범위 밖에 있으므로 유보합니다.
7.Medium · 피질 위의 전극판과 대화 과제
이 사례의 Medium은 먼저 뇌 표면에 놓인 전극판입니다. 전극 253개가 3밀리미터 간격으로 늘어선 이 판은 뇌를 뚫지 않고 표면에 놓이기 때문에, 말과 관련된 영역과 팔다리의 움직임에 관련된 영역을 한 장으로 넓게 덮을 수 있습니다. 말과 몸짓을 하나의 장치로 함께 읽는 일은 이 기반 위에서 가능해졌습니다. 이 장치를 이식하고 기록을 이어 가게 하는 임상시험의 규정도 이 기반의 일부입니다.
대화 과제의 장면도 Medium입니다. 실험자가 말을 걸고, 화면 아래의 점 세 개가 사라지면 참여자가 답하며, 해독된 말은 글자로, 몸짓은 아바타의 동작으로 화면에 나옵니다. 그리고 구절 10개와 몸짓 10개라는 어휘의 크기가 이 장면에서 무엇을 말하고 어떤 몸짓을 할 수 있는지의 범위를 정합니다. 5절에서 본 결합의 자유는 이 범위 안에서의 자유입니다.
순환을 말하려면 조심해야 합니다. 논문은 어휘를 넓히는 일을 다음 과제로 꼽으면서, 어휘가 커지면 조합마다 학습 데이터를 모으는 일이 현실적이지 않으므로 처음 보는 조합을 읽어 내는 능력이 더 중요해진다고 적었습니다. 브로슬러는 인터뷰에서 정해진 몸짓 대신 손의 관절 15개를 이어서 움직이게 하는 쪽도 덧붙였습니다. 이것은 짝을 정하지 않은 결합이라는 Modal에 맞추어 기반을 다시 짜려는 방향으로 읽힙니다. 그러나 그 방향이 참여자의 어떤 Modality에서 나온 요구인지는 6절에서 비워 둔 만큼 말할 수 없습니다. 이 사례의 순환은 닫히지 않은 채로 적어 둡니다.
8.아직 말할 수 없는 것
공개되지 않은 것이 셋입니다. 참여자가 아바타를 통한 대화를 어떻게 겪었는지는 보고되지 않았습니다. 처음 보는 조합에 대한 분석은 실시간이 아니라 기록된 데이터로 한 것이고, Bravo-6 한 사람에게서만 이루어졌습니다. 어휘가 커졌을 때도 같은 결과가 나올지는 아직 시험되지 않았습니다.
논지가 약해지는 조건도 적어 둡니다. 어휘를 넓혔을 때 처음 보는 조합의 정확도가 크게 떨어지거나, 결국 조합마다 따로 학습해야 한다면, 이 글이 「짝을 정하지 않은 결합」에 둔 무게는 그만큼 줄어듭니다. 그때는 결합이 미리 정해지지 않는다는 해석보다, 작은 어휘 안에서 짝의 수가 충분히 적었다는 설명이 더 맞을 수 있습니다. 또 참여자가 실제 대화에서 몇 가지 익숙한 짝만 되풀이해 썼다면, 결합의 자유는 설계에 열려 있었을 뿐 대화 안에서는 좁게 쓰였다고 읽어야 합니다.
말과 몸짓이라는 Mode는 짝을 미리 정하지 않은 Modal 아래에서 대화의 자리마다 새로 결합하고, 전극판과 대화 과제라는 Medium이 그 범위를 정했지만, 그 결합이 참여자에게 어떤 Modality로 닿았는지는 아직 비어 있습니다.
출처
Smithsonian Magazine, Sara Hashemi, 「This Brain Implant Allows People With Paralysis to Speak and Gesture at the Same Time Via a Mind-Controlled Virtual Avatar」, 2026-10-06. https://www.smithsonianmag.com/smart-news/this-brain-implant-allows-people-with-paralysis-to-speak-and-gesture-at-the-same-time-via-a-mind-controlled-virtual-avatar-180989604/
Samantha C. Brosler 외, 「Simultaneous speech and gesture decoding for multimodal communication in paralysis」, Nature Neuroscience 29, 2445~2455쪽, 2026-09-14. https://doi.org/10.1038/s41593-026-02446-2
확인 날짜 2026-10-18
의견을 남겨주세요