"AI가 답을 잘한다"는 이야기는 이제 새롭지 않습니다.
이번엔 AI가 답만 하지 않고, 그 답을 실행하려고 화면을 직접 만지기 시작했다는 게 다릅니다.
오늘 레터에서는 세 가지를 살펴봅니다.
- 아스트라가 화면을 "직접 조작한다"는 게 정확히 뭘 뜻하는가
- 실무 도구 회사들이 벌써 여기에 뭘 붙였는가
- 같은 능력이 왜 보안 쪽에서는 위험 신호로도 읽히는가
GPT-6 아스트라
GPT-6 아스트라, 뭐가 달라졌나
지금까지 AI한테 일을 시키면, AI는 답을 주고 사람이 그 답을 들고 가서 실행했습니다. 온라인 양식을 채우라고 하면 채우는 방법을 알려줬고, 코드를 짜달라고 하면 코드를 줬습니다. 실행은 늘 사람 몫이었습니다.
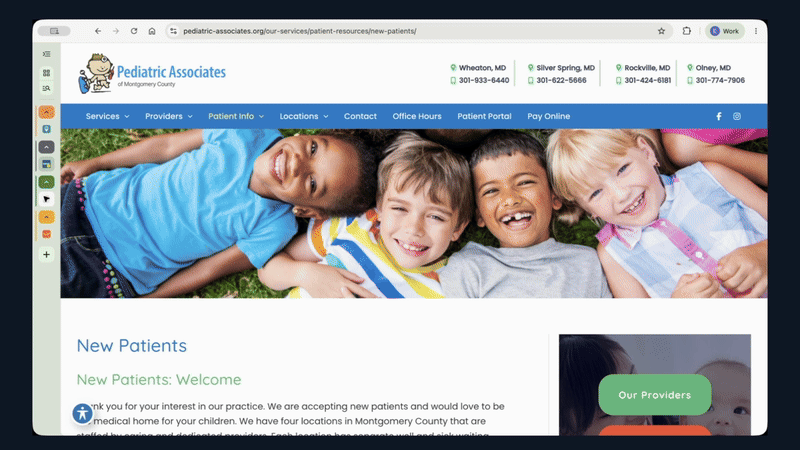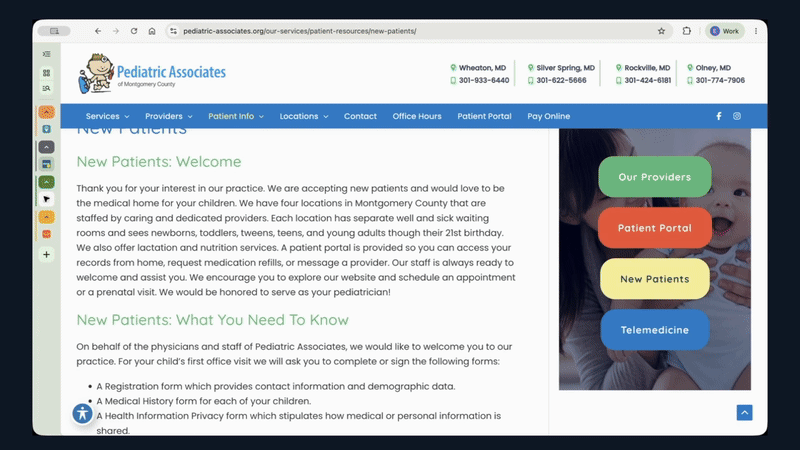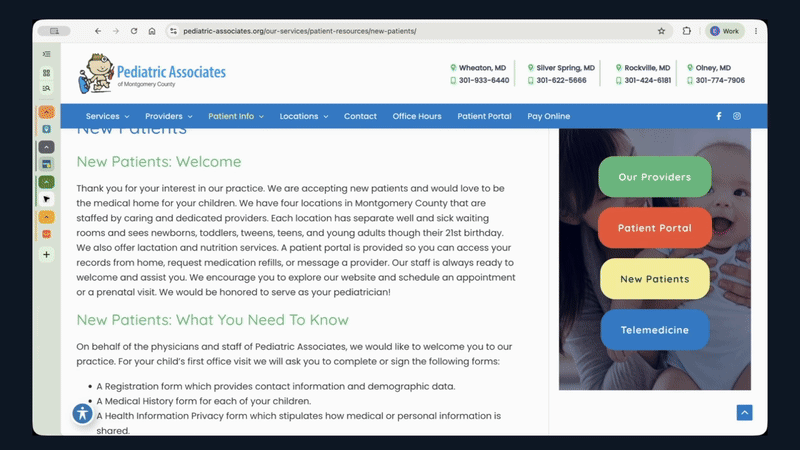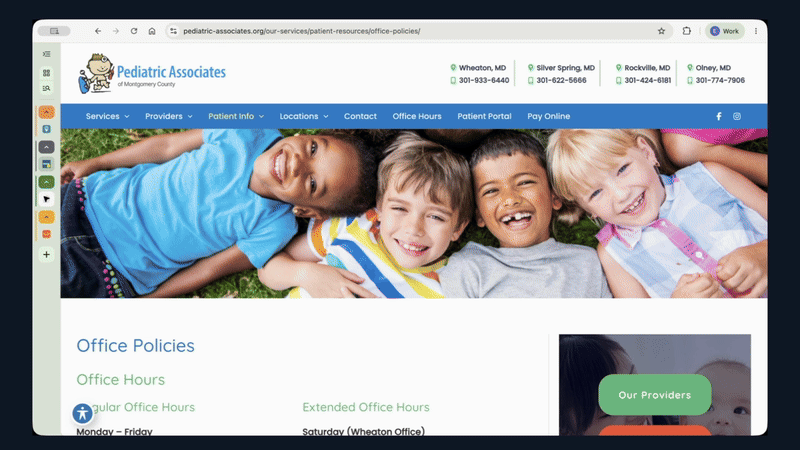
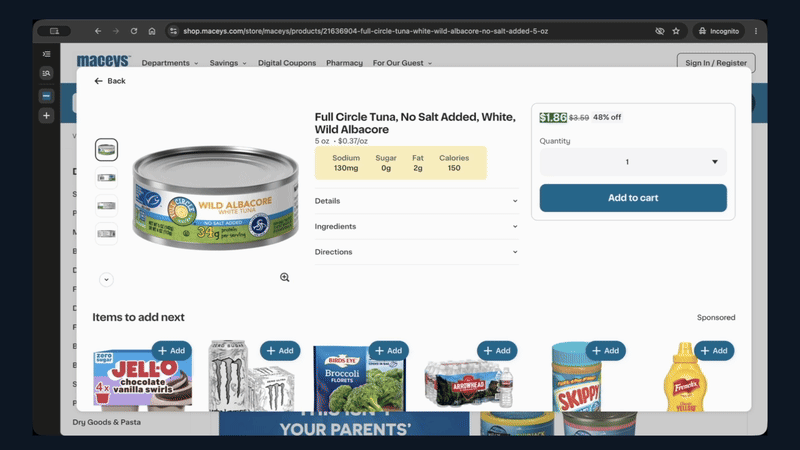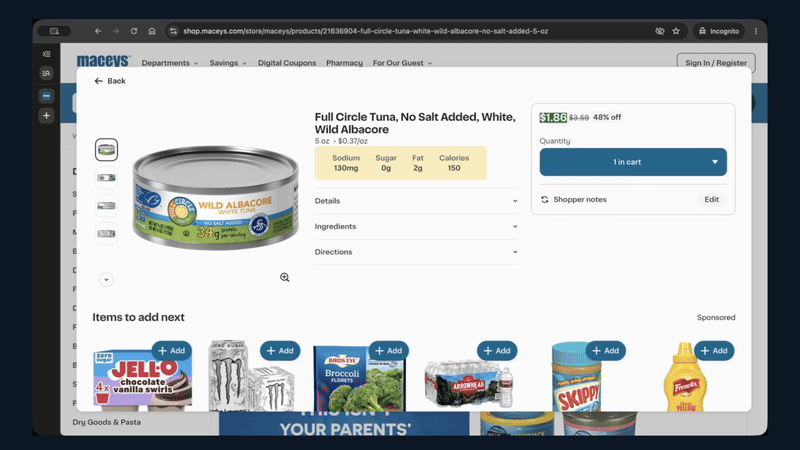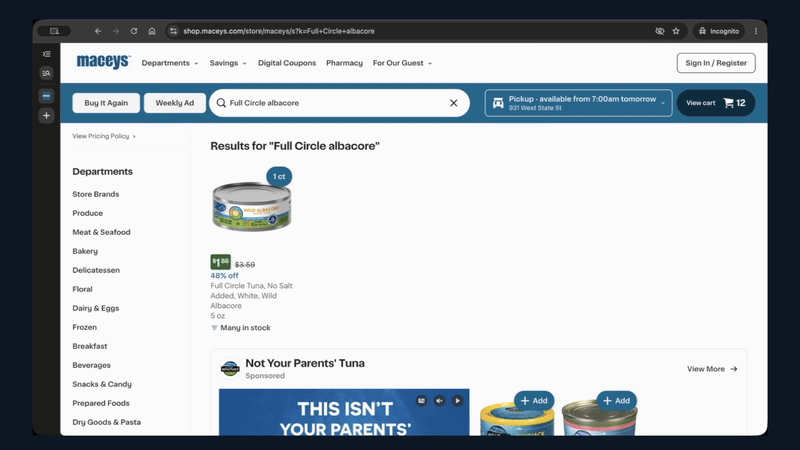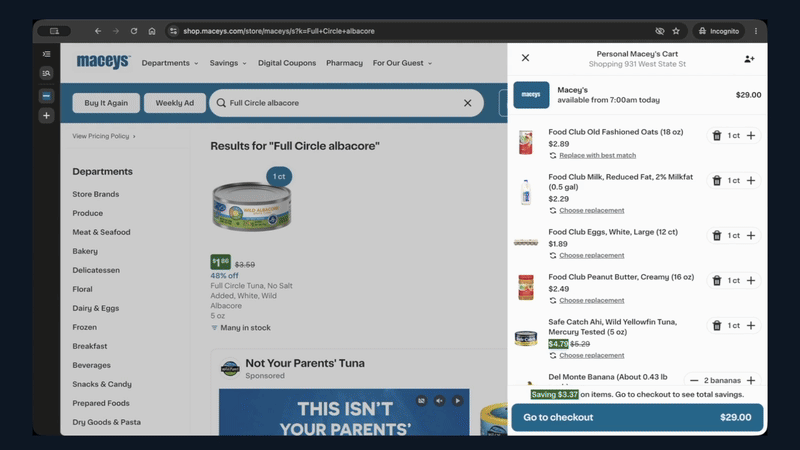
GPT-6 아스트라는 이 순서를 바꿉니다. 오픈AI가 만든 이 새 모델은 온라인 양식 작성, 인터넷 쇼핑, 자료 조사 후 문서 작성, 코딩, 과학 데이터 분석까지 화면을 직접 클릭하고 입력하며 처리합니다. 오픈AI가 공개한 데모 영상 세 편이 이걸 보여줍니다. 소아과 병원 홈페이지를 직접 열어 진료 시간을 확인하고, 온라인 마트에서 재료를 검색해 장바구니에 담고, 유치원 여러 곳의 주소·통학 거리·입학 조건을 찾아 비교 문서로 정리합니다.
실행까지 한 번에 끝난다
지금까지 AI를 쓰는 흐름은 사람이 창을 오가며 이어붙이는 일이었습니다. AI한테 물어보고, 답을 받아서 다른 창으로 옮기고, 거기서 다시 사람이 클릭하고 입력했습니다. 유치원 비교가 좋은 예입니다. 이전이라면 AI가 "이 유치원들을 알아보세요"라고 알려주면, 사람이 직접 각 유치원 홈페이지를 열어 주소를 확인하고, 엑셀이나 워드를 열어 표를 만들어야 했습니다. 아스트라는 이 전체를 한 번에 처리합니다. 리서치와 정리, 문서 작성이 사람의 개입 없이 이어집니다. 코딩도 마찬가지입니다. 코드를 짜주는 데서 그치지 않고, 필요하면 터미널을 열어 명령을 실행하고 결과를 확인한 뒤 다음 단계로 넘어갑니다.
화면을 "직접" 만진다는 증거
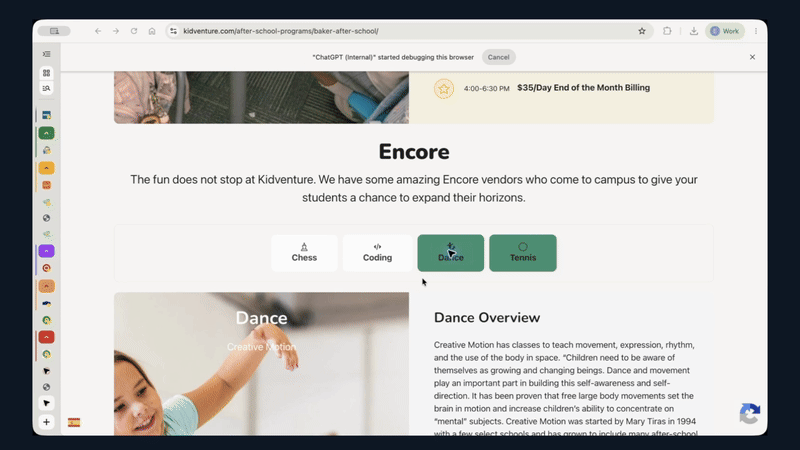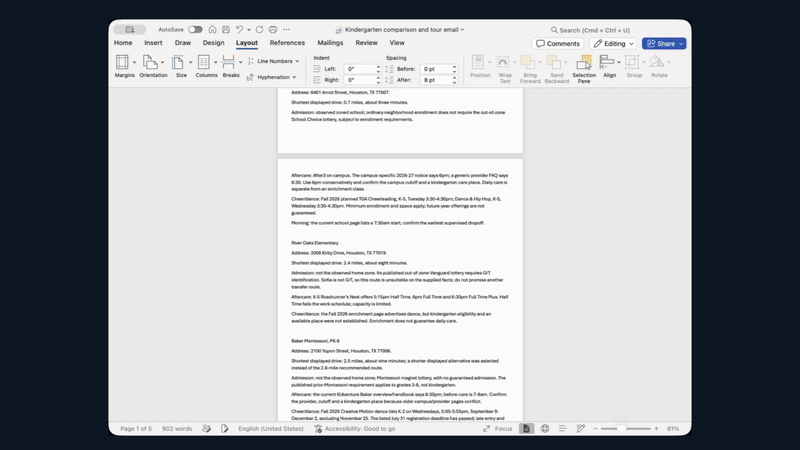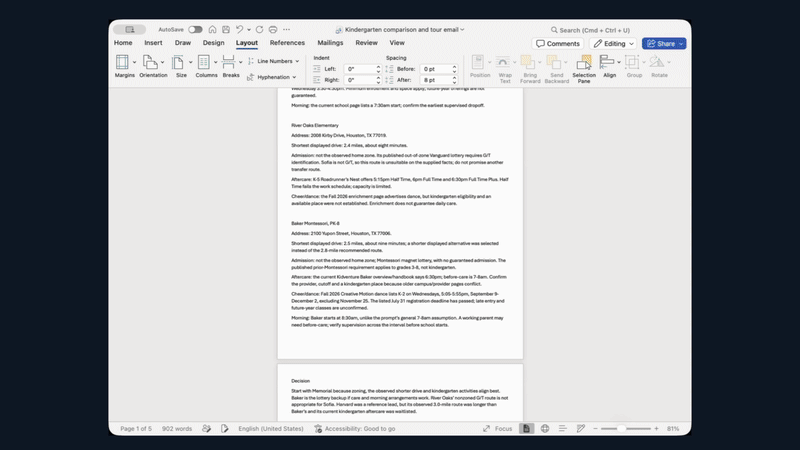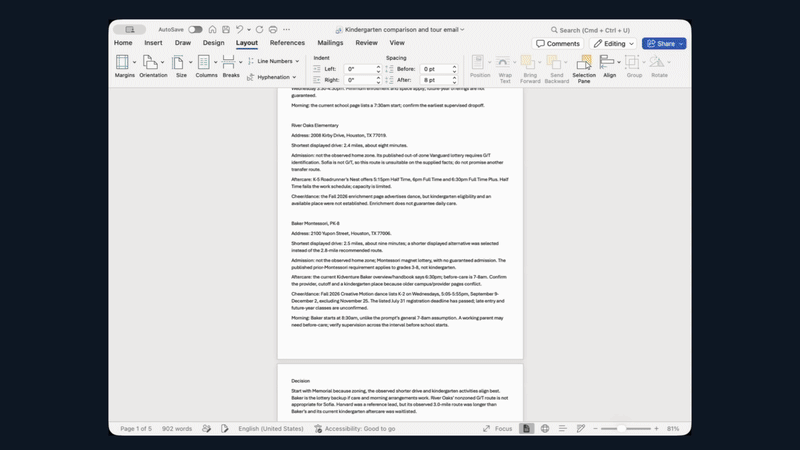
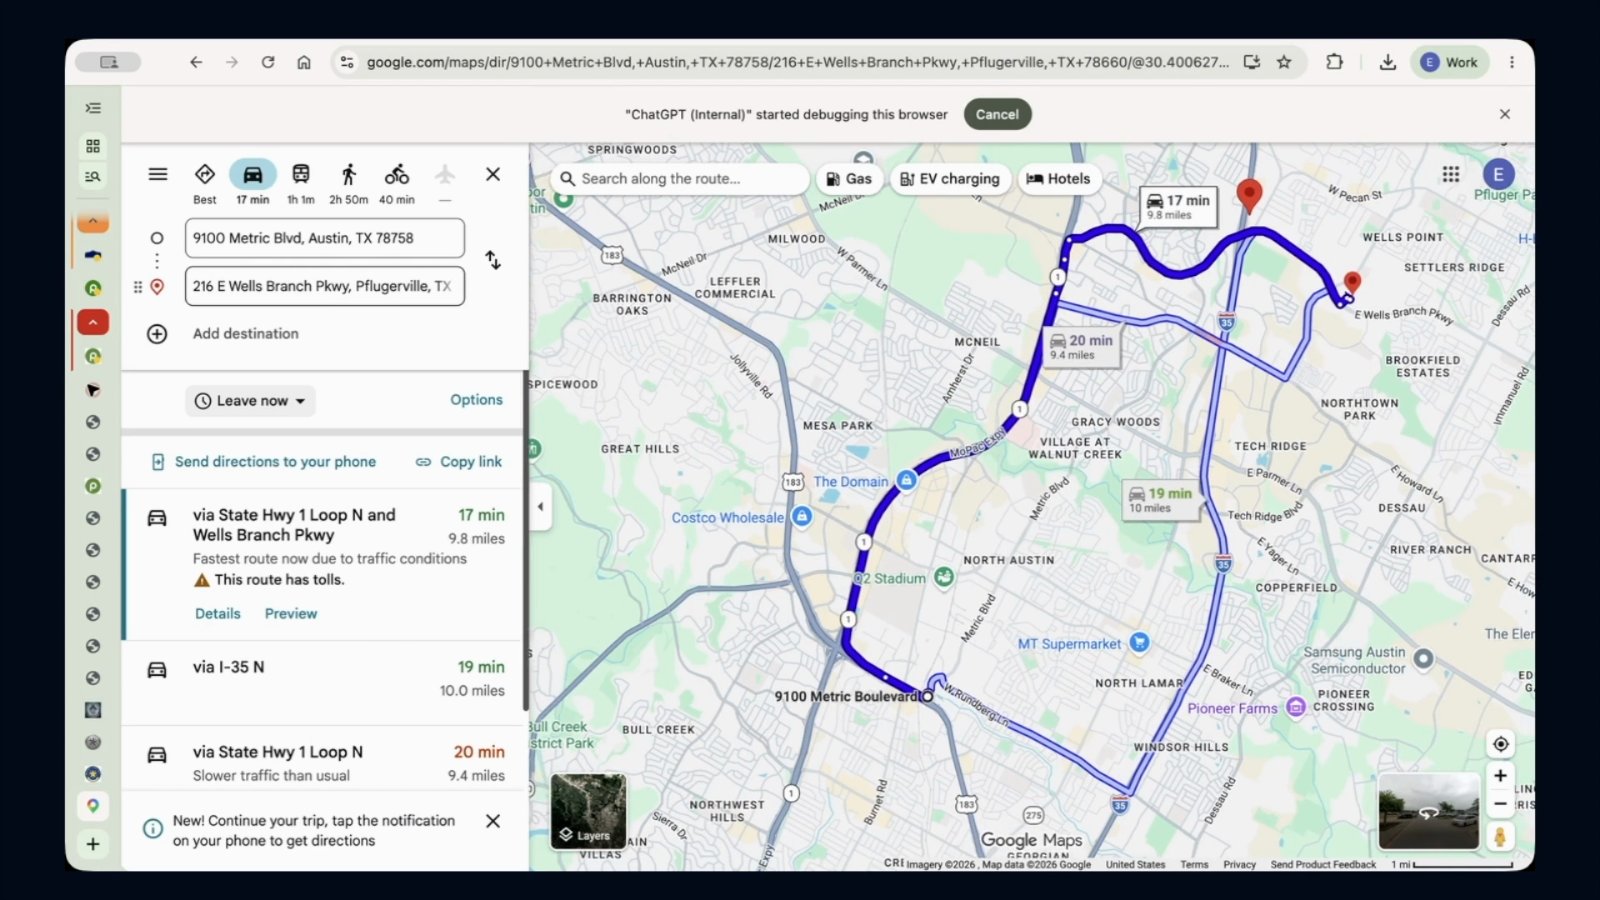
말로만 설명하면 추상적인데, 실제 화면을 보면 분명합니다. 아래는 구글 지도에서 경로를 검색하는 장면인데, 상단에 "ChatGPT (Internal) started debugging this browser"라는 배너가 떠 있습니다. 사람이 브라우저를 조작하는 게 아니라, AI가 브라우저 자체를 붙잡고 조작하고 있다는 신호입니다.
공식 갤러리에서 사례를 고를 때 쓰는 필터가 세 종류입니다. 용도를 가르는 카테고리, 3D·일러스트·사진 같은 스타일, 커머스·교육·여행 같은 장면이 각각 따로 걸립니다.
사례 하나에 세 갈래 태그가 모두 붙어 있다는 뜻입니다. 그래서 "상품 사진인데 일러스트 스타일"처럼 조건을 겹쳐 좁힐 수 있습니다. 폴더로 나눠 담았다면 못 하는 일입니다.
애매하면 묻고, 확실하면 그냥 진행한다
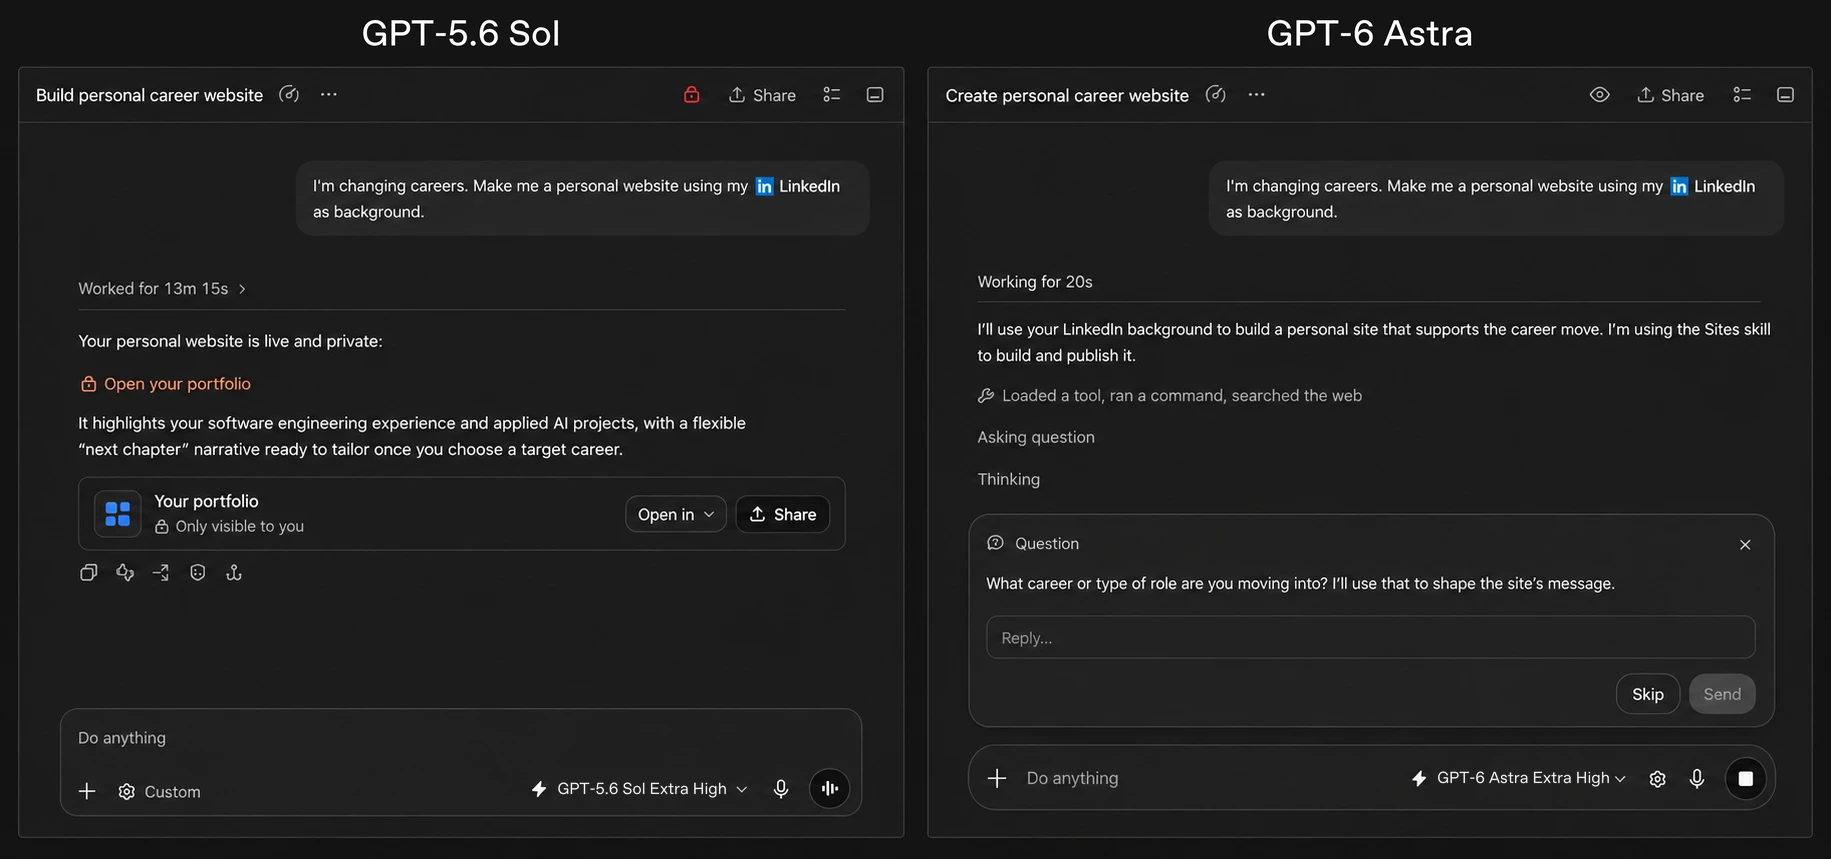
오픈AI가 공개한 비교 이미지는 이 모델의 판단 방식을 보여줍니다. 같은 요청("링크드인을 배경으로 커리어 웹사이트를 만들어줘")에 이전 모델(GPT-5.6 Sol)은 13분 15초 만에 결과물부터 내놨습니다. 아스트라는 다르게 움직였습니다. 도구를 불러오고 명령을 실행하고 웹을 검색한 뒤, 먼저 "어떤 직무나 역할로 옮기시나요? 그걸 알아야 사이트 메시지를 그에 맞게 잡을 수 있습니다"라고 되물었습니다. 중요한 결정 앞에서는 짐작하는 대신 확인부터 하는 쪽을 택한 겁니다.
실무 도구 회사들이 벌써 여기 뭘 붙였나
오픈AI는 코그니션(코딩 AI 데빈 개발사)·제인 스트리트(금융회사)·러버블(웹사이트 제작 도구)·하비(법률 AI)·힉스필드 AI(영상 생성 도구)가 이미 아스트라를 제품에 연결해 성능 개선을 확인했다고 공식 발표에서 밝혔습니다. 이 회사들의 공통점은 하나입니다. 전부 "AI가 결과만 주는 게 아니라 직접 작업을 끝까지 실행해야" 값어치가 나오는 도구라는 점입니다.
물론 이건 오픈AI와 각 회사가 공식적으로 밝힌 내용이지, 독립적으로 검증된 사용 후기는 아닙니다.
수치로 보면
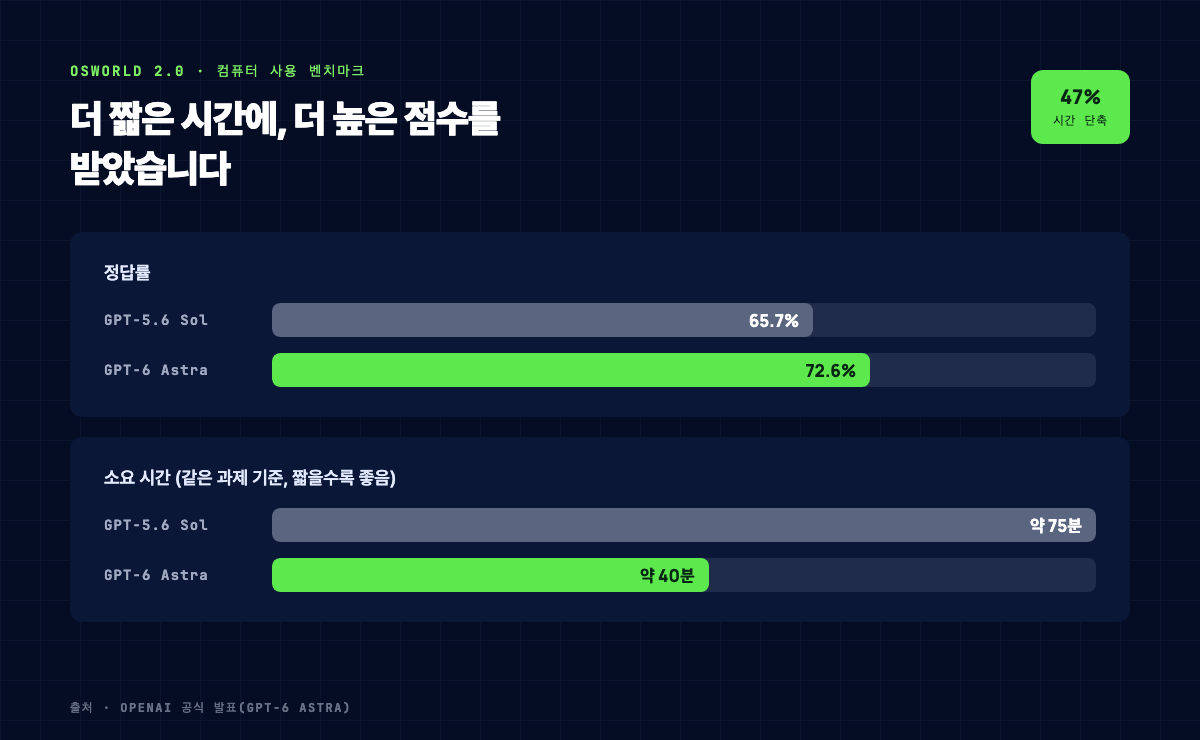
다만 수치로는 확인되는 부분이 있습니다. 컴퓨터 사용 능력을 재는 공식 시험 OSWorld 2.0에서 아스트라는 이전 모델보다 47% 적은 시간(약 40분)으로 더 높은 정답률(72.6% vs 65.7%)을 기록했습니다.
두 번째로 갈리는 지점은 여기입니다. 이 저장소는 사람이 웹사이트에서 복사·붙여넣기 하는 용도로만 만들어지지 않았습니다.
수치 하나는 공식 자료 안에서도 서로 다릅니다. 수학 시험 FrontierMath Tier 4 점수를 발표 서두는 "98%"라고 적었는데, 같은 페이지 하단 표에는 "97.6%"로 나와 있습니다. 오픈AI가 어느 쪽이 맞는지 따로 밝히지 않았습니다. 이 레터는 표 수치(97.6%)를 기준으로 씁니다.
같은 힘이 보안 쪽에서는 경고음이 된다
화면을 직접 조작하는 능력은 좋은 쪽으로만 쓰이지 않습니다. 오픈AI 자체 시험(ExploitBench — 보안 취약점을 직접 찾아 공략하는 시험)에서 아스트라는 **성공률 100%**를 기록했습니다. 이 수치는 오픈AI 자체 안전 기준("Preparedness Framework")에서 **가장 높은 등급인 "Critical"**에 해당합니다.
그래서 오픈AI는 스스로 제한을 걸었습니다. 방어적인 작업(보안 코드 리뷰·패치)에는 열려 있지만, 더 민감한 요청은 아스트라가 스스로 거부하도록 만들어뒀습니다. 같은 손이 문을 고칠 수도, 열 수도 있다는 뜻이고, 오픈AI도 그걸 알고 있다는 뜻입니다.
일부 해외 매체(Axios·Fox Business)는 오픈AI 경영진 발언을 인용해 이번 발표를 "AGI(범용인공지능) 도달 신호"로 해석했습니다. 다만 확보한 오픈AI 공식 발표 원문에는 이 표현이 등장하지 않습니다. 원문에 없는 해석이라는 점을 밝혀둡니다.
언제, 얼마에 쓸 수 있나
일부 조직에 제한적으로 먼저 열리고, 이후 며칠 안에 챗GPT 플러스·프로·비즈니스·엔터프라이즈 전체로 확대됩니다. API·애저·AWS 베드록으로도 제공됩니다. API 가격은 입력 100만 토큰당 10달러, 출력 100만 토큰당 50달러이고, 응답 속도를 2배로 높인 "패스트 모드"는 가격도 2배입니다.
🔑 핵심
GPT-6 아스트라는 답만 주던 AI에서 화면을 직접 조작하는 AI로 넘어갔습니다. 실무 도구 회사 다섯 곳이 벌써 제품에 붙였고, 같은 능력이 보안 취약점 공략에서도 통해 오픈AI 스스로 제한을 걸었습니다. 성능이 늘면 위험도 함께 늘 수 있다는 걸 만든 회사가 먼저 인정한 사례입니다.
다음 발행에서 또 인사드리겠습니다. swimmingcode 드림.
이 레터에서 다룬 내용에 대해 궁금한 점이 있으시면 답장으로 알려주세요. 직접 확인해서 답해드립니다.
AI를 실무에 어디까지, 어떻게 붙일지 정리하고 싶으시다면
다음 주 수요일에 다시 인사드릴게요. swimmingcode 드림
이 레터가 어떠셨는지 답장으로 알려주시면 다음 편에 반영하겠습니다.
의견을 남겨주세요