🏠 AI가 장보기와 서류 작성까지 해낼까? OpenAI의 생활 과제 시험 'LifeVal'
운전면허를 딸 때 필기시험만 잘 본다고 운전을 잘하는 건 아니죠. 실제 도로에 나가 봐야 알 수 있어요. 지금까지 AI 벤치마크(Benchmark, 성능 시험)는 대부분 필기시험에 가까웠어요. 지식을 묻고 정답을 맞히는 방식이었죠. 이번에 OpenAI가 육아, 건강, 행정 서류, 장보기 같은 일상 과제 169개로 만든 평가 'LifeVal'을 11월 2일 공개했어요. AI 비서가 실제로 일을 끝낼 수 있는지 보는 도로주행 시험인 셈이에요.
시험 문제는 어떻게 골랐을까요?
OpenAI는 사람들이 하루를 어떻게 보내는지부터 살폈어요. 미국 노동통계국의 시간 사용 조사(ATUS)와 여러 나라 자료를 모은 MTUS에서 출발했고 인구 구성을 대표하도록 뽑은 3,995명에게 과제마다 개인 비서의 도움을 얼마나 원하는지 물었어요. 그렇게 고른 과제는 돌봄, 건강, 교육, 가사 행정, 개인 재무, 쇼핑, 정부 서비스 이용 등의 영역에 걸쳐요.
공개된 예시를 보면 감이 와요. 벤치마크에는 조언만 하는 게 아니라 끝까지 처리해야 점수를 받는 문제들이 포함되어 있어요. OpenAI가 공개한 과제에는 이런 것들이 있어요.
- 유아에게 맞는 감각 수업을 찾아 예약하기
- 이메일 구독 해지하기
- 텍사스주 식비 지원(SNAP) 신청서를 작성하고 증빙 서류를 첨부하기
1년 만에 49.3%에서 80.6%로
가장 높은 추론 강도(xhigh) 기준으로 OpenAI 모델들의 점수는 이렇게 변했어요.
- GPT-5.2 (2025년 12월): 49.3%
- GPT-5.4 (2026년 3월): 73.0%
- GPT-5.5 (2026년 4월): 77.4%
- GPT-5.6 (2026년 7월): 80.0%
- GPT-6 Astra (2026년 9월): 80.6%
가장 큰 도약은 GPT-5.4에서 나왔고 그 뒤로는 오르는 폭이 점점 줄었어요. 주의할 점도 있어요. 이 점수는 여러 번 시도한 평균 보상(Average Reward)이라 부분 점수가 섞였을 수 있어요. 80.6%를 "과제 169개 중 80.6%를 성공했다"로 읽으면 안 돼요.
비싼 최신 모델이 꼭 정답은 아니에요
구독자님이 에이전트를 만든다면 이 부분이 가장 쓸모 있을 거예요. OpenAI도 차트에 GPT-5.6이 GPT-6와 비슷한 성능을 약 절반의 추정 API 비용으로 낸다고 적었어요. 실제로 최고 점수는 GPT-5.6 max가 82.6%(시도당 9.65달러), GPT-6 Astra max가 82.5%(20.04달러)로 거의 같았어요. 대신 GPT-6 Astra는 같은 xhigh 설정에서 시도당 15.0분으로 GPT-5.6의 17.5분보다 빨랐어요.
정리하면 고르는 기준이 달라져요. 사용자가 화면 앞에서 기다리는 서비스라면 속도를, 밤새 많은 작업을 돌리는 서비스라면 비용을 먼저 보면 돼요. 1년 사이 효율도 크게 좋아졌어요. GPT-5.2는 시도당 121분과 약 30달러를 쓰고도 49.3%였지만 GPT-5.4는 16.7분과 4.42달러로 73.0%를 기록했어요.
아직은 OpenAI가 직접 매긴 성적표예요
다만 이 결과를 그대로 믿기엔 빈칸이 많아요. 169개 전체 과제 목록, 채점 방식, 과제당 시도 횟수와 실행 환경이 공개되지 않았고 차트에는 OpenAI 모델만 있어서 다른 회사 모델이나 사람과 비교할 수 없어요. 과제도 미국 생활에 맞춰져 있어서 한국어 환경이나 국내 행정 서비스에서 같은 점수가 나온다는 근거는 없어요.
그래서 LifeVal은 "어떤 모델이 최고인가"보다 "AI 비서가 생활 속 일을 어디까지 해내게 됐나"를 보여 주는 흐름표로 읽는 게 좋아요. 그리고 최신 모델이 늘 가성비까지 좋은 건 아니라는 점도 함께 기억해 두세요. 원문은 OpenAI LifeVal 소개 글에서 확인할 수 있어요.
🎨 디자이너의 안목을 배운 AI: LangChain의 디자인 에이전트 'Content Studio'
AI에게 "우리 브랜드 느낌으로 배너 하나 만들어 줘"라고 해 본 적 있으신가요? 결과물은 깔끔한데 어딘가 남의 회사 것 같고 다른 AI 이미지와 비슷해 보이곤 하죠. LangChain이 이 문제를 4개월 동안 붙잡고 만든 디자인 에이전트를 공개했어요. Content Studio는 Slack에서 프롬프트 하나로 영상, SNS 이미지, 슬라이드 덱 등을 만들어 주고, 만든 결과물은 모두 코드로 작성돼요.
성과도 눈에 띄어요. 지금까지 슬라이드 덱 80개 이상을 포함해 3,000개가 넘는 결과물을 만들었고 요청 4건 중 3건은 마케팅팀 밖에서 와요. 요청 한 건의 모델 비용 중앙값은 9월 중순 약 8달러에서 약 50센트로 줄었어요.
안목은 맥락에서 나와요
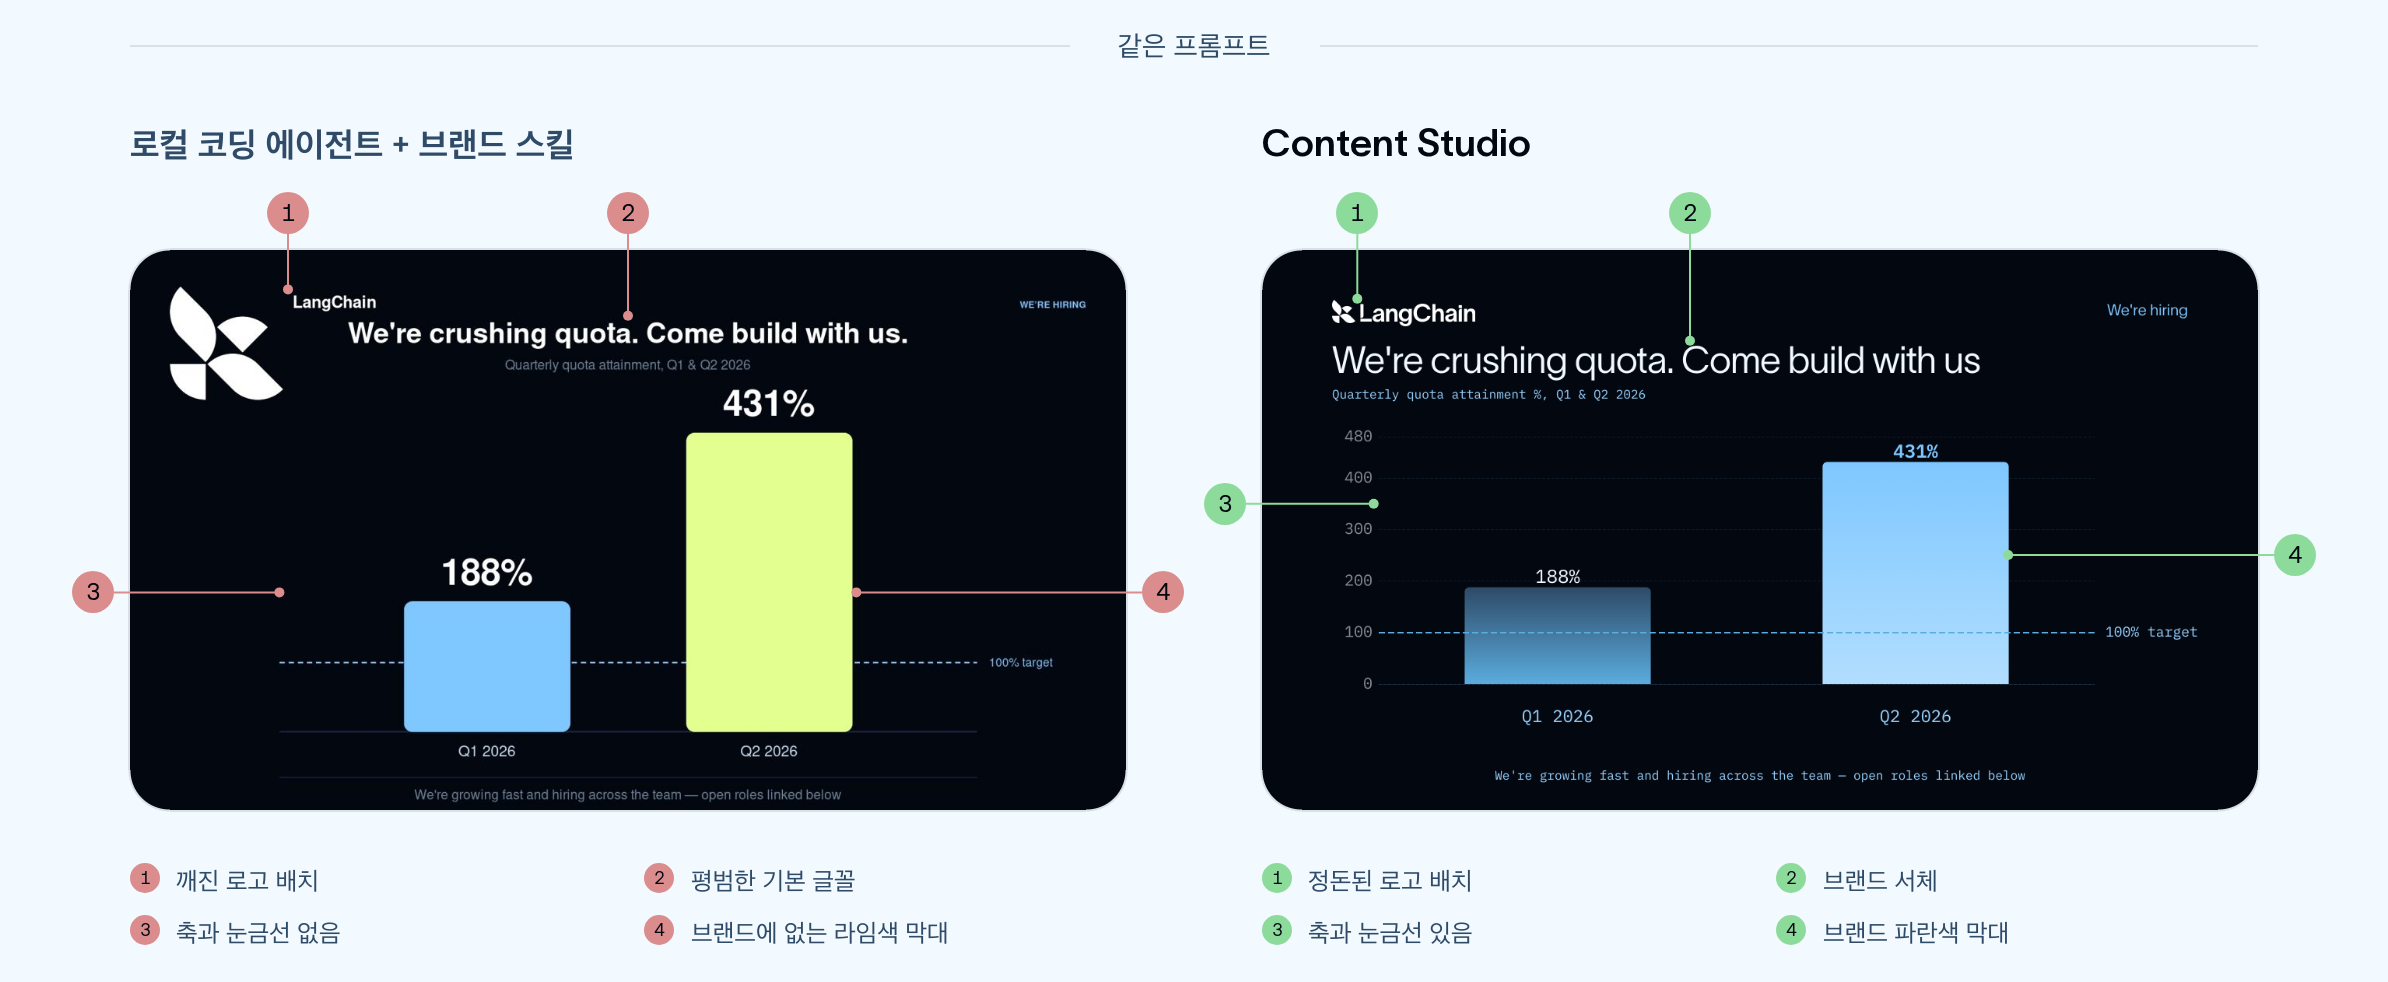
LangChain은 AI가 디자인을 못하는 게 아니라 관점이 없을 뿐이라고 봐요. 모델은 HTML이나 애니메이션 코드는 이미 잘 쓰지만 회사의 맥락이 없으면 익숙한 패턴으로 돌아가요. 실제로 브랜드 스킬을 넣은 일반 코딩 에이전트는 로고 배치, 텍스트 정렬, 주색과 보조색 구분을 놓쳤지만 Content Studio는 같은 프롬프트로 브랜드에 맞는 이미지를 만들었어요.
차이는 색상이나 글꼴 같은 기본 규칙 위에 얹은 것들에서 났어요. 한 화면에 초점은 하나만 두기 같은 디자인 원칙, 흔한 AI 디자인 패턴을 막는 장치, 그리고 피드백마다 그 이유를 함께 알려 준 것이 품질을 끌어올렸어요. 대문자 사용처럼 측정할 수 있는 실수는 자동 검사가 모두 잡아내도록 했어요.
모델이 좋아지면 규칙을 지워요
가장 흥미로운 교훈은 이거예요. 처음엔 신입 디자이너에게 두꺼운 매뉴얼을 주듯 규칙을 잔뜩 넣었어요. 재사용 UI 컴포넌트를 115개나 만들어 줬더니 브랜드는 지켰지만 매 화면마다 같은 레이아웃과 애니메이션만 반복했어요. 그러다 Opus 5.5가 나오자 하드코딩한 규칙 대부분을 지우고 디자인 원칙만 남겼고 결과물은 오히려 더 다양해졌어요. 모델의 약점을 메우려고 만든 규칙은 모델이 좋아질수록 쓸모가 줄고 오래 남는 건 도구와 맥락 같은 작업 환경이라는 거예요.
혼자 일하지 않는 '비서실장' 에이전트
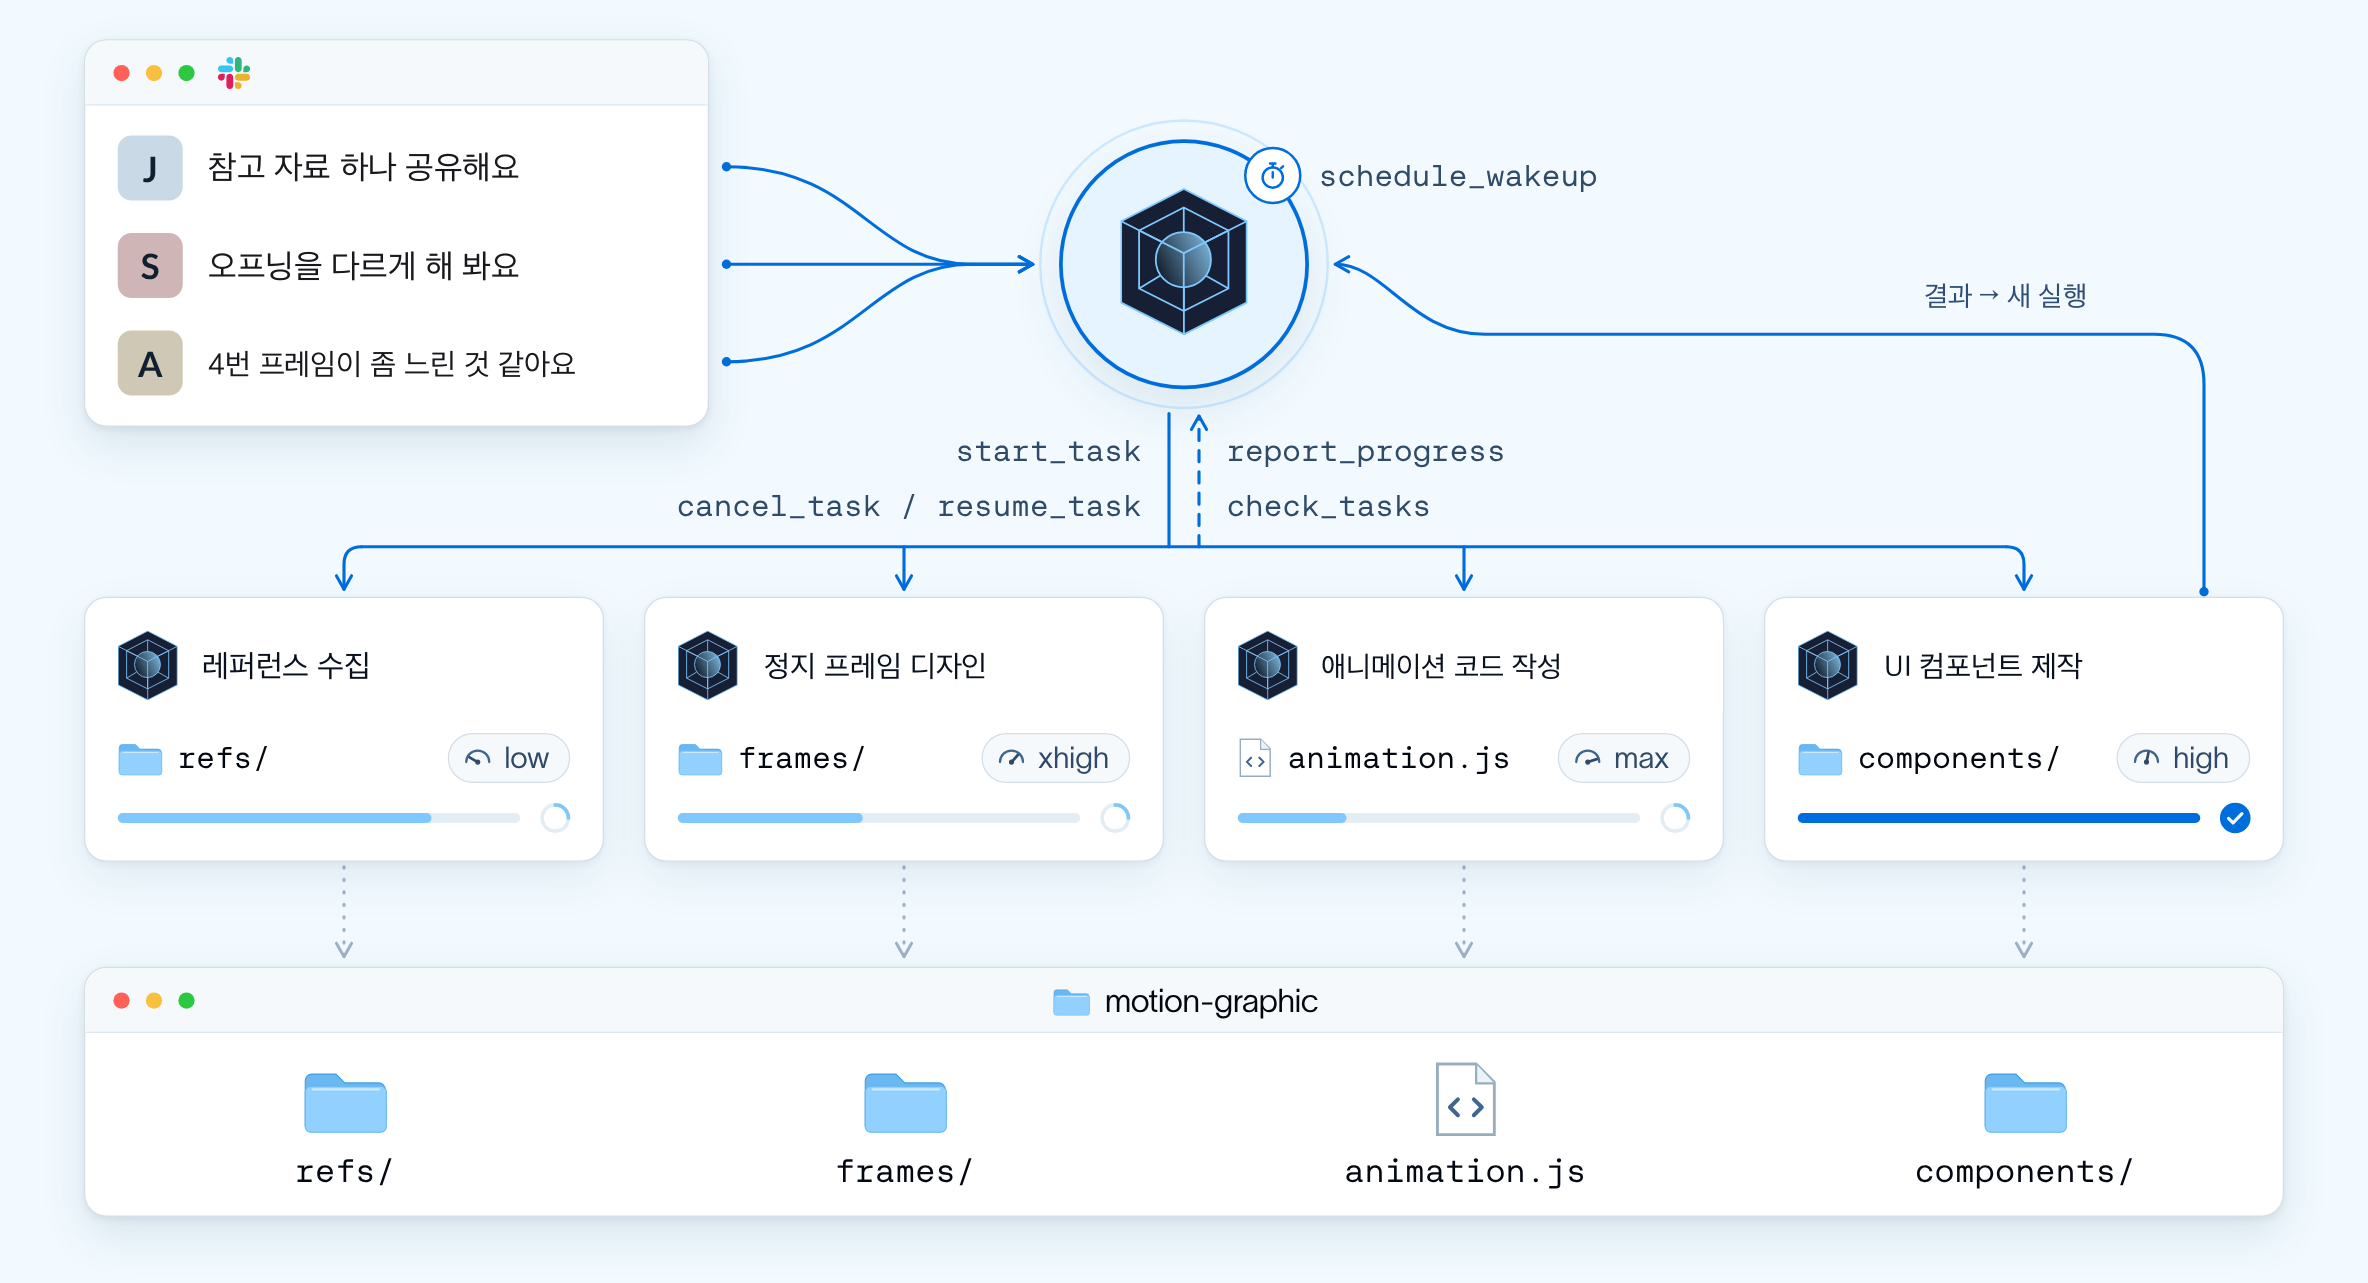
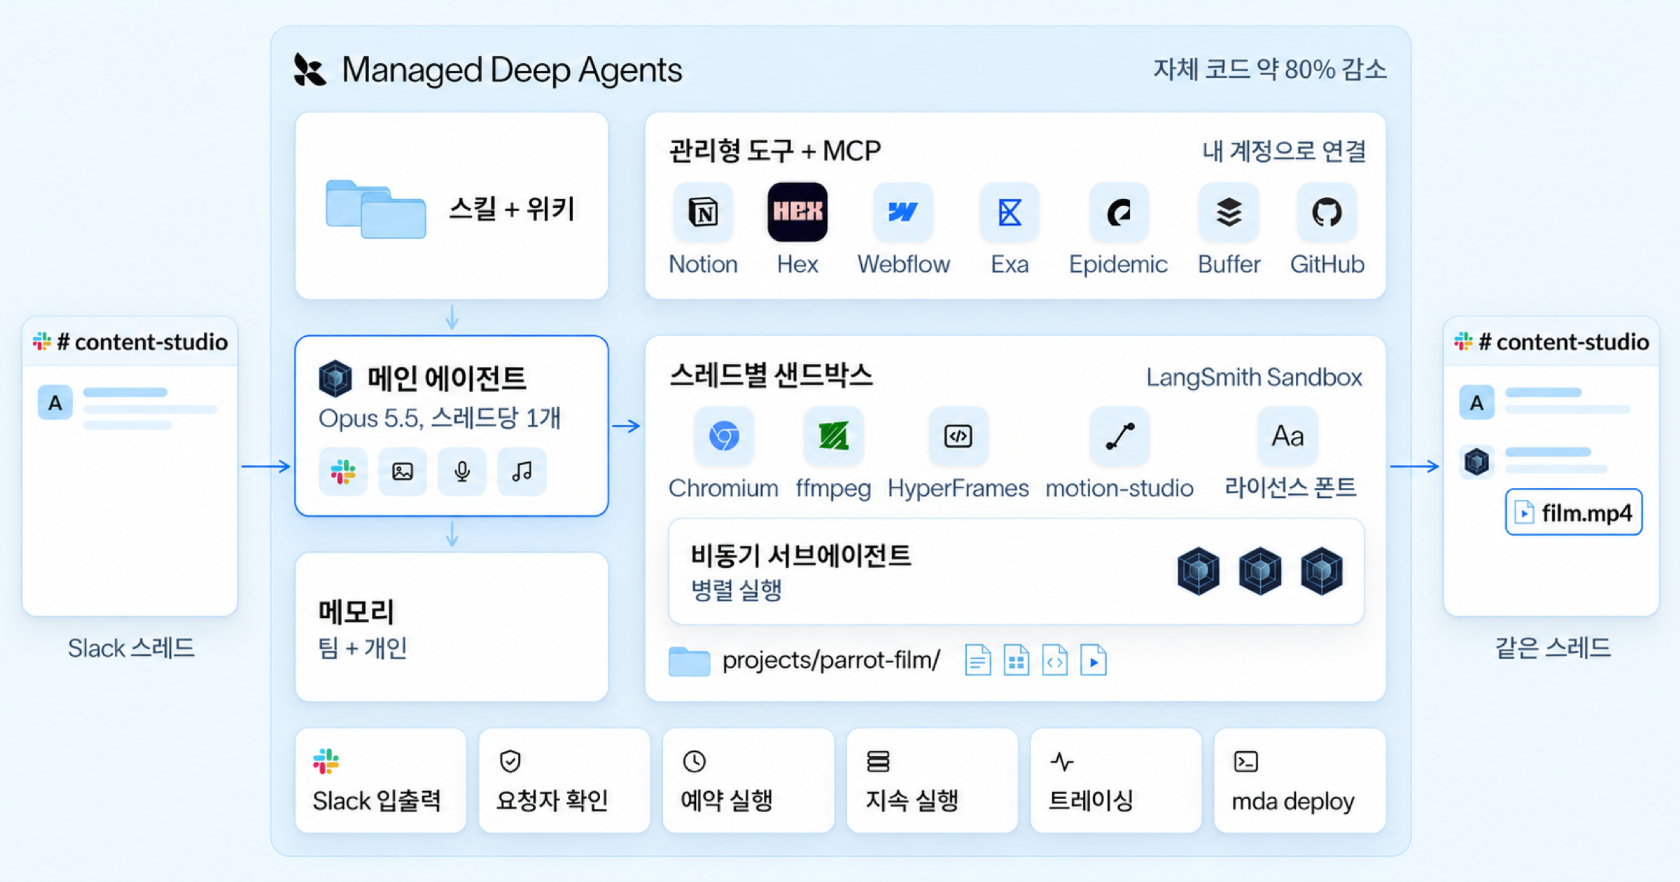
긴 작업을 처리하는 구조도 눈여겨볼 만해요. Slack 스레드마다 전용 샌드박스(Sandbox, 격리된 리눅스 컴퓨터)가 하나씩 붙고 프로젝트는 스레드가 이어지는 동안 그곳에 남아 있어요. 메인 에이전트는 직접 만드는 대신 작업을 쪼개 서브에이전트(Subagent)에게 맡기고 병렬로 돌리는 비서실장 역할을 해요. 그동안에도 팀원들은 계속 피드백을 줄 수 있어요. 실제로 52장짜리 발표 자료를 밤새 새 디자인으로 바꾼 작업에서 메인 에이전트는 약 1시간, 서브에이전트들은 합쳐서 6시간 넘게 일했어요.
메인 에이전트가 Slack 요청을 서브에이전트들에게 나눠 맡기고, 서브에이전트는 공유 샌드박스 폴더에서 작업한 뒤 결과를 다시 메인 에이전트가 Slack으로 보고하는 구조예요.
나만의 디자인 에이전트에 바로 가져갈 교훈
- 피드백엔 이유를 붙이세요. "이건 별로야"보다 "초점이 두 개라서 별로야"가 다음 결과를 바꿔요.
- 꼭 지켜야 할 순서는 코드로 강제하세요. 검토 순서를 지시문에만 적었을 땐 에이전트가 시간을 아끼려고 검토를 건너뛰기도 해서 지금은 파이프라인 코드가 순서를 강제해요.
- 모델을 바꾸면 규칙을 다시 보세요. 예전 모델용 우회 규칙이 새 모델을 붙잡고 있을 수 있어요.
- 기억 파일은 짧게 유지하세요. 초기 버전의 AGENTS.md가 50만 토큰까지 불어나서 지금은 200줄짜리 목차로 제한해요.
전체 하니스는 오픈소스로 공개돼 있어서 포크한 뒤 우리 회사의 브랜드 토큰, 글꼴, 스킬을 넣어 쓸 수 있어요. 디자인 에이전트를 고민 중이라면 좋은 출발점이 될 거예요.
🐘 코끼리는 설계하고 금붕어가 검토해요: 구글의 'Elephant-Goldfish Model'
AI 코딩 에이전트와 한 시간 넘게 대화하며 기능을 설계해 본 적 있으신가요? 요구사항을 하나하나 짚고 설계 문서까지 꼼꼼히 정리한 뒤 드디어 구현을 맡겼는데, 막상 나온 코드는 생각과 달라요. 대화 중에 분명히 얘기했던 예외 처리가 빠져 있고, 당연히 알 거라 여겼던 부분은 엉뚱하게 만들어져 있죠. 오래 대화할수록 에이전트도 나도 서로 아는 내용을 굳이 문서에 적지 않게 되기 때문이에요. 둘 다 같은 맥락에 익숙해져서 빈칸이 보이지 않는 거죠.
구글이 이 문제를 푸는 방법을 공개했어요. 구글 엔지니어들이 내부에서 쓰던 Elephant-Goldfish Model(EGM) 플러그인을 Apache 2.0 라이선스로 오픈소스화했고 지금도 매일 수천 명의 구글 직원이 실제 서비스 코드를 만들 때 쓰고 있어요.
기억력 좋은 코끼리, 기억이 없는 금붕어
이름 그대로 두 역할로 나뉘어요.
- 코끼리(Elephant): 프로젝트 전체 그림과 기억을 쥐고 있는 긴 세션이에요. 여기서는 코드를 한 줄도 쓰지 않고 설계와 의도만 다뤄요. AI가 사용자를 인터뷰하고 함께 선택지를 따져 보는 자리예요.
- 금붕어(Goldfish): 이전 대화 없이 설계 문서와 문서가 가리키는 소스 자료만 받아 검토하는 세션이에요. 설계자와 같은 맹점을 공유하지 않기 때문에 객관적인 비평가 역할을 해요.
- 사람: 어떤 것을 얻고 무엇을 포기할지 결정하고 구현 전에 설계를 최종 승인해요.
목표는 분명해요. 엔터를 누른 뒤 AI가 처음부터 원하던 코드를 정확히 만들어 내는 것이에요.
3단계로 흘러가는 작업 방식
플러그인은 세 단계로 사용자를 안내해요.
- 아이디어 키우기 (
egm-brainstorm): 코드 금지 규칙 아래에서 요구사항과 장단점을 토론해요. - 설계 문서 쓰기 (
egm-draft): 문제 정의, 기술 계획, 검토한 대안, 바꿀 파일 목록까지 담은 마크다운 설계 문서를 만들어요. - 금붕어 검토 (
egm-review): 기억 없는 AI들이 설계의 약점을 파고들어요.
검토 단계가 핵심이에요. 블로그에 따르면 먼저 금붕어가 문서를 읽고 설계를 다시 설명하는데, 제대로 요약하지 못하면 문서가 모호하다는 신호로 봐요. 다음으로 여러 금붕어가 깐깐한 리뷰어가 되어 예외 상황과 숨은 의존성을 찾아내고, 그 지적은 코끼리에게 돌아가요. 마지막 금붕어는 파일 경로, 데이터 구조, 함수 시그니처가 빠짐없이 적혔는지 확인해 진행 여부를 판정해요. 참고로 지금 저장소 안내에는 검토가 다섯 단계로 나뉘어 있다고 적혀 있어요.
코끼리 세션은 대화 기록을 그대로 유지하지만, 금붕어들은 매번 새 문서만 받아보고 지적은 다시 코끼리에게 돌아가요.
바로 써 보기
구글 제품이지만 다른 도구에서도 사용할 수 있어요. Claude Code라면 claude plugin marketplace add google/elephant-goldfish-model과 claude plugin install egm@egm 두 줄로 설치하고, Codex와 Antigravity도 지원해요. Claude Code에서는 /egm:egm-brainstorm처럼 앞에 /egm:을 붙여 실행해요.

의견을 남겨주세요