
✉️ 제이슨 노트
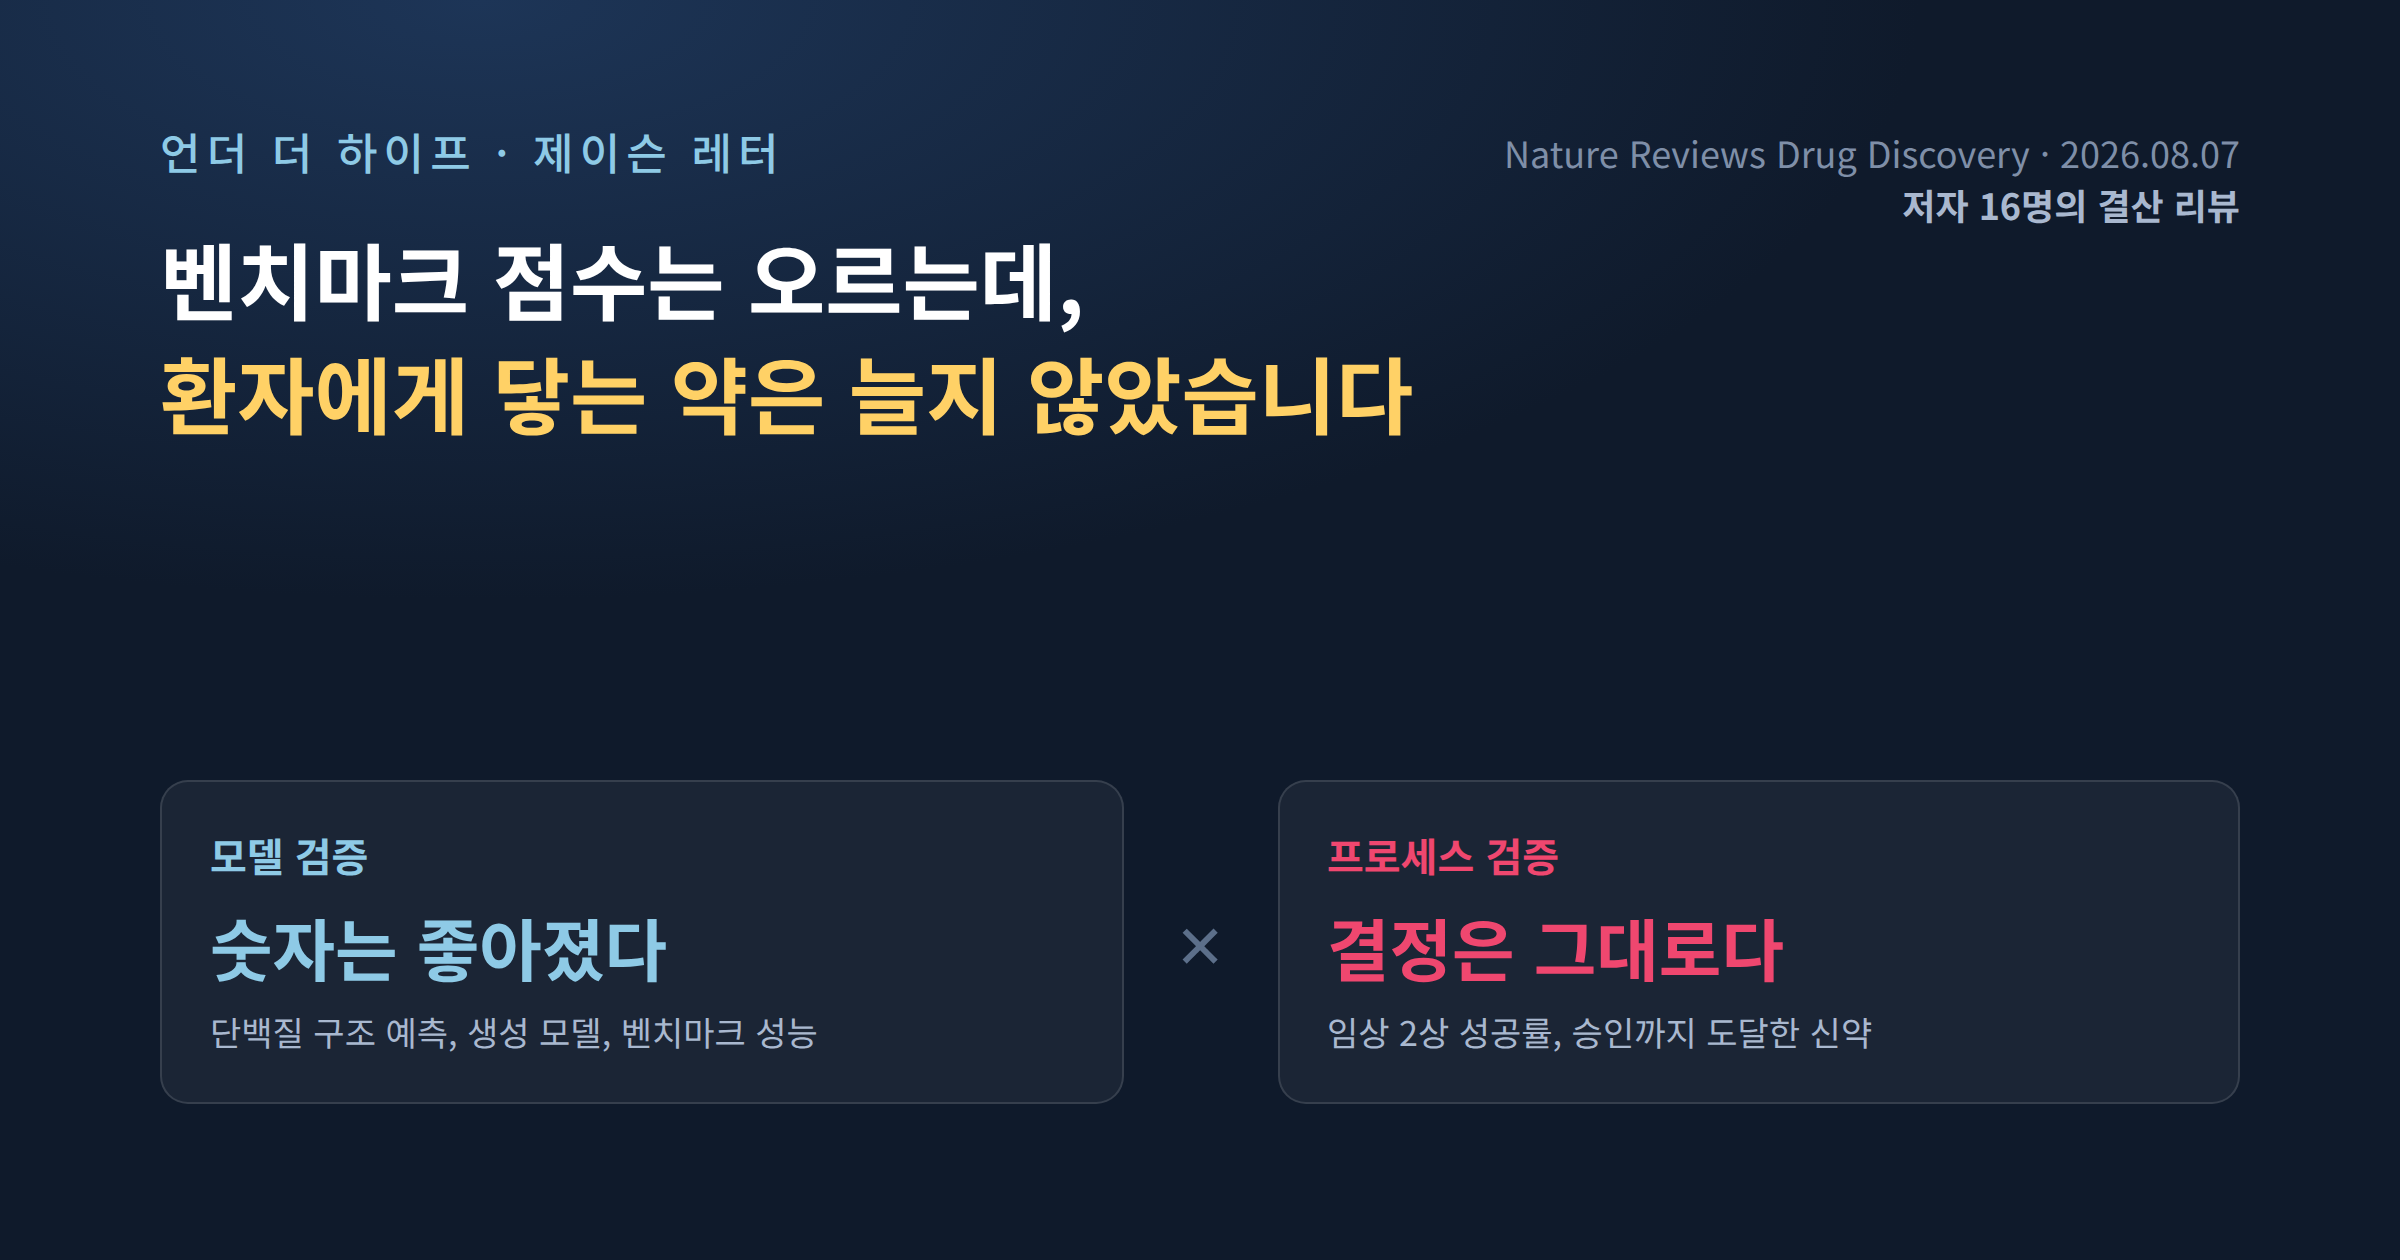
AI 신약개발 10년을 정면으로 결산한 논문이 8월 7일 나왔습니다. 저자 16명이 내린 결론은 이래요. 임상적으로 의미 있는 영향의 증거는 실망스러울 만큼 제한적이다.
모델이 나빠서가 아니에요. 논문이 지목한 건 다른 지점이에요. 우리가 AI에게 예측하라고 시킨 것이 정작 임상 결과와 잘 연결되지 않는다는 것이죠.
같은 주에 국내에서도 큰 움직임이 있었어요. 정부의 AI 신약개발 첫 거점이 대구로 정해졌고, 제약바이오협회는 업계 AI 실태조사를 냈어요. 오늘은 그 논문을 원문으로 읽고, 지표와 목적이 어긋난 지점 세 곳을 따라가 볼게요.
📰 3분 브리핑
▪ 제약바이오협회, AI 신약개발 실태조사 44곳 55명 조사에서 신약개발 부서에 AI 전문인력이 없다는 응답이 67.3%였어요. 활용 분야는 후보물질 식별과 최적화에 몰려 있고요.
▪ K-문샷 AI 신약개발 첫 거점, 대구 과기정통부가 8월 12일 시범사업단을 출범했어요. AI와 실험실이 서로 학습하는 랩인더루프 체계를 내걸었습니다.
▪ LG CNS, 동아쏘시오그룹 AI 신약 플랫폼 구축 AI 예측 결과와 실제 실험 데이터를 계속 연계해 학습시키는 구조예요. 오늘 리뷰가 권고하는 방향과 겹칩니다.
🔍 딥다이브
저자 16명이 내린 결론부터 봅니다
논문은 8월 7일 Nature Reviews Drug Discovery에 실린 관점 논문이에요. 케임브리지의 Andreas Bender가 이끌었고, 저자 16명이 학계와 산업계에 걸쳐 있어요.
가장 널리 인용된 문장은 이거예요. AI 방법론은 다양하게 개발되고 벤치마크됐지만, 임상적으로 의미 있는 영향의 증거는 지금까지 실망스러울 만큼 제한적이다.
다만 저자들은 표현을 신중하게 골랐어요. 지금 상황은 증거의 부재이지, 부재의 증거는 아니라고 못박습니다. AI가 효과 없다는 결론이 아니라, 효과를 확인할 근거가 아직 없다는 뜻이에요.
기술 자체의 진보는 오히려 높이 평가해요. 단백질 구조 예측이 대표적이고, AlphaFold 구조 데이터베이스는 190개국 200만 명이 썼다고 인용합니다. 문제는 그 진보가 임상 성적으로 넘어오지 않는다는 데 있어요.
왜 임상 성적은 그대로일까요
논문이 첫 번째로 짚는 건 노력이 투입된 위치예요.
저자들은 신약개발 단계별로 20%씩 개선했을 때 비용이 얼마나 줄어드는지 계산했어요. 가장 크게 줄어드는 지점은 2상의 실패율이었습니다. 유효성을 처음 검증하는 단계라 성공률이 낮고, 기간도 길고, 비용도 크기 때문이에요.
그런데 현재 AI 활용은 히트 발굴 같은 전임상 앞단에 몰려 있어요. 국내 조사에서도 활용 분야 1위가 후보물질 식별과 최적화였죠.
논문은 이 상황을 가로등 밑에서 열쇠를 찾는 것에 빗댑니다. 라벨이 붙은 데이터가 거기 있으니 거기를 뒤지는 거예요. 열쇠가 있을 만한 곳이 아니라요.
두 번째는 예측 대상 자체의 문제예요. 실험실에서 재는 값과 사람에게서 나타나는 결과가 잘 연결되지 않는 경우가 많거든요.
💊 프록시 데이터 · 진짜 알고 싶은 결과 대신 재기 쉬운 값을 대신 측정한 데이터예요. 간독성을 알고 싶은데 간 오가노이드 독성값을 재는 식이죠.
논문은 실제 사례 둘을 그래프로 보여줘요. 간 오가노이드에서 잰 세포독성값과 환자에게서 나타난 간손상 위험의 상관은 낮았어요. 결합 친화도를 빠르게 재는 열이동 값도 IC50과 거의 어긋났고요. 이런 데이터를 아무리 잘 학습시켜도 임상 결정은 나아지지 않는다는 것이 저자들의 결론이에요.
같은 성능 지표, 정반대의 실전 결과
세 번째 지점이 이 논문의 핵심이에요. 모델 성능이 좋다는 말이 무슨 뜻이냐는 문제요.
💊 AUC · 모델이 정답과 오답을 얼마나 잘 가려내는지 하나의 숫자로 요약한 지표예요. 논문에서 가장 자주 쓰이는 성능 점수고요.
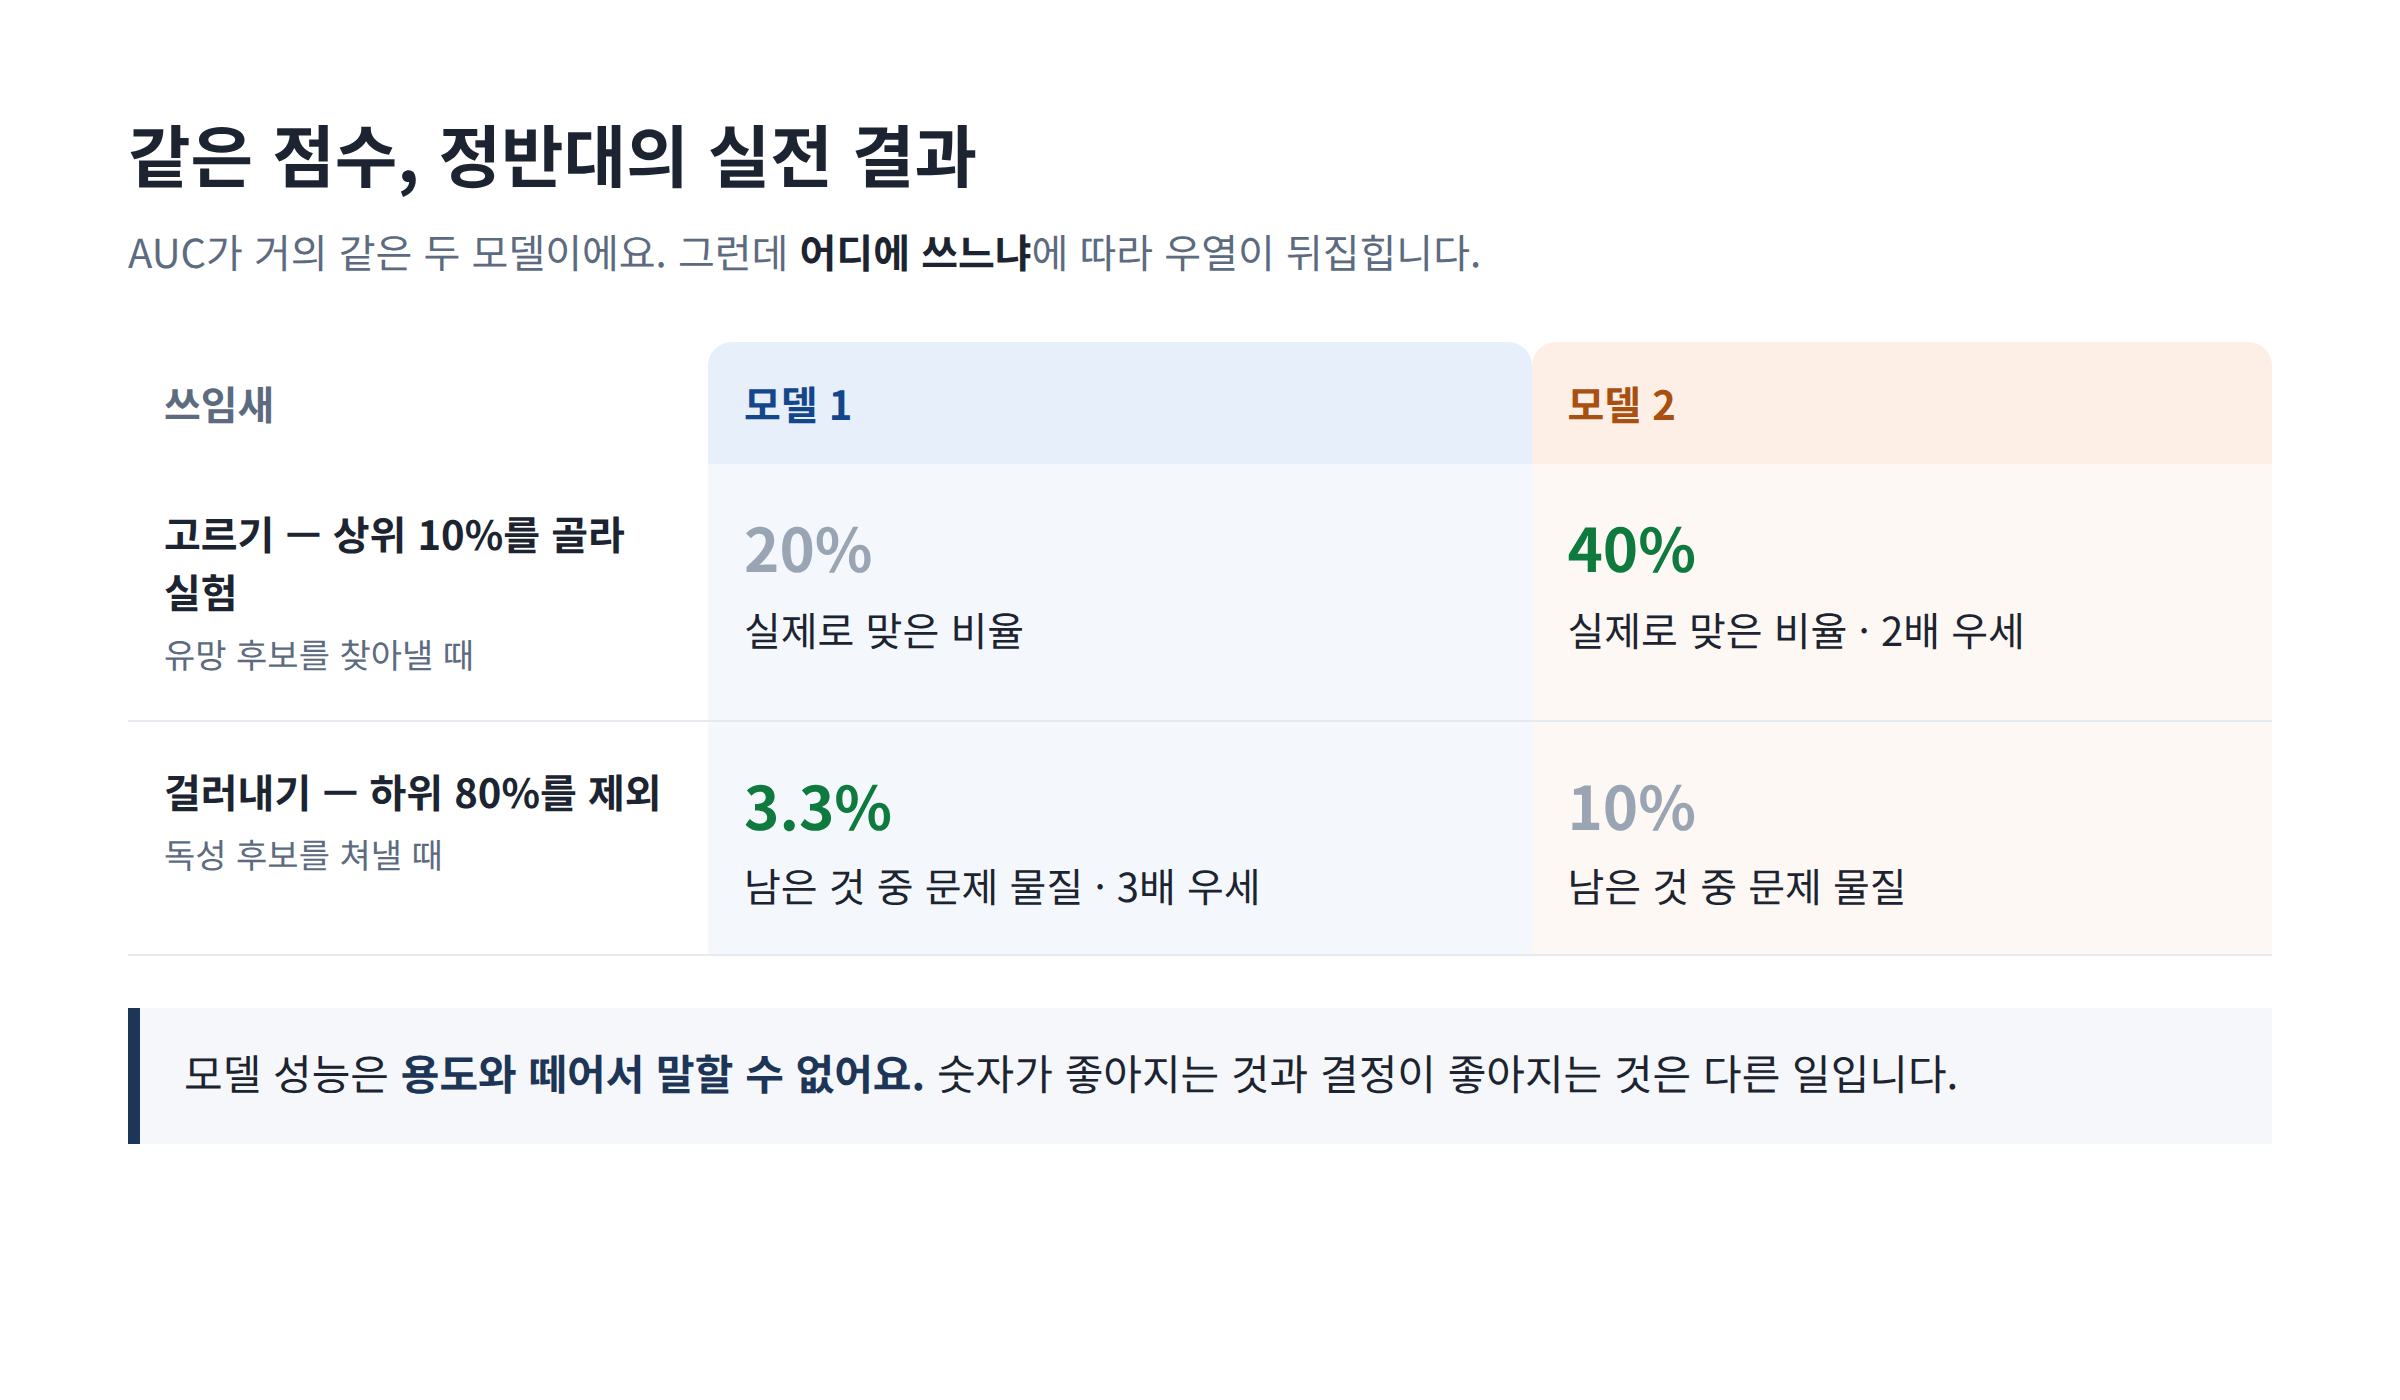
논문은 AUC가 거의 같은 두 모델을 나란히 놓습니다. 상위 10%를 골라 실험하는 상황에서는 2번 모델이 40%, 1번 모델이 20%를 맞혔어요. 그런데 독성 후보를 걸러내는 상황으로 바꾸면 결과가 뒤집혀요. 하위를 잘라내고 남은 것을 실험했을 때, 1번 모델은 3.3%만 문제 물질이었고 2번 모델은 10%였습니다.
같은 점수를 받은 두 모델이 용도에 따라 두세 배씩 갈린 거예요. 그래서 저자들은 모델 검증과 프로세스 검증을 구분하자고 제안해요. 숫자가 좋아지는 것과 프로젝트의 결정이 좋아지는 것은 다른 일이라는 뜻이죠.
논문이 굿하트 법칙을 인용하는 대목도 여기예요. 어떤 측정값이 목표가 되는 순간 그 값은 좋은 측정값이기를 멈춘다는 법칙이에요. 벤치마크 점수를 올리는 경쟁이 실제 진보의 착시를 만든다고 저자들은 지적합니다.
그래서 무엇을 봐야 할까요
논문은 모델의 가치를 한 줄로 정의해요. 임상 성공률을 얼마나 끌어올리는지, 그리고 그 모델을 얼마나 여러 프로젝트에 쓸 수 있는지의 곱이라고요.
이 정의를 만족한 사례로 바이오마커를 듭니다. 환자를 골라내는 데 바이오마커를 쓴 프로젝트는, 쓰지 않은 프로젝트보다 성공 1건당 비용이 대략 절반이었어요. 2000년부터 2015년까지 후보물질 약 2만 1천 건을 분석한 결과예요. 유전적 근거가 있는 표적이 임상에서 약 2.6배 성공하기 쉽다는 수치도 같은 맥락이고요.
저자들이 반복하는 표현이 테크놀로지 푸시와 사이언스 풀이에요. 만들 수 있는 데이터를 먼저 만들고 나중에 용도를 찾으면 테크놀로지 푸시예요. 어떤 결정에 어떤 데이터가 필요한지 정하고 그것부터 만들면 사이언스 풀이고요. 지금 이 분야는 앞쪽으로 기울어 있다는 진단입니다.
🔍 원문을 열어보니 — 성과가 없다는 뜻이 아니라, 최적화 대상이 어긋났다는 진단입니다
논문은 AI 무용론을 펴지 않아요. 기술 진보는 인정하고, 증거의 부재와 부재의 증거를 구분합니다. 다만 임상 2상을 움직이지 못하는 지표를 아무리 올려도 환자에게 닿는 약은 늘지 않는다고 말해요. 승인 건수가 없는 이유를 시간 부족으로만 보는 통념과 갈리는 지점이 여기예요.
어떻게 확인했나 · 논문 전문을 직접 읽고 수치와 그림 설명을 확인했어요. 저자들이 공개한 무료 열람 링크도 아래에 붙였고요. 국내 동향은 각 매체 원문으로 확인했습니다. 저자 다수가 제약사와 AI 기업의 주주 또는 임원이라는 이해관계 고지가 논문 말미에 실려 있다는 점도 함께 밝혀둘게요.
👥 직군별 생각 포인트
💼 제약회사에 계시다면 — AI 도입 문서에서 이 모델이 무엇을 예측하는가를 찾아보세요. 답이 결합 친화도나 물성 예측에 머물러 있다면, 그 성과는 2상 성공률로 넘어오기 어려워요. 논문의 표현대로면 열쇠가 있을 만한 곳이 아니라 밝은 곳을 뒤지는 셈이에요.
🏥 병원·임상약사라면 — 이 논문이 가장 높이 평가한 개입은 바이오마커로 환자를 고르는 일이었어요. 성공 1건당 비용을 절반으로 줄인 것이 알고리즘이 아니라 환자 선별이었죠. 임상시험 참여나 정밀약료 논의에서 약사가 기여할 자리가 여기예요.
🏛️ 공직·기관에 계시다면 — 대구 거점이 내건 랩인더루프는 논문의 권고와 방향이 같아요. 다만 평가 지표를 후보물질 발굴 건수로 잡으면 논문이 지적한 함정을 그대로 반복하게 돼요. 무엇을 몇 개 찾았는지가 아니라 그 예측이 어떤 결정을 바꿨는지를 지표에 넣을 시점이에요.
📎 한 걸음 더
▪ 논문 무료 열람 링크저자들이 공유한 링크예요. 결제 없이 전문을 읽을 수 있어요.
▪ 논문 원문 페이지그림과 보충자료, 이해관계 고지까지 확인할 수 있어요.
▪ PubMed 초록요지만 빠르게 훑고 싶을 때 좋아요.
🎯 직접 확인해보기 · 논문 5번 그림 하나만 보셔도 돼요. 같은 점수를 받은 두 모델이 용도에 따라 갈리는 그래프인데, 성능 숫자를 읽는 눈이 바뀌어요.
💌 푸터
여러분 조직이 쓰거나 검토 중인 AI는 무엇을 예측하고 있나요? 답장으로 알려주세요. 사례를 모아 다음 호에서 이어가 볼게요. 요즘 이거 진짜야 싶었던 AI 제약·헬스케어 소식도 언제든 환영이에요.
다 읽어요.
의견을 남겨주세요