👀 Jev 결정 모델, 이제 눈도 달렸어요!: Jev 1.14 업데이트
지난 오토마타 V.34호에서 소개해 드린 '말하지 않는 AI' Jev 기억하시나요? 글을 쓰는 대신 정해진 형식으로만 답하는 '결정 모델'이었죠. 선택지를 고르거나 점수를 매기거나 참일 확률을 알려 주는 식이에요. 그 Jev의 새 버전이 나왔어요. TypeSafe AI는 10월 14일 jev-1.14.0을 출시했어요.
새로운 기능 세 가지
TypeSafe는 새로운 실험 기능 세 가지를 "위험은 각자 감수하고 들어오세요"라는 문구와 함께 공개했어요. 이 기능들은 기본으로 꺼져 있어요. API를 호출할 때 TypeSafe-Danger-Zone-으로 시작하는 헤더(요청에 함께 보내는 설정 꼬리표)를 기능마다 직접 붙여야 켜져요.
- 이미지 입력: PNG나 JPEG 형식의 이미지를 넣을 수 있어요. 가로와 세로는 각각 256~1,568픽셀, 파일 크기는 최대 16MiB(약 16.8MB)예요.
- 입력 방법: 요청에
TypeSafe-Danger-Zone-Images: true헤더를 붙이고 이미지는assets라는 칸에 원하는 이름표(예: UUID)를 달아 넣어요. 질문이나 입력 데이터 안에 그 이름표를 적으면 API가 그 자리에 이미지를 끼워 넣어요. 이 헤더는 1.13에서도 통하고, 헤더 없이 이미지를 보내면 오류(400)가 나요. - 나오는 답: 사진을 넣어도 Jev가 그림을 그리거나 사진을 글로 설명해 주지는 않아요. 답은 여전히 고르기, 점수, 참/거짓 확률 같은 정해진 형식으로 나와요. 예를 들어 "사진에 커피잔이 있나?"를 Noul로 물으면 확률 하나가 돌아와요. 위치까지 알고 싶다면 아래 박스 유형을 쓰면 돼요.
- 박스(Box) 질문 유형: 기존의 고르기(Choice), 점수(Score), 참/거짓 확률(Noul)에 이어 네 번째 유형이 생겼어요. 사진 속 대상 하나를 찾아 위, 아래, 왼쪽, 오른쪽 끝의 위치를 확신도와 함께 돌려줘요. 위치는 사진 왼쪽 위를 기준으로 0~1 사이 비율로 나와요. 이 유형은 1.14에서만 쓸 수 있어요. 주의할 점도 있어요. 박스 질문에는 "못 찾음"이라는 답이 없어서 사진에 없는 물건을 물어도 좌표가 나와요. 그래서 같은 대상에 대한 Noul 질문을 함께 던져 보고 확률이 낮으면 박스 결과는 버리라고 권해요. 또 박스는 대상을 사각형으로 감쌀 뿐 픽셀 단위로 정확히 오려내는 분할(Segmentation)은 아니에요.
- 긴 컨텍스트: 컨텍스트(Context)는 한 번에 넣을 수 있는 입력의 길이예요. 기본 한도는 요청당 64,000토큰인데 헤더를 붙이면 262,000토큰까지 늘어나요.
어떻게 활용할 수 있을까?
공식 문서는 Jev를 글로 된 데이터에 대해 좁고 정해진 판단을 내리는 데 쓰라고 안내해요. 답장을 쓰거나 코드를 만들거나 다음 행동을 스스로 고르지는 않아요. 답변하는 형식이 단순한 대신 판단 속도가 LLM과 비교할 수 없을 정도로 빨라요. 대부분의 요청이 아주 빠른 시간 안에 끝나서 실시간 서비스 안에 넣어도 될 정도예요.
공식 문서에 나온 예시는 이래요.
- 고객 문의 분류: 문의가 결제, 기술, 계정 중 어느 팀 담당인지 고르고(Choice), 고객이 얼마나 화가 났는지 0~2점으로 매기고(Score), 환불을 요청하는지 참/거짓으로 판단해요(Noul).
- 스팸과 피싱 걸러내기: 메시지가 비밀번호 같은 민감한 정보를 요구하는지, 보낸 사람이라고 밝힌 이름과 도메인이 어긋나는지, 뜻밖의 보상을 내세우는지를 따로따로 물어요.
- 계약서 검토: "어느 한쪽이 계약을 일찍 끝낼 수 있는 조항이 있나?"처럼 문서 안에 특정 조항이 있는지 물어요.
- 중복 이력서 찾기: 새 이력서를 기존 지원자 기록과 하나씩 비교해 같은 사람인지 물어요.
Jev를 잘 쓰는 요령도 문서에 정리돼 있어요.
- 큰 질문은 잘게 쪼개기: "이 스타트업 피치를 평가해 줘" 대신 시장 규모, 기술 실현 가능성, 차별성을 따로 묻고 점수는 내 코드에서 합쳐요. 우선순위가 바뀌면 프롬프트를 다시 쓸 필요 없이 코드의 가중치만 고치면 돼요.
- 질문은 한 번에 많이: 한 요청에 넣은 질문들은 동시에 처리돼서 질문을 늘려도 응답 시간이 거의 늘지 않아요. 당장 필요할지 모르는 질문까지 미리 넣어 두고 쓸 답만 코드에서 골라 쓰는 방식도 권해요.
- 확신도로 갈림길 만들기: 정답 확률이 낮은 답은 사람이나 더 비싼 추론 모델에게 넘겨요. 문서 예시에서는 확신도가 0.8보다 낮으면 사람이 검토하도록 Jev를 사용해서 설계할 수 있어요.
⚡ GPT Luna보다 8배 빠른 새로운 형태의 LLM: Mercury 3
ChatGPT나 Claude가 답을 쓸 때 글자가 한 줄씩 흘러나오는 모습 익숙하시죠? 대부분의 AI는 앞 단어를 보고 다음 단어를 하나씩 이어 쓰는 방식이라 그래요. 그런데 이 공식을 깨는 모델이 크게 성장해서 돌아왔어요. 바로 Inception이 10월 19일 공개한 확산(Diffusion) 방식 언어 모델 'Mercury 3'예요.
확산 LLM이 뭐길래 빠를까?
기존 AI를 '한 글자씩 받아쓰는 사람'이라고 하면 확산 모델은 '초안을 통째로 쓰고 여러 번 고쳐 다듬는 사람'에 가까워요. 흐릿한 초안 전체를 놓고 여러 부분을 동시에 다듬어 가는 방식이라 앞 단어가 끝나길 기다릴 필요가 없어요. 이미지 생성 AI(Stable Diffusion)가 노이즈에서 그림을 만들어 내는 원리를 글에 적용한 거예요.
그동안 확산 LLM은 "빠르지만 똑똑하지 않다"는 평가를 받아 왔어요. Inception은 이번에 그 의문에 답하겠다고 나섰어요. Mercury 3는 첫 모델인 Mercury 1보다 40배 이상 크고, 표준 벤치마크 기준 지능은 3배 높아졌는데도 속도는 여전히 빠르다고 해요.
GPT와 비교하면? 숫자로 보는 Mercury 3
비교 대상은 OpenAI와 Anthropic의 빠르고 저렴한 모델이에요.
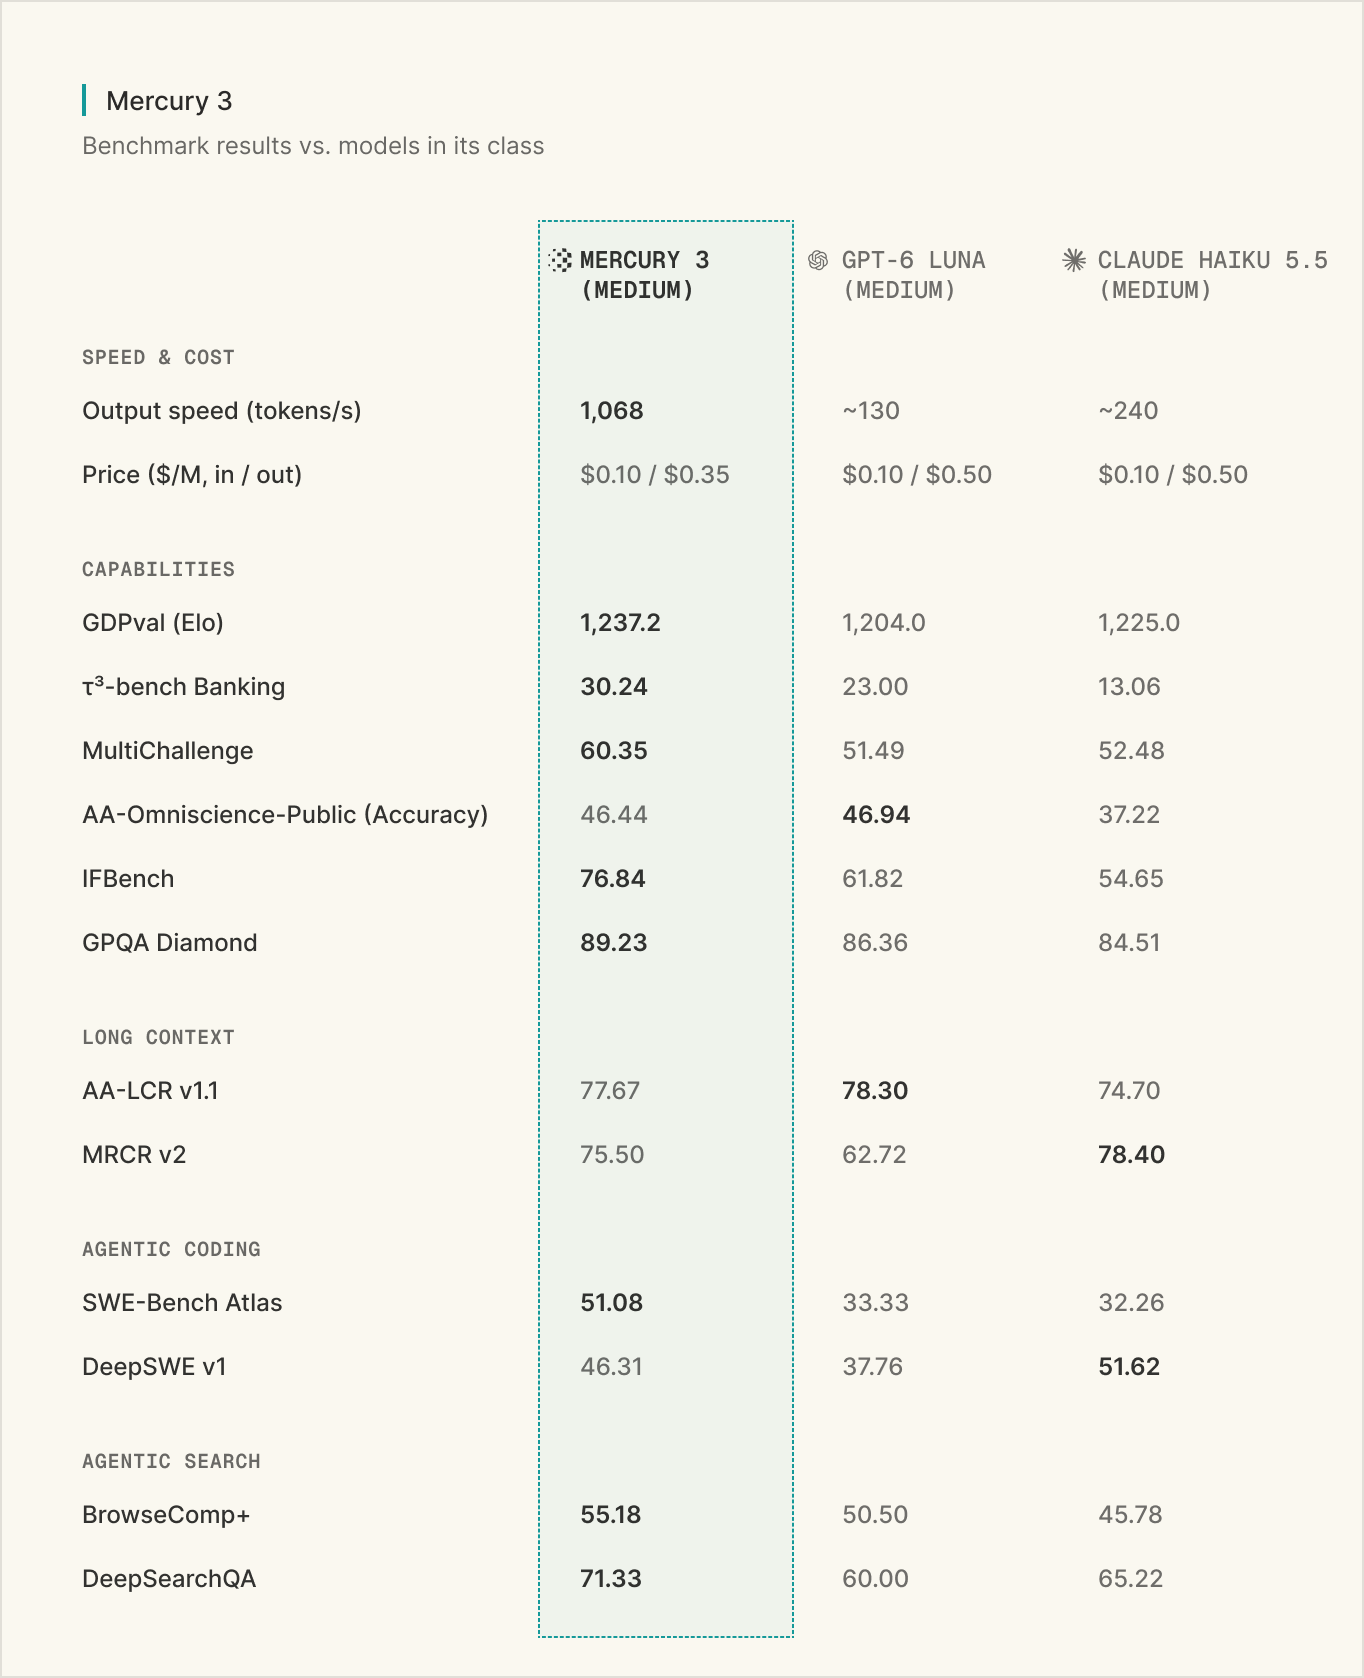
- 성능: GPT-6 Luna, Claude Haiku 5.5와 같거나 더 낫다고 주장해요. Inception이 공개한 벤치마크 표에서는 12개 중 8개 항목에서 두 모델을 앞섰어요.
- 속도: NVIDIA GPU에서 초당 1,068토큰, 두 경쟁 모델보다 4~8배 빠르다고 해요.
- 컨텍스트: 100만 토큰으로, 이전 Mercury 2.5의 26만 토큰에서 크게 늘었어요.
- 가격: 입력 100만 토큰당 $0.20, 출력 $0.70이고 출시 기념으로 50% 할인해 $0.10/$0.35에 제공해요.
어디에 쓰면 좋을까?
속도가 곧 사용자 경험이 직접적으로 연결된 곳에서 사용하면 좋아요. 초기 파트너들의 사례를 한 번 살펴볼게요.
- 웹 탐색 에이전트: 기업용 웹 자동화 에이전트를 만드는 TinyFish AI는 실제 웹 탐색 과제 50개에서 Mercury 3가 50%를 완료해 GPT-6.1-Sol보다 훨씬 많이 해냈다고 밝혔어요. 에이전트는 단계마다 모델을 기다리니 한 번의 응답 속도가 전체 작업 시간을 좌우해요.
- 실시간 학습 도우미: 국제 바칼로레아(IB) 학생용 AI 학습 플랫폼 RevisionDojo는 힌트와 채점 결과가 약 1초 만에 돌아와 학생이 기다리지 않고 공부를 이어 간다고 해요.
도입도 쉬운 편이에요. OpenAI API와 호환돼서 Hermes Agent를 포함한 수많은 에이전트에서 그대로 쓸 수 있고 무료 토큰 1억 개를 지원해요.
Mercury 3는 공식 사이트에서 API키를 발급받아서 원하는 서비스에 연결시킬 수 있어요.
자세한 소개글도 아래 링크에서 확인 가능해요
의견을 남겨주세요