🛡️ 눈에는 눈, AI 공격에는 AI 방어: Anthropic의 '사이버 미션'
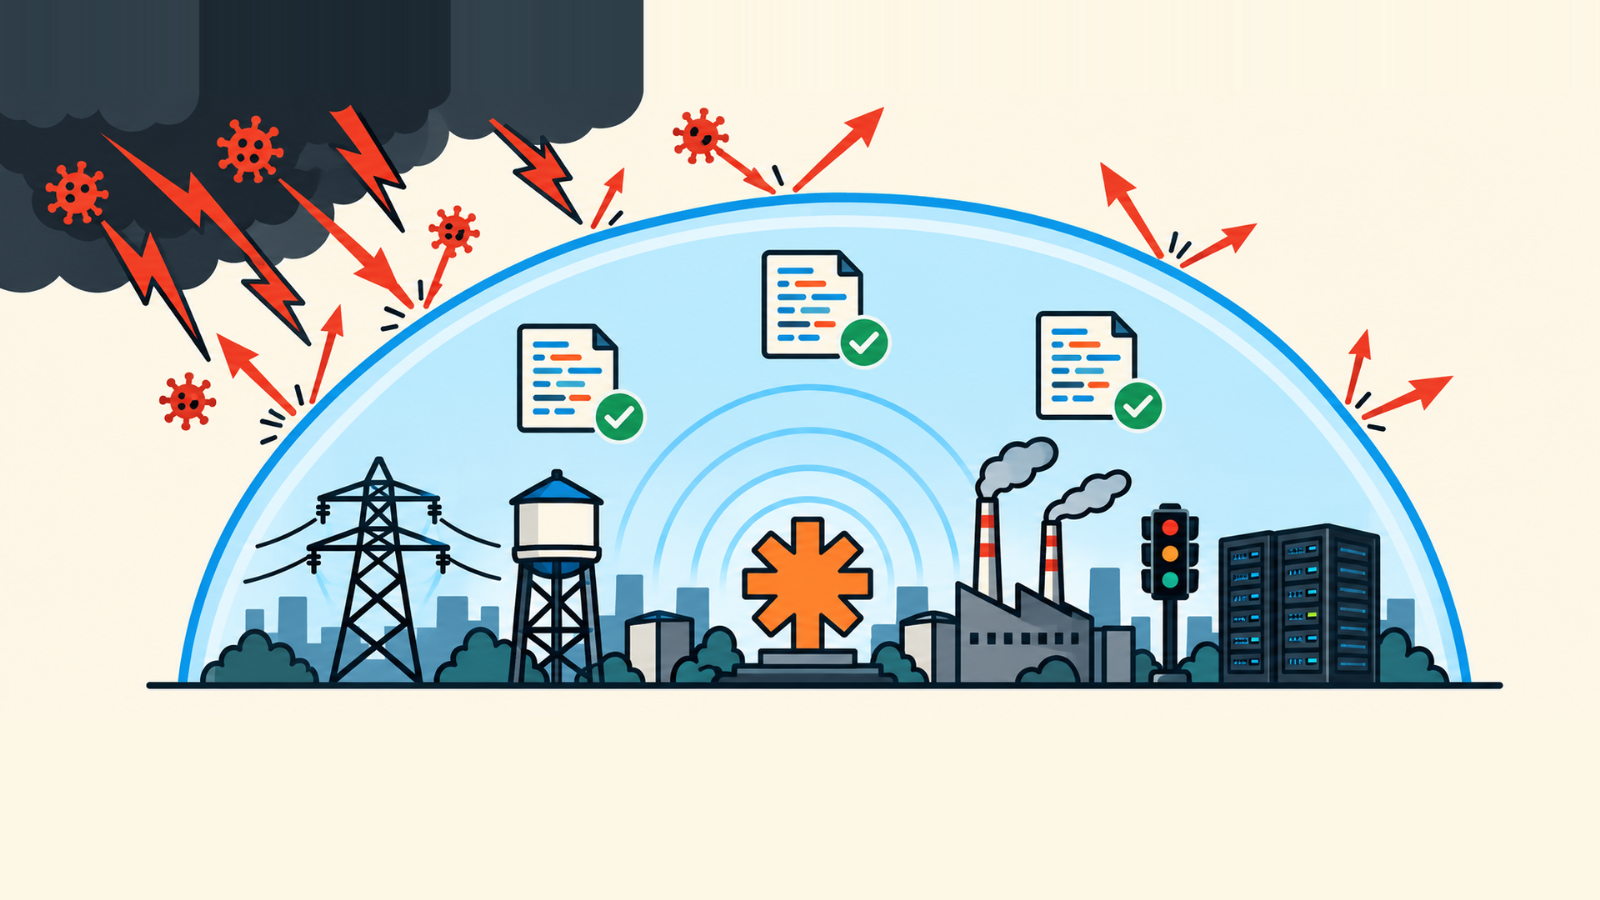
AI가 해커의 무기가 되고 있다는 얘기는 많이 들으셨을 거예요. 그런데 거꾸로 "AI를 방어자 편에 세우겠다"는 선언이 나왔어요. Anthropic이 지난 10월 8일, 전력망부터 오픈소스 코드까지 지키겠다는 장기 프로젝트 'Anthropic Cyber Mission'을 공개했습니다. 스스로 이를 "모두가 의존하는 시스템을 지키기 위한 장기적 헌신"이라고 표현했어요. (CellCog)
왜 지금, 방어가 더 급해졌나
Anthropic은 "공격자들은 이미 고도의 사이버 능력을 가진 AI 모델을 폭넓게 쓸 수 있지만, 자사 것을 포함한 방어 도구는 정작 필요한 방어자들에게 충분히 닿지 못했다"고 밝혔어요. (Salesforce Ben) 아이러니하게도 프론티어 AI 모델 자체가 취약점 악용 비용을 낮춰온 주범이기도 한데요, Anthropic도 이 점을 인정하면서 "AI가 결함을 찾아내는 속도를 앞당긴 반면, 이를 검증하고 고치는 건 여전히 느리고 사람 손에 의존하는 과정"이라고 설명했습니다. (Salesforce Ben)
먼저 전력망과 오픈소스부터 시작해볼게요
Cyber Mission은 같은 날 발표된 두 프로그램으로 시작해요.
- Critical Infrastructure Defense Program(CIDP): 전력망·수도·공장·교통망 같은 운영기술(OT) 시스템을 지키는 보안 기업들에게 Anthropic의 프론티어 Claude 모델과 상주 엔지니어, 위협 연구를 지원해요. 창립 파트너는 Accenture, Booz Allen, CrowdStrike, Deloitte, Dragos, Hitachi, Insane Cyber, Nozomi Networks, Palo Alto Networks, PwC, Rockwell Automation까지 총 11곳이에요. (CellCog) OT 시스템은 계속 가동돼야 하는 특성상 패치를 위해 멈추기 어렵고, 그래서 알려진 취약점도 수년간 방치되는 경우가 많다고 Anthropic은 지적했어요. (CellCog)
- OSS Scanner: 오픈소스 프로젝트를 위한 무료 옵트인 보안 스캔 서비스예요. Anthropic의 최상위 모델이 주기적으로 코드를 스캔해, 취약점 증명(PoC)과 가능하면 수정 제안까지 담은 보고서를 보내줘요. (Unite.AI)
사람 검토 없는 보고서라는 과감한 선택
OSS Scanner의 가장 눈에 띄는 특징은 보고서가 사람의 검토 없이 그대로 발송된다는 점이에요. Anthropic은 진양성률(true-positive rate)이 90%를 넘을 것으로 예상하면서도, 틀린 심각도 판정 같은 오류가 섞일 수 있다는 점을 미리 인정했어요. (CellCog) 이는 이전 프로젝트인 Project Glasswing 에서 쌓은 경험 덕분에 가능해진 선택인데요, Glasswing에서는 2026년 10월까지 6,000건 넘는 보고서를 사람이 직접 검토해왔습니다. (CellCog) 더 빠른 속도를 원하는 유지보수자를 위해 검토 없는 속도라는 선택지를 새로 만든 셈이죠. Project Glasswing은 지난 4월 AWS, Apple, Cisco, Google, Microsoft, NVIDIA 등과 함께 발표됐고, Claude 크레딧 최대 1억 달러와 직접 기부금 400만 달러를 오픈소스 보안 단체에 투입한 바 있어요. (Unite.AI) 이달 6일에는 보안팀 접근 등급을 세분화한 'Cyber Verification Program' 확장판도 선보였고, Glasswing은 이 프로그램으로 흡수 통합됐어요. (Industrial Cyber)
그래서, 2년 뒤엔 안전할 수 있을까요?
Anthropic은 "2년 안에는 AI가 공격보다 방어에 유리해질 것"이라 내다봤지만, 동시에 Glasswing에서 "취약점이 발견되고 실제로 고쳐지기까지 수개월이 걸리는 경우를 자주 봤다"고 고백했어요. (CellCog) 결국 핵심은 "누가 더 빨리 뚫느냐"가 아니라 "찾아낸 문제를 누가 더 빨리, 안전하게 고치느냐"의 싸움으로 넘어가고 있다는 거예요. AI가 공격과 방어 양쪽의 속도를 동시에 끌어올리는 지금, Anthropic의 이번 베팅이 실제로 격차를 좁힐 수 있을지는 앞으로 1~2년이 보여줄 것 같아요.
🔍 소스 코드 없이도 앱을 복제한다? AI 에이전트의 새 무기, REA
구독자님, 혹시 "소스 코드가 없는데 저 기능을 어떻게 똑같이 만들지?"라는 생각 해보신 적 있나요? 최근 개발자 커뮤니티를 뜨겁게 달군 오픈소스 프로젝트 REA(Reverse Engineer Anything)가 바로 이 질문에 답을 내놨어요. AI 에이전트에게 리버스 엔지니어링 능력을 통째로 쥐여주는 MCP 서버인데, 공개 6개월 만에 깃허브 스타가 7만 개까지 치솟았다고 해요.
REA가 뭐길래 이렇게 화제일까요?
REA는 Claude Code, Codex, Cursor, Gemini CLI 같은 AI 코딩 에이전트에 리버스 엔지니어링 도구를 MCP로 연결해주는 오픈소스 툴킷이에요. MIT 라이선스로 공개돼 있고 모든 분석은 로컬에서 실행돼요. 네이티브 바이너리뿐 아니라 자바스크립트·일렉트론 앱, .NET 어셈블리, 안드로이드 APK, 웹사이트, 펌웨어, 웹어셈블리까지 폭넓은 포맷을 다룰 수 있고요. 설치도 npx rea-agents setup 명령어 하나면 끝나요.
작동 방식: 분해-이해-재현 3단계 루프
REA는 모든 분석을 '디컴파일(Decompile) → 이해(Understand) → 재현(Recreate)' 3단계로 설명해요. 먼저 앱을 열어 읽을 수 있는 코드와 심볼, 문자열 같은 단서를 복원하고, 그다음 기능이 어떻게 동작하는지 코드를 따라가며 이해한 뒤, 마지막으로 그 결과를 내 스택에 맞는 기능으로 재구현하는 방식이에요.
중요한 건 REA가 결과물을 그냥 "정답"이라고 던져주지 않는다는 점이에요. 에이전트는 의사코드(pseudocode)와 함께 "아직 밝혀내지 못한 부분(unknowns)"까지 받아서, 이를 바탕으로 직접 구현 코드를 쓰고 원본과 테스트하며 일치할 때까지 반복해요.
실제로 얼마나 잘 동작할까?
한 실험 사례에서는 고전 게임 DX볼의 사운드 계산 로직을 C로 복원했는데, 원본 테스트 케이스 3,205개를 전부 통과했고 컴파일된 63바이트가 원본과 완전히 일치했다고 해요(출처). 다만 MindStudio의 핸즈온 비교 테스트는 조금 다른 이야기를 들려줘요. 맥의 Preview 앱을 REA로 재구현한 버전과, REA 없이 스크린샷만 보고 추론한 일반 에이전트 버전을 나란히 돌려봤더니 둘 다 확대/축소, 주석, 그리기, 회전, 저장 기능을 갖춘 작동하는 클론을 만들어냈고, 오히려 REA 없는 버전이 먼저 완성됐다고 해요(출처). 또한 REA가 쓰는 분석 엔진들 자체는 전혀 새로운 기술이 아니에요. Ghidra는 2019년 NSA가 공개했고, Hopper는 2011년, IDA는 1990년대부터 있었던 도구거든요. REA는 이들을 에이전트가 쓸 수 있게 이어주는 '연결 고리'에 가까워요(출처).
과장된 기대와 실제 리스크
REA에 쏟아지는 관심 중 상당 부분은 실제 데모보다 깃허브 스타 그래프에 기대고 있다는 지적도 나와요. 스타 수가 몇 주간 정체하다가 최근 급등한 흐름은 기술적 도약보다 입소문 사이클에 가깝다는 분석이에요(출처). 더 중요한 건 안전과 합법성 문제예요. 소셜미디어에서도 "바이너리 분석을 에이전트에 맡길수록 검증 경로와 라이선스 경계를 함께 남겨두는 운영 방식이 중요해질 것"이라는 신중한 반응이 이어지고 있어요(출처).
소프트웨어 개발은 이제 끝난걸까요?
REA는 "소스 코드가 없어도 괜찮다"는 전제를 현실로 만든 사례예요. 전문가의 영역이었던 디컴파일과 바이너리 분석이 자연어 한 문장으로 가능해지고 있다는 거죠. 다만 지금 당장은 일반 코딩 에이전트의 추론만으로도 비슷한 결과를 낼 수 있다는 점, 그리고 저작권과 보안 측면의 회색지대가 여전히 크다는 점을 함께 기억해두시면 좋을 것 같아요.
🔍 "코딩 에이전트가 소프트웨어 회사를 대체한다"는 이야기, 그 반대편 목소리도 들어볼까요?
바로 앞 소식에서 AI 에이전트가 소스 코드도 없는 앱을 뜯어보고 똑같이 재현해내는 REA 이야기를 전해드렸는데요, 이번엔 그 반대편 목소리예요. LLM 연구원 Niels Mündler가 직접 코딩 에이전트 4개에게 각각 100달러 예산을 주고 "뛰어난 PDF 에디터를 처음부터 만들어보라"고 시켜본 실험인데, 결과는 "쓸 만은 한데, 훌륭하진 않다"였어요. 몇 번 클릭해보면 거의 모든 결과물에서 버그가 발견됐다고 해요. 남의 코드를 베끼는 데는 능숙한 에이전트가, 정작 새로운 걸 처음부터 만들 때는 왜 이렇게 허점투성이일까요. 코딩 에이전트의 가능성만큼이나, 아직 남은 숙제도 짚어볼 필요가 있어 보여요.
$100 실험: 에이전트들에게 맡긴 숙제
저자는 Gemini 3.8 Flash, GPT Astra 6, Opus 5, Fable 5 네 개 모델에게 각자 독립된 가상머신과 100달러 예산을 주고 "뛰어난 사용자 경험을 가진 오픈소스 PDF 에디터를 만들라"고 지시했어요. 기존 도구들을 조사하고 사용자들이 아쉬워하는 점까지 인터넷에서 찾아보라는 구체적인 주문도 덧붙였죠. 흥미로운 건 네 모델이 서로 영향을 주지 않도록 비공개로 작업했는데도, 결국 모두 똑같이 '웹앱'을 만들기로 선택했다는 점이에요.
저자는 이걸 첫 번째 실책으로 꼽아요. PDF 에디터는 시스템에 기본 뷰어로 설치되어야 진짜 쓸모가 있는데, 어떤 모델도 네이티브 앱이나 설치 가능한 실행 파일을 만드는 데 공을 들이지 않았다고 해요. 모든 운영체제에서 돌아가게 하려다 보니 오히려 범용성이 떨어지는 역설이 생긴 셈이에요.
사람처럼 써보지 않아서 생기는 버그들
더 눈에 띄는 건 인터페이스 디테일이었어요. Gemini가 만든 첫 버전은 이미지를 삽입할 때 커서를 클릭한 위치에 바로 꽂아버려서, 어디에 놓일지 미리 볼 수도 없고 나중에 선택해서 옮기거나 지울 수도 없었다고 해요. 반면 Claude(Astra)와 Codex 계열은 이미지를 아무 곳에나 넣고 드래그로 옮기게 해서 이 문제를 자연스럽게 피했다고 하고요. "직관적으로 만들라"는 주문에 대한 해석도 제각각이었는데, Astra는 모든 버튼에 긴 텍스트 설명을 붙였고 Gemini는 아이콘 버튼을 지나치게 많이 만들었어요. 둘 다 사람이 직관적으로 느끼는 디자인 문법과는 거리가 멀었다는 지적이에요.
속도 문제도 비슷한 맥락이에요. 저자가 별도로 다뤄본 코딩 에이전트 기반 프로젝트 Gramps-Web 사례에서는, 족보 데이터가 1,500명 정도만 돼도 UI가 눈에 띄게 느려졌고, 원인을 들여다보니 백엔드 요청들이 순차적으로 느리게 호출되고 있었다고 해요. 이 문제는 아무도 먼저 알아채거나 고치지 않았고, Codex에게 명확한 힌트를 주고서야 해결됐다고 합니다.
부족한 야심과 넘쳐나는 버그
기능 범위를 보면 네 모델 모두 이미지 삽입, 서명, 주석, 도형, 텍스트 가리기(레댁션), 페이지 재정렬 정도의 기본기만 구현했어요. Fable은 하이라이트와 텍스트 외에는 워터마크도, 다중 선택도 지원하지 않을 만큼 최소한에 그쳤고, Opus만 유일하게 PDF 안의 기존 텍스트를 편집하는 다소 야심 찬 기능을 시도했다고 해요. 그런데 ChatGPT로 간단히 검색만 해봐도 이미 대중적인 PDF 에디터 세 곳 이상이 지원하는 기능이라, 에이전트들의 '야심'은 시장 기준에 한참 못 미쳤던 셈이죠.
버그 목록도 길어요. Gemini 버전은 내보낸 PDF의 이미지가 비뚤어지고 다크모드에서 색이 반전됐고, Opus의 텍스트 편집기는 글자를 수정하면 폰트가 바뀌어버렸으며, 레댁션 박스를 적용하지 않고 두면 편집 상자가 화면에 그대로 남아있는 문제도 있었다고 해요. 심지어 버그를 신고할 버튼이나 소스코드 링크조차 어떤 앱에도 없었다고 합니다.
왜 이런 일이 반복될까?
코딩 에이전트는 사람처럼 소프트웨어와 상호작용하지 않는다는 거예요. 사람은 구체적인 목표를 갖고 쓰다가 막히면 바로 불편함을 느끼지만, 에이전트는 그런 목표 지향적 마찰을 경험하지 않고, 화면(UI)도 사람만큼 자주 들여다보지 않는다는 분석이에요. 이런 상호작용 방식이 바뀌지 않는 한, 앞으로도 어딘가 거슬리는 AI 슬롭 소프트웨어가 계속 나올 수밖에 없다는 게 저자의 전망이에요. 결국 코딩 에이전트가 쏟아내는 결과물을 실제로 클릭해보고 불편함을 지적해줄 사람의 역할은 당분간 사라지지 않을 것 같아요.
실험에서 각 LLM이 어떤 식으로 PDF 뷰어를 만들었는지 확인하고 직접 사용해보고 싶으시면, 아래 링크에서 네 모델의 결과를 확인할 수 있어요
원본 블로그:
의견을 남겨주세요