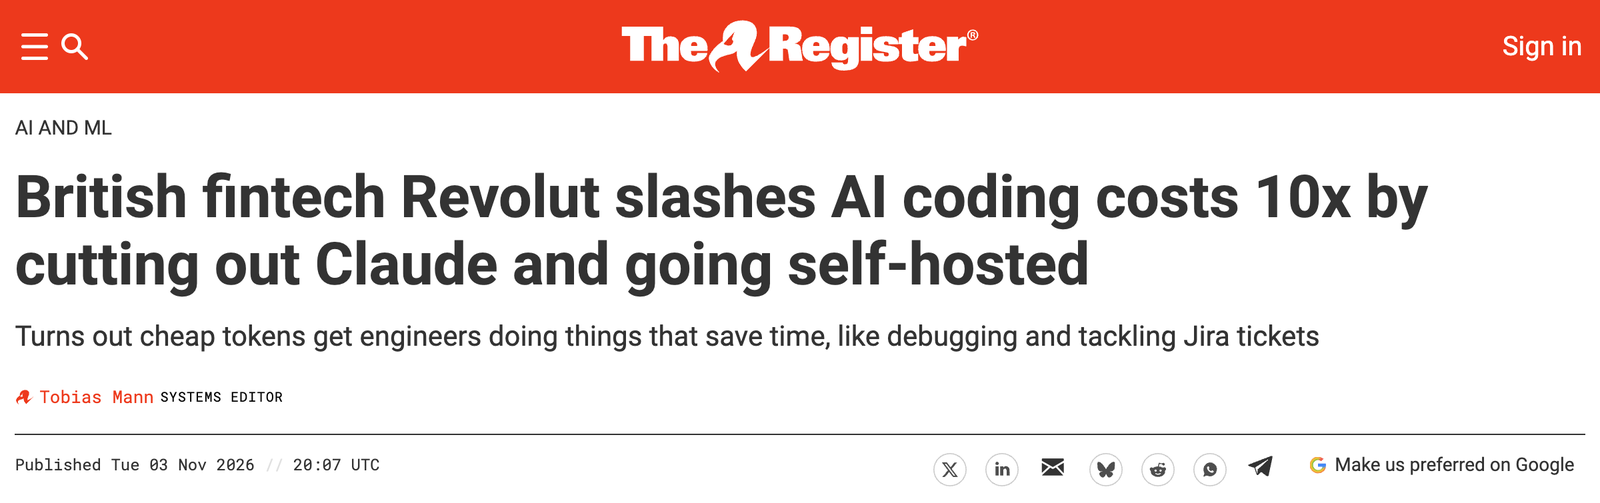
유럽 디지털 은행 레볼루트는 엔지니어 약 2,000명의 AI 코딩 기본 모델을 바꾼 뒤, 앤트로픽·오픈AI에 내던 돈의 10분의 1만 든다고 말합니다. 그 전에는 한 달 1만 달러까지 쓰는 엔지니어들을 보고 예산을 묶었는데 효과가 크지 않았다고 해요. 11월 3일 영국 IT 매체 The Register까지 다루며 퍼진 이야기예요. 토큰(AI가 읽고 쓰는 글의 양을 세는 단위)을 눈치 보지 않고 쓰게 하면, 일은 어디서 줄어들까요?
레볼루트의 AI 운영 책임자 데이비드 아비트볼(David Abitbol)에 따르면, 기본 모델은 오픈 모델(학습한 값을 공개해 받아 쓰는 모델) GLM이고, 앤트로픽·오픈AI의 최신 모델은 예외로 계속 써요. GLM은 AI 연산용 칩 GPU를 빌려주는 Together AI의 전용 GPU 56장에 올려 써요. 아낄 필요가 없어지자 코딩 밖의 일까지 AI에 맡기며 기능 하나를 끝내는 시간이 줄었다는 게 아비트볼의 해석입니다. 개발자 콘퍼런스 AI Engineer 유튜브에 10월 29일 공개된 뉴욕 무대 강연을 순서대로 따라가며, 독자가 물을 만한 질문으로 나눠 살펴봅니다.
AI 코딩 예산에 한도를 걸었을 때는 효과가 크지 않았다
Q. 레볼루트가 처음 들인 AI는 효과가 있었나요?
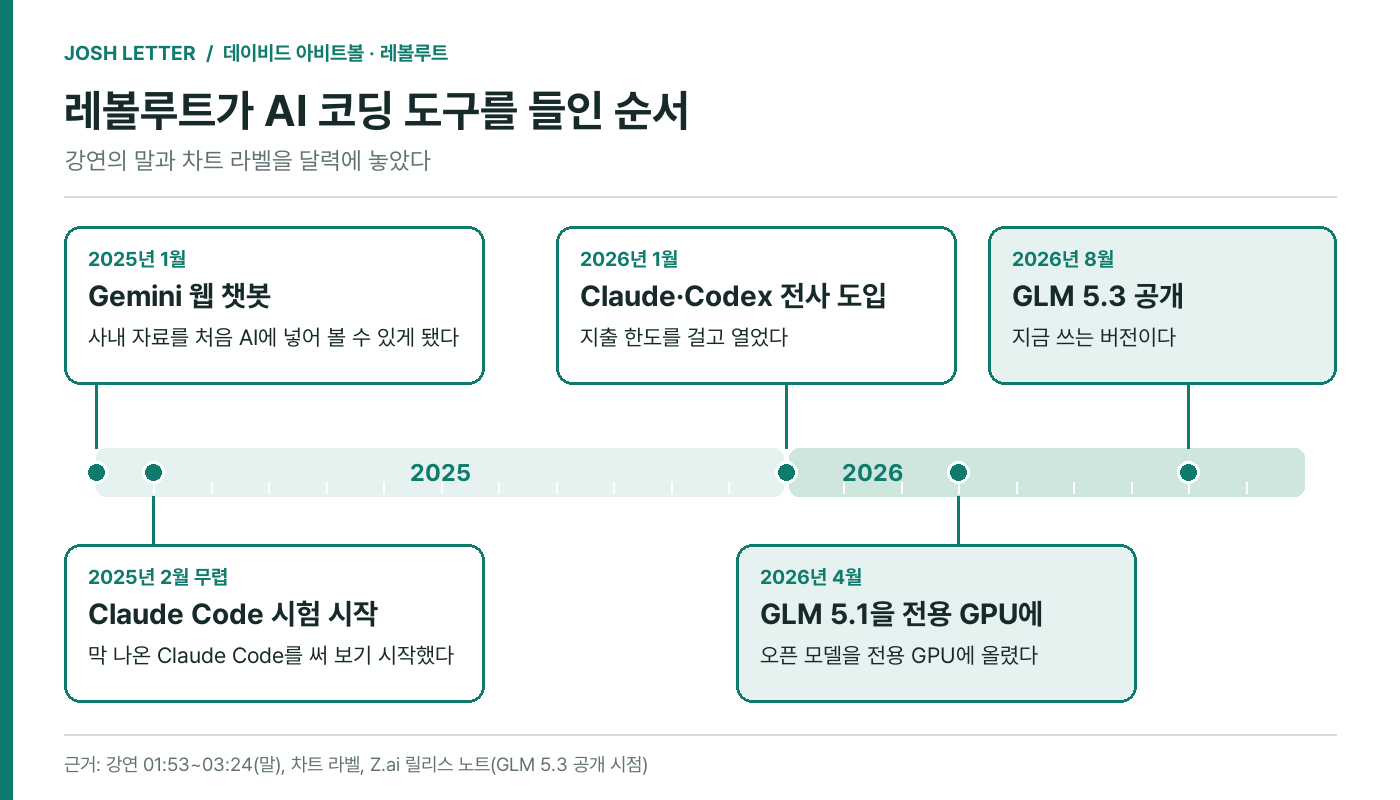
있었다고 해요. 2025년 1월의 Gemini(구글의 AI 모델) 웹 챗봇으로 사내 자료를 AI에 넣어 볼 수 있게 됐고, 문서를 뒤질 일이 줄었다는 거예요.
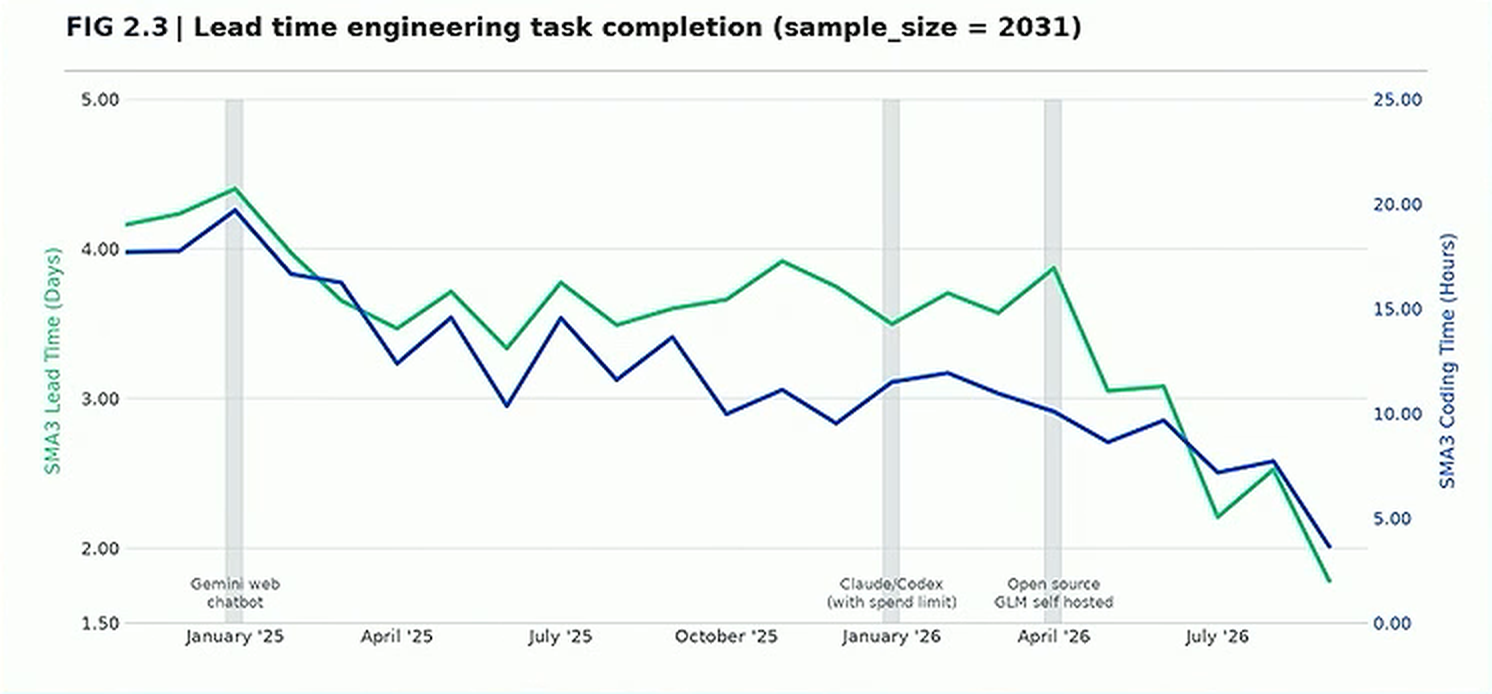
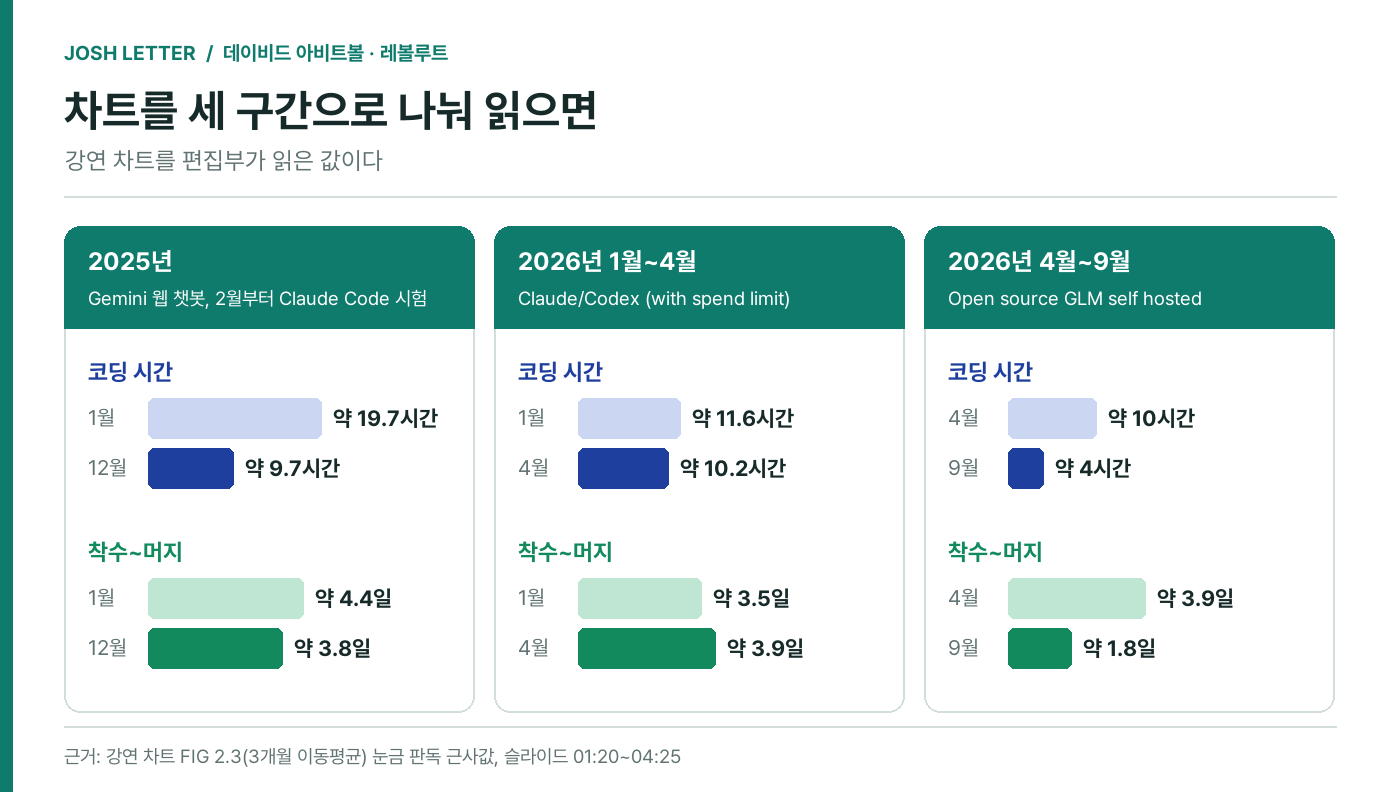
아비트볼이 무대에 올린 차트에는 엔지니어 약 2,000명을 표본으로 잰 선이 두 개 있어요. 초록 선은 착수부터 머지(merge, 쓴 코드를 본 코드에 합치는 일)까지 걸린 일수, 파란 선은 코딩 시간이에요. 착수는 기능 개발을 맡은 때, 끝은 코드가 합쳐져 배포할 준비가 된 때고요. 아비트볼의 말로는 Gemini로 착수~머지가 10%, 코딩 시간이 20% 좋아졌어요.
Q. 코딩 에이전트를 들일 때는 왜 예산을 묶었나요?
비용을 믿지 못해서예요. 앤트로픽의 코딩 에이전트 Claude Code를 2025년 2월 무렵부터 시험했는데, 전사로 열 때 레볼루트는 AI 비용에 매우 회의적이었다고 해요.
"엔지니어들이 한 달에 1,000달러, 1만 달러를 쓰는데 쓴 만큼의 효과는 별로 보이지 않았어요."
그래서 2026년 1월 전사로 열면서 엄격한 예산 한도를 걸었어요. 차트에는 오픈AI의 코딩 에이전트 Codex까지 함께 적혀 있어요. 아비트볼의 평가는 그때는 큰 효과가 없었다는 거고요.
아껴 쓰게 한 그 석 달은 차트로도 밋밋해요. 편집부가 차트를 읽으면 2026년 1월부터 4월까지 코딩 시간은 12%쯤 줄었는데, 착수~머지는 약 3.5일에서 약 3.9일로 오히려 늘었어요.
아비트볼이 본 시간 단축은 코딩 밖에도 있었다
Q. 그럼 토큰 걱정은 어떻게 덜었나요?
다음 목표를 아비트볼은 이렇게 말해요. "엔지니어에게 토큰을 제한 없이 주고, 비용은 일부만 들여서, 죄책감 없이 AI를 쓰게 할 방법이 뭘까요?"
찾아낸 답이 오픈 모델이에요. 2026년 4월 중국 개발사 Z.ai의 GLM-5.1을 전용 GPU에 올렸고, 지금은 8월에 나온 GLM-5.3을 써요.
그 뒤로 두 선이 내려가요. 차트로 읽으면 9월까지 착수~머지는 약 3.9일에서 약 1.8일로, 코딩 시간은 약 10시간에서 약 4시간으로 두 선 모두 절반 넘게 줄었어요. 아비트볼은 무대에서 코딩 시간 60%, 착수~머지 70% 개선이라고 말했고, 슬라이드 글머리에는 착수~머지 60%가 있어요.
Q. 코딩 말고 어디서 시간이 줄었나요?
아비트볼의 해석은 짧아요. "엔지니어링의 병목이 꼭 코딩은 아니에요." 메일함을 뒤지고 Jira(업무 관리 도구)와 Confluence(사내 문서 도구)를 만지는 시간을 크게 아낄 수 있다는 말이에요.
"토큰에 제한이 없으면 분기 말이나 가장 어려운 일을 위해 아껴 둘 필요가 없어요."
토큰이 귀하면 어려운 코딩에 아껴 두고 주변 일에는 안 쓰게 되니까요.
차트도 이 해석에 가까워요. 코딩이 빨라져도 전체는 그만큼 줄지 않았거든요. 2025년 한 해 코딩 시간은 약 19.7시간에서 약 9.7시간으로 절반이 됐는데, 착수~머지는 약 4.4일에서 약 3.8일로 14%쯤 줄었어요.
제한을 푼 뒤 먼저 크게 내려간 것도 착수~머지 선이고, 9월까지 줄어든 양도 코딩은 여섯 시간쯤, 착수~머지는 이틀쯤이에요. 같은 기간 모델도 5.1에서 5.3으로 바뀌었고요.
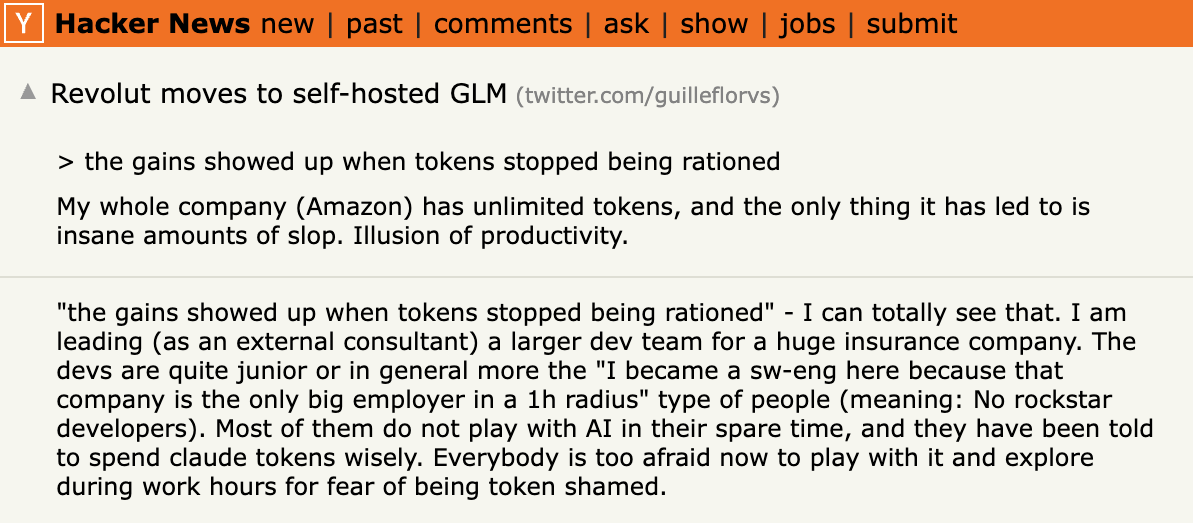
반응은 갈려요. 개발자 커뮤니티 Hacker News 토론에는 '회사가 토큰을 제한 없이 줬더니 쓰레기만 늘었다'는 댓글과 '아껴 쓰라는 말에 다들 겁이 나서 못 쓴다'는 댓글이 나란히 달렸어요.
오픈 모델이 기본, 최신 모델은 예외, 첫 응답은 3초 안에
Q. 그럼 최신 모델은 이제 안 쓰나요?
그렇지 않아요. 아비트볼의 표현은 이거예요.
"최신 모델은 예외예요."
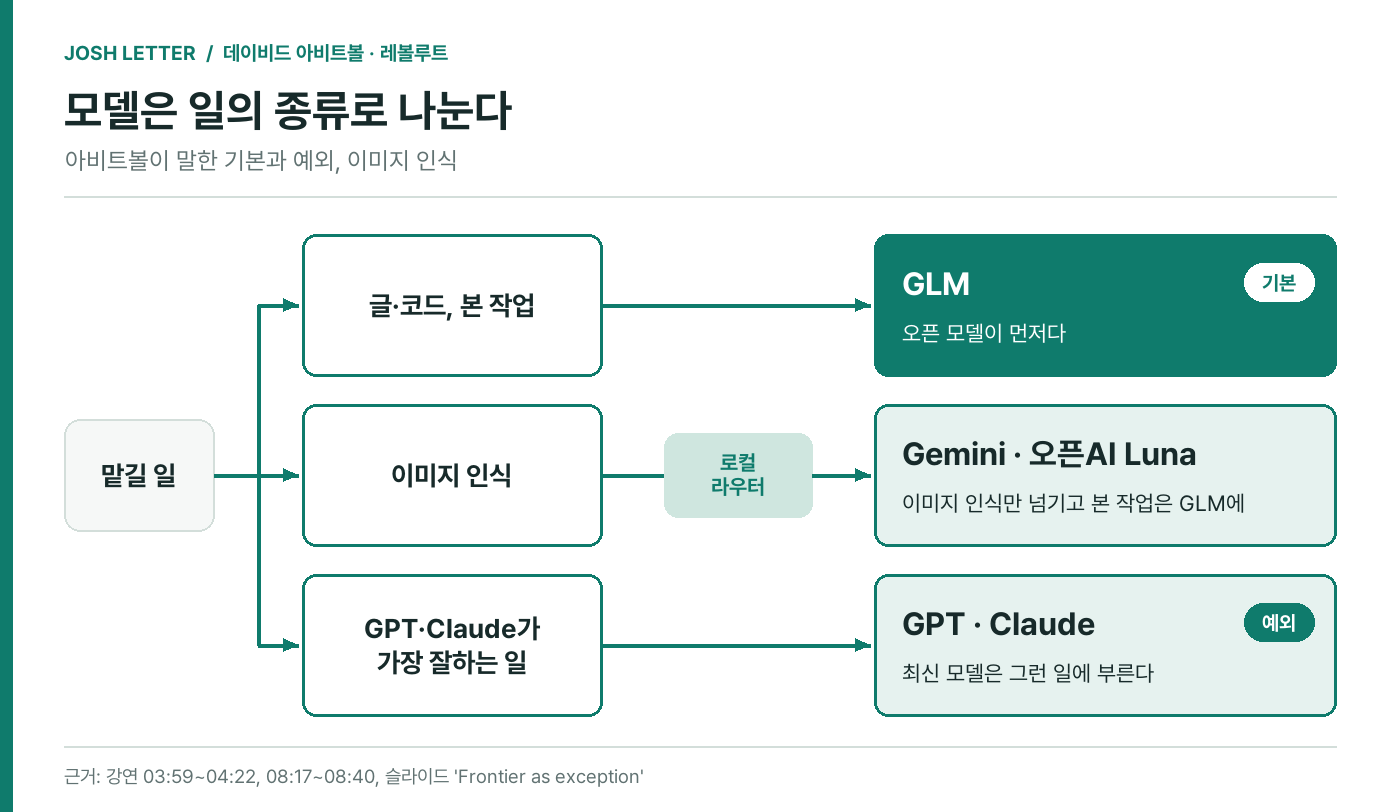
Codex와 Claude Code를 계속 쓰고, 최신 모델은 훌륭하다는 말도 덧붙여요. 어떤 일은 GPT와 Claude가 가장 잘한다는 게 슬라이드 문구예요. 바뀐 건 기본값이에요. 오픈 모델이 먼저이고 최신 모델은 그런 일에 부르게 된 거죠.
기본을 바꾸니 청구도 일정해져 월말 청구서에 놀랄 일이 없다고 해요. Together AI 공식 문서에 따르면 전용 GPU 서비스는 요청량과 상관없이 장비가 돌아간 시간으로 요금을 매겨요. 장비를 늘리지 않으면 쓰는 양이 늘어도 청구는 그대로인 구조죠.
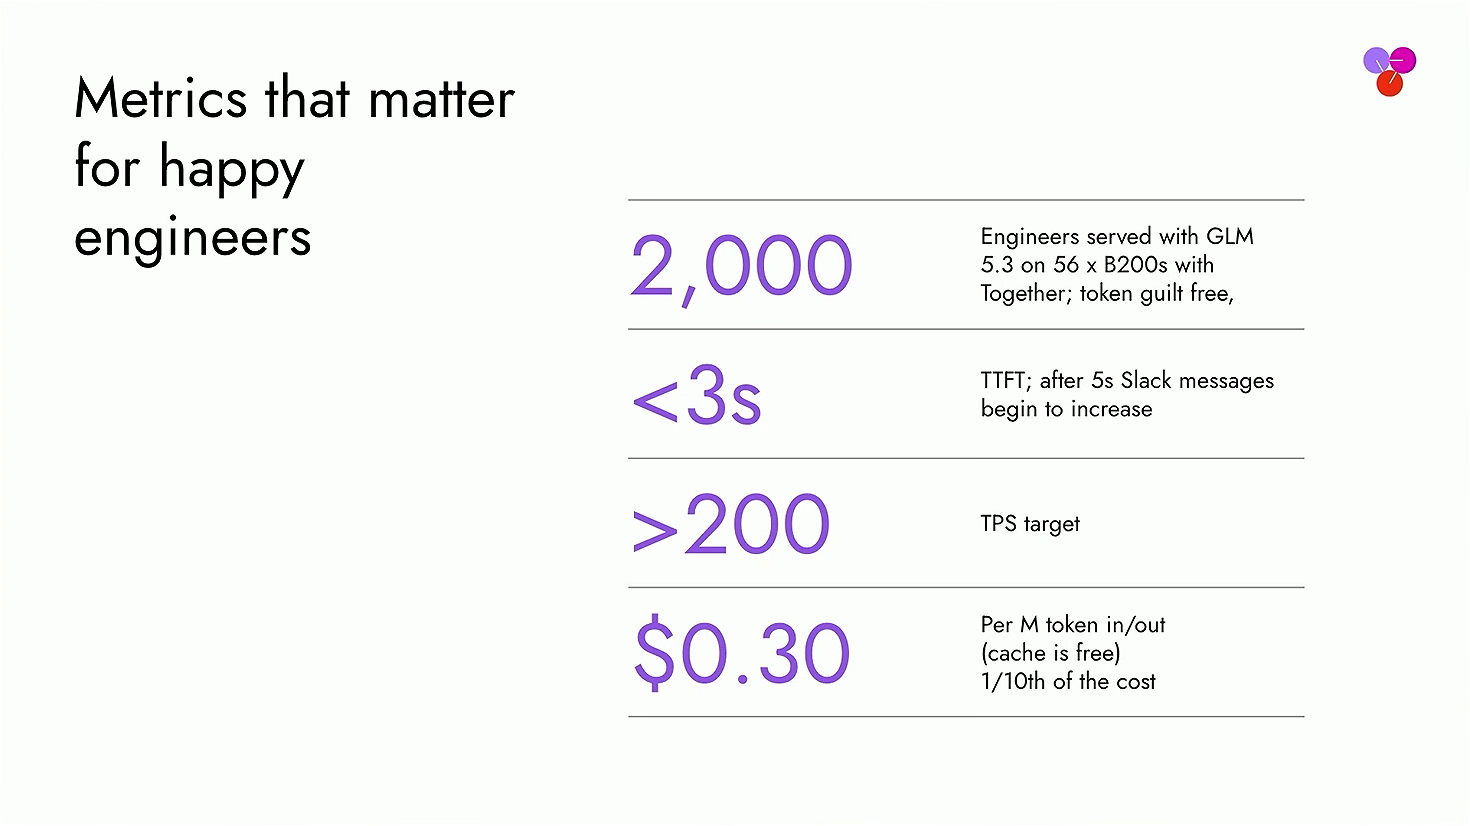
엔지니어 2,000명이 쓰는 데 B200(엔비디아의 AI 연산 칩) 56장쯤 드는데, 슬라이드에는 여기에 'with Together'가 붙어 있어요.
아비트볼이 '자체 운영(self-hosting)'이라 부르는 방식은 공개된 가중치(모델이 학습한 값을 담은 파일)를 받아 이 GPU에 올려 쓰는 쪽이에요. Together AI는 이 강연이 열린 행사의 후원사이기도 하고요.
11월 4일 호의 모건 드바운이 일을 나눠 비싼 모델로 가는 양을 줄였다면, 레볼루트는 기본 모델 자체를 바꿔 토큰을 묶지 않았어요.
Q. 응답은 얼마나 빨라야 항의가 안 나오나요?
아비트볼이 꼽는 선은 3초예요. 요청 뒤 첫 글자가 나올 때까지 걸리는 첫 토큰 시간이 기준이에요.
"목표는 첫 토큰까지 3초 미만이에요. 경험으로 아는 값이죠. 5초를 넘기는 순간 제 슬랙이 터지기 시작하거든요."
글자가 나오는 속도는 그만큼 중요하지 않아요. 아비트볼의 기준으로는 초당 200토큰이면 괜찮아요. 일하는 방식이 바뀌어서죠.
"이제 모델이 생각하는 글자가 흘러가는 걸 지켜보지 않아요. 일을 병렬로 돌려 놓고 끝나면 확인하죠."
그래도 속도를 원하는 레볼루트 엔지니어는 GPU가 한가해지는 오후 5시 뒤에 접속하면 된다고 해요. 그때는 초당 800토큰이 나온다고요.
편집부가 읽기로는 상한이 사라진 게 아니라 돈에서 GPU 용량과 대기 시간으로 옮겨 간 거예요. 장비가 56장으로 정해져 있으니까요.
맡겨 두고 끝나면 확인하는 방식은 혼자 일해도 쓸 수 있죠.
레볼루트의 '10분의 1'을 내 청구서에 대 보면
Q. '10분의 1'은 무엇의 10분의 1인가요?
아비트볼은 입력과 출력을 섞어 잡은 값이 100만 토큰당 30센트라고 한 뒤 이렇게 말해요.
"그래서 청구서는 앤트로픽과 오픈AI에 쓰던 돈의 10분의 1이에요."
슬라이드에서는 같은 '10분의 1'이 토큰 단가 줄에 붙어 있어요. 말로는 청구 총액, 화면으로는 단가처럼 읽히죠.
토큰을 풀고도 이 숫자가 나왔다면, 어느 쪽이든 토큰값이 크게 내려갔다는 뜻이에요. 내 청구서에 대 볼 때는 쓰는 양까지 봐야 하고요. 토큰값이 10분의 1이 돼도 더 많이 쓰면 청구서는 그만큼 줄지 않으니까요.
GPU 값의 규모는 어림할 수 있어요. 편집부가 11월 4일 Together AI 공개 표 가격으로 계산하면 56장을 한 달 내내 돌리는 값은 28만~37만 달러쯤, 엔지니어 한 명당 한 달 140~180달러쯤이에요.
켜 둔 장비는 노는 시간에도 요금이 나가고, 유튜브 댓글에는 튜닝하고 운영하는 사람 몫까지 넣어 비교해야 한다는 말도 달렸어요.
Q. 혼자 쓰는 사람도 GLM으로 바꾸면 AI 비용이 10분의 1이 되나요?
그렇게 옮겨지지 않아요. 행사 측 요약은 이 숫자를 "레볼루트의 배치와 활용률을 설명하는 값이지, 자체 운영 모델이면 어디에나 옮겨 쓸 수 있는 가격이 아니다"라고 적었어요.
11월 4일 공식 표로 보면 Z.ai의 GLM-5.3 API(프로그램에서 모델을 불러 쓰는 창구)는 입력도 출력도 Claude Sonnet 5.5보다 싸요. 그런데 캐시(앞서 읽은 내용을 다시 읽는 것)는 100만 토큰당 0.26달러로 Sonnet의 0.10달러보다 비싸요.
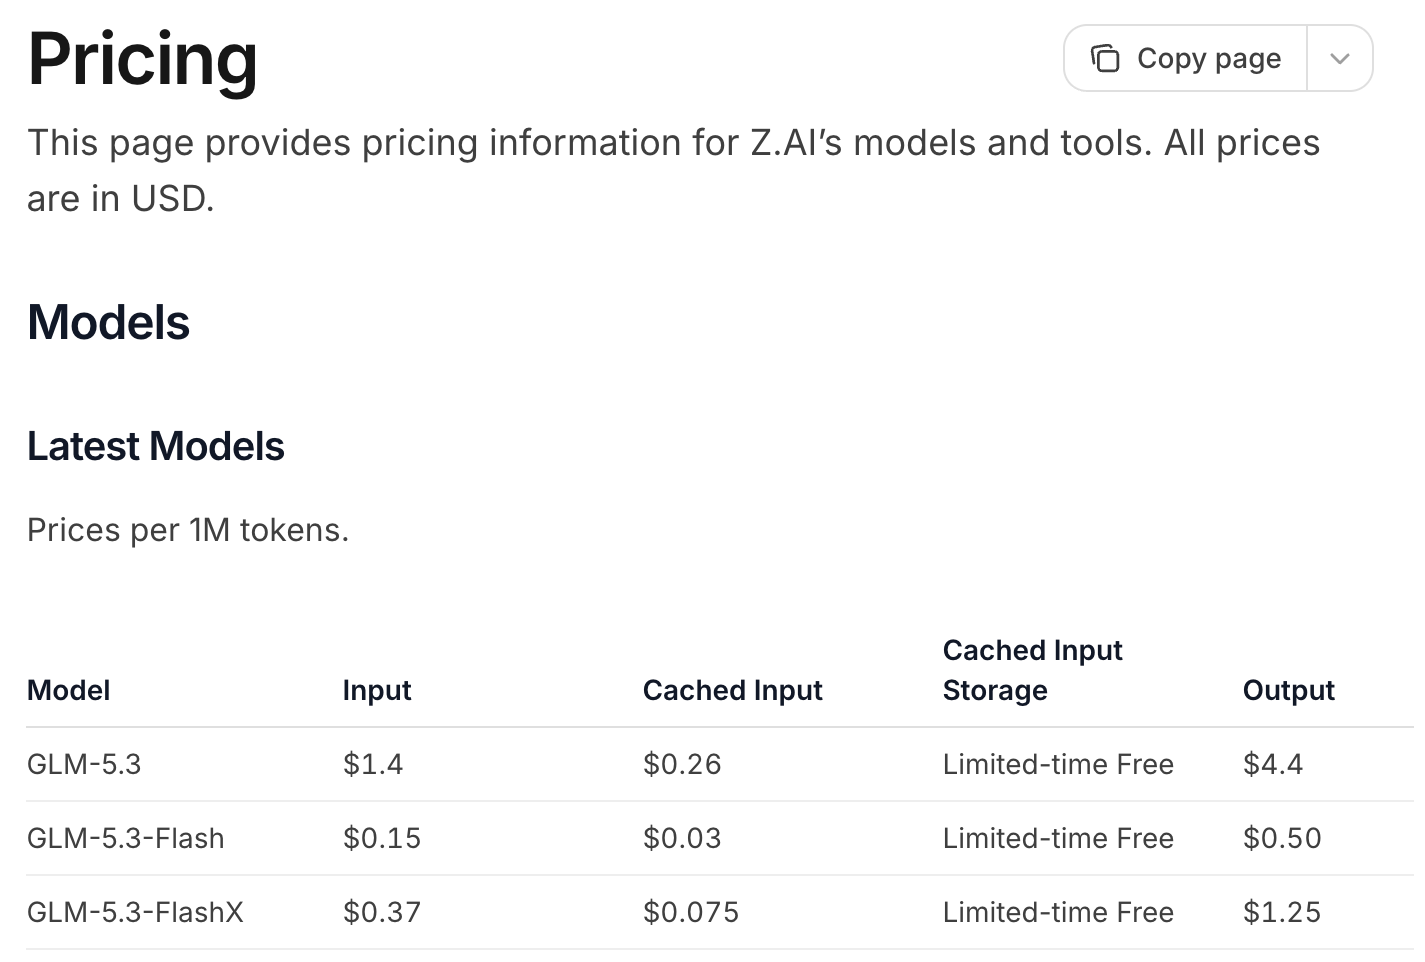
그래서 내 경우는 쓰는 방식에 달렸어요. 짧게 묻고 답을 받는 일이 많으면 이 표로는 GLM-5.3이 싸요. Claude Code 같은 에이전트에 긴 작업을 맡기면 같은 코드를 되풀이해 읽어 캐시 비중이 올라가요. 한 분석 글이 인용한 측정으로는 그 비중이 95%쯤이에요. 이 표대로 계산하면 캐시 비중이 80~90%를 넘는 순간 GLM-5.3이 오히려 Sonnet 5.5보다 비싸져요.
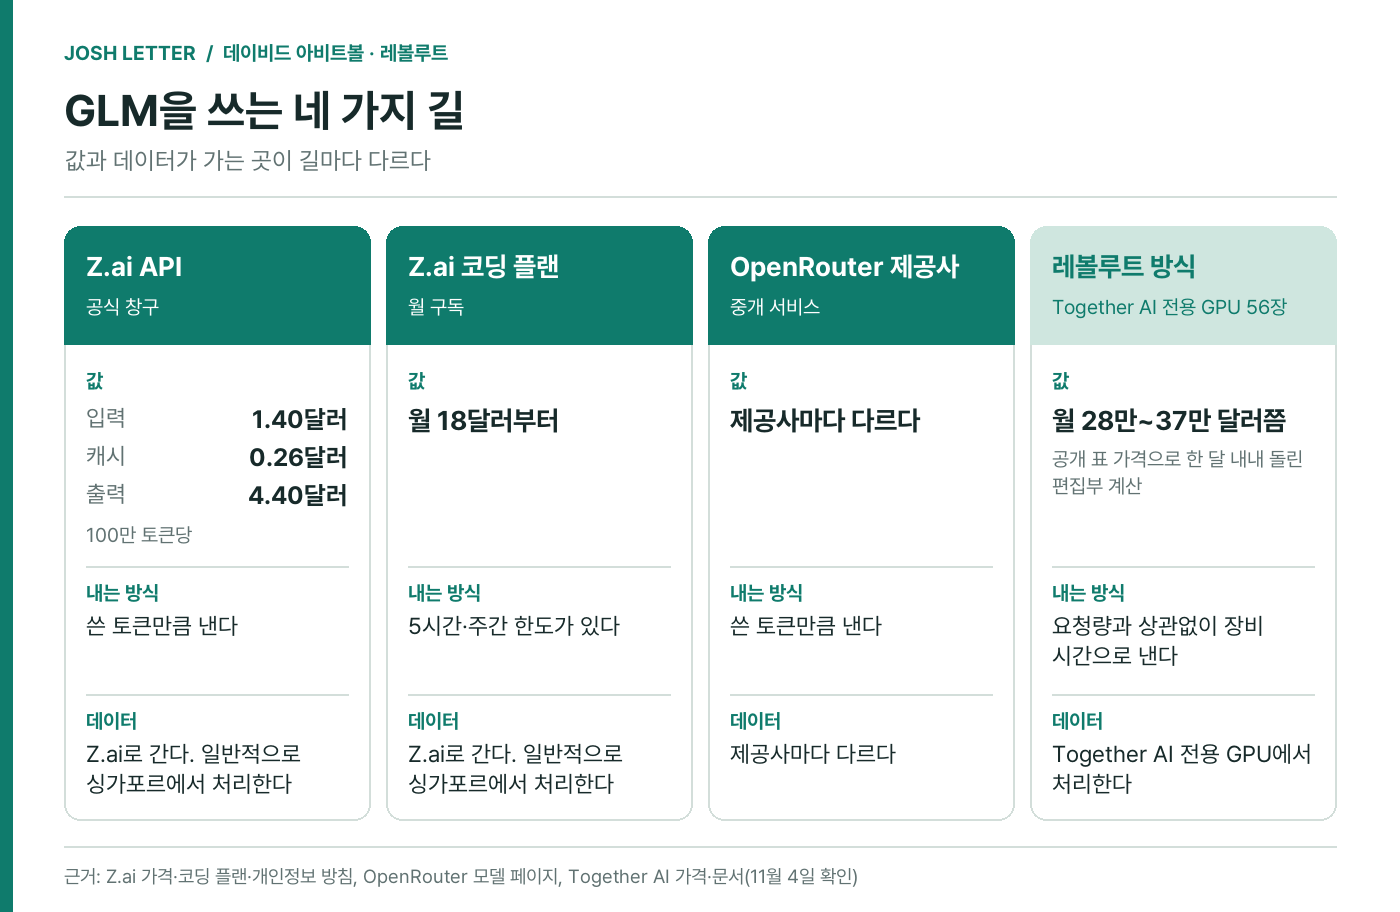
값을 낮출 길도 있어요. 중개 서비스 OpenRouter에는 더 낮은 값을 올린 제공사도 있고, Z.ai 코딩 플랜은 월 18달러부터이며 Claude Code에도 연결돼요.
다만 길마다 한도와 데이터가 가는 곳이 달라요.
숫자는 옮겨지지 않아도 나누는 방식은 옮겨져요. 쓰던 회사의 모델 안에서도 기본과 예외를 나눌 수 있으니까요. Claude라면 더 싼 Sonnet을 기본으로, 더 비싼 Opus를 예외로 두는 식이죠.
오픈 모델을 GPU에 올린 다음에는 장비보다 설정부터
Q. 오픈 모델은 받아서 돌리기만 하면 끝인가요?
아니에요. 아비트볼은 잘라 말해요. "GPU를 구해 가중치를 올리고 그냥 돌리기 시작하면 성능이 형편없을 거예요."
장비를 늘리기 전에 설정부터 손보라는 거예요. 슬라이드 제목이 'Resist scaling, tune first'이고, 이득의 80%는 GPU를 더해서가 아니라 설정을 바꿔서 나왔다고 적었어요. GPU를 몇 장씩 묶어 돌릴지, 모델을 얼마나 압축해 올릴지 같은 설정이에요.
슬라이드의 8월 값을 보면 첫 토큰까지 7초 걸리던 것이 설정을 옮기는 동안 14초까지 늘었고, 안정된 뒤에는 1.7초가 됐어요. 그사이 초당 요청은 4.2건에서 6건으로 늘었어요. GPU는 같은 56장이었어요.
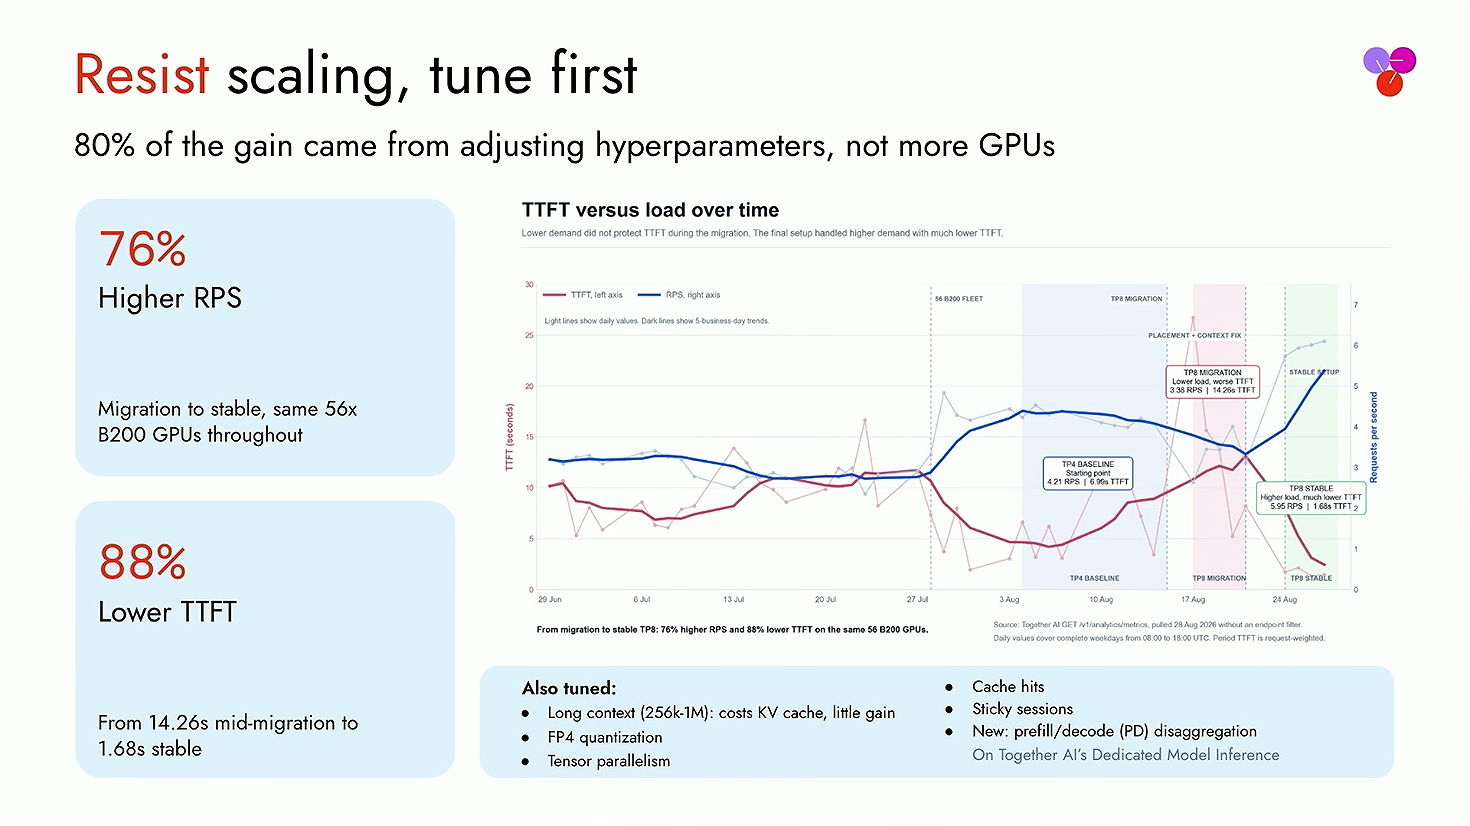
"긴 컨텍스트는 사기예요."
아비트볼이 컨텍스트(모델이 한 번에 읽는 글의 양)를 두고 한 말이에요. 100만 토큰을 제공할 수 있어도 25만 6천이면 된다고 해요. 서버 메모리만 쓰고 이득은 작다는 이유도 붙였고요. 제공하는 쪽 이야기지만, 길게 줄 수 있다고 다 넣을 일은 아니라는 뜻으로도 읽혀요. Claude Haiku 5.5는 프롬프트가 10만 토큰을 넘으면 단가가 다섯 배가 되고요.
Q. GLM은 글자만 읽는데 이미지 작업은 어떻게 하나요?
본 작업에 쓰는 GLM-5.3은 글자 입력만 받아요. 아비트볼의 선택은 매번 같아요. "더 똑똑한 모델을 고르고, 이미지 인식은 다른 방법을 찾는 거죠."
방법은 로컬 라우터(요청을 모델별로 나눠 보내는 프로그램)예요. 이미지 인식만 Gemini나 오픈AI의 Luna로 보내고 본 작업은 GLM에 둘 수 있다고 해요. 넘기는 기준은 값이 아니라 그 모델이 못 하는 일이에요. 혼자 쓸 때도 쓰던 모델이 못 읽는 이미지만 다른 모델에 넘기면 돼요.
이미지까지 읽는 모델이 꼭 필요하면 GLM의 Flash 계열이 잘 된다는 말도 해요. 시안을 넣으면 작동하는 화면이 나오는 식으로 쓰고, 사내 UI 디자이너가 잘 활용하면서 화면 작업이 훨씬 빨라졌다고 덧붙여요.
쓰던 도구도 그대로예요. 모델 창구가 OpenAI 호환 API(OpenAI 방식 그대로 부르는 창구)라 OpenCode(오픈소스 코딩 에이전트)와 Codex 안에서 부를 수 있대요.
규제받는 은행이 AI 코딩에 붙인 확인 장치
Q. 중국 모델을 규제받는 은행이 써도 되나요?
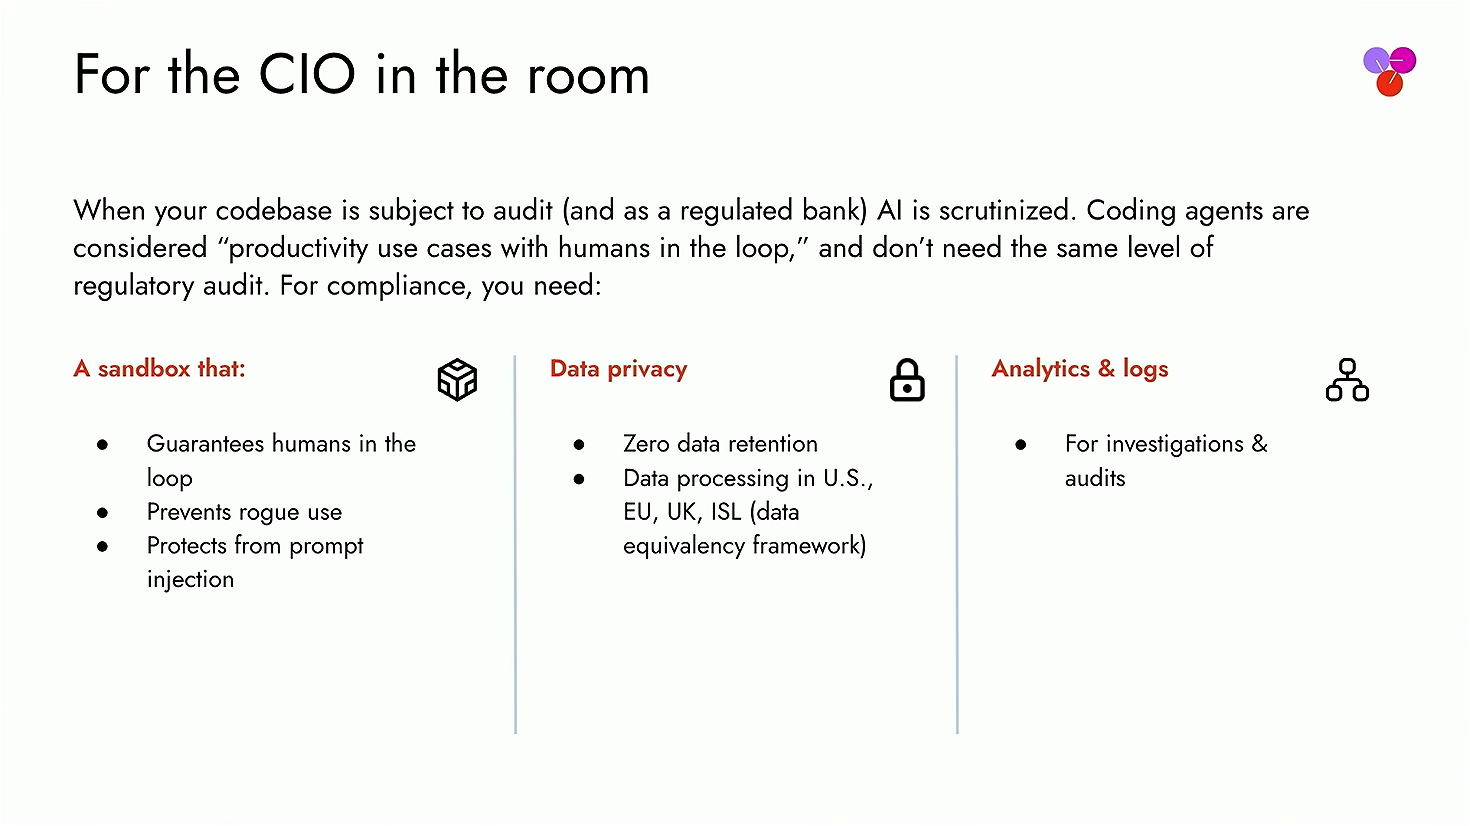
아비트볼이 강연 끝에 CIO(최고정보책임자)를 향해 꺼낸 이야기예요. 중국 오픈 모델에 낙인이 많았다고 짚은 뒤 데이터가 어디로 가는지를 가려요. 중국으로 가는 추론(모델이 답을 만드는 일) 창구가 아니라, 가중치만 받아 미국 기반 서비스에 올린다는 거죠. 그래서 데이터 공유 면에서는 문제없다는 게 아비트볼의 판단이에요.
같은 GLM이어도 경로가 다르면 이 말이 그대로 통하지 않아요. Z.ai API를 쓰면 데이터는 Z.ai로 가고, Z.ai 방침에는 일반적으로 싱가포르에서 처리한다고 적혀 있어요.
Q. 에이전트 작업을 사람이 확인한다는 걸 규제 당국에 어떻게 보여 주나요?
아비트볼의 슬라이드는 코딩 에이전트를 '사람이 개입하는 생산성 용도'로 설명해요. 자율 에이전트와 같은 수준의 규제 감사는 필요 없다고요. 그러려면 사람이 개입한다는 걸 보여 줄 장치가 있어야 하고요.
시작은 샌드박스(에이전트의 행동 범위를 막아 둔 실행 환경)예요. Codex와 Claude Code에 이미 승인 기능이 있으니 허용하지 않을 작업의 규칙만 정하면 된다는 설명이에요.
"예를 들면 grep은 허용하고 gradle은 막을 수 있어요."
grep은 파일 안의 글자를 찾는 명령, gradle은 코드를 빌드하는 도구예요. 아비트볼은 이런 규칙이 규제 쪽에 자율 에이전트가 아니라는 확신을 준다고 봐요. 같은 샌드박스가 내부자의 오남용도 막고, 마지막은 사고가 났을 때 들여다볼 로그예요.
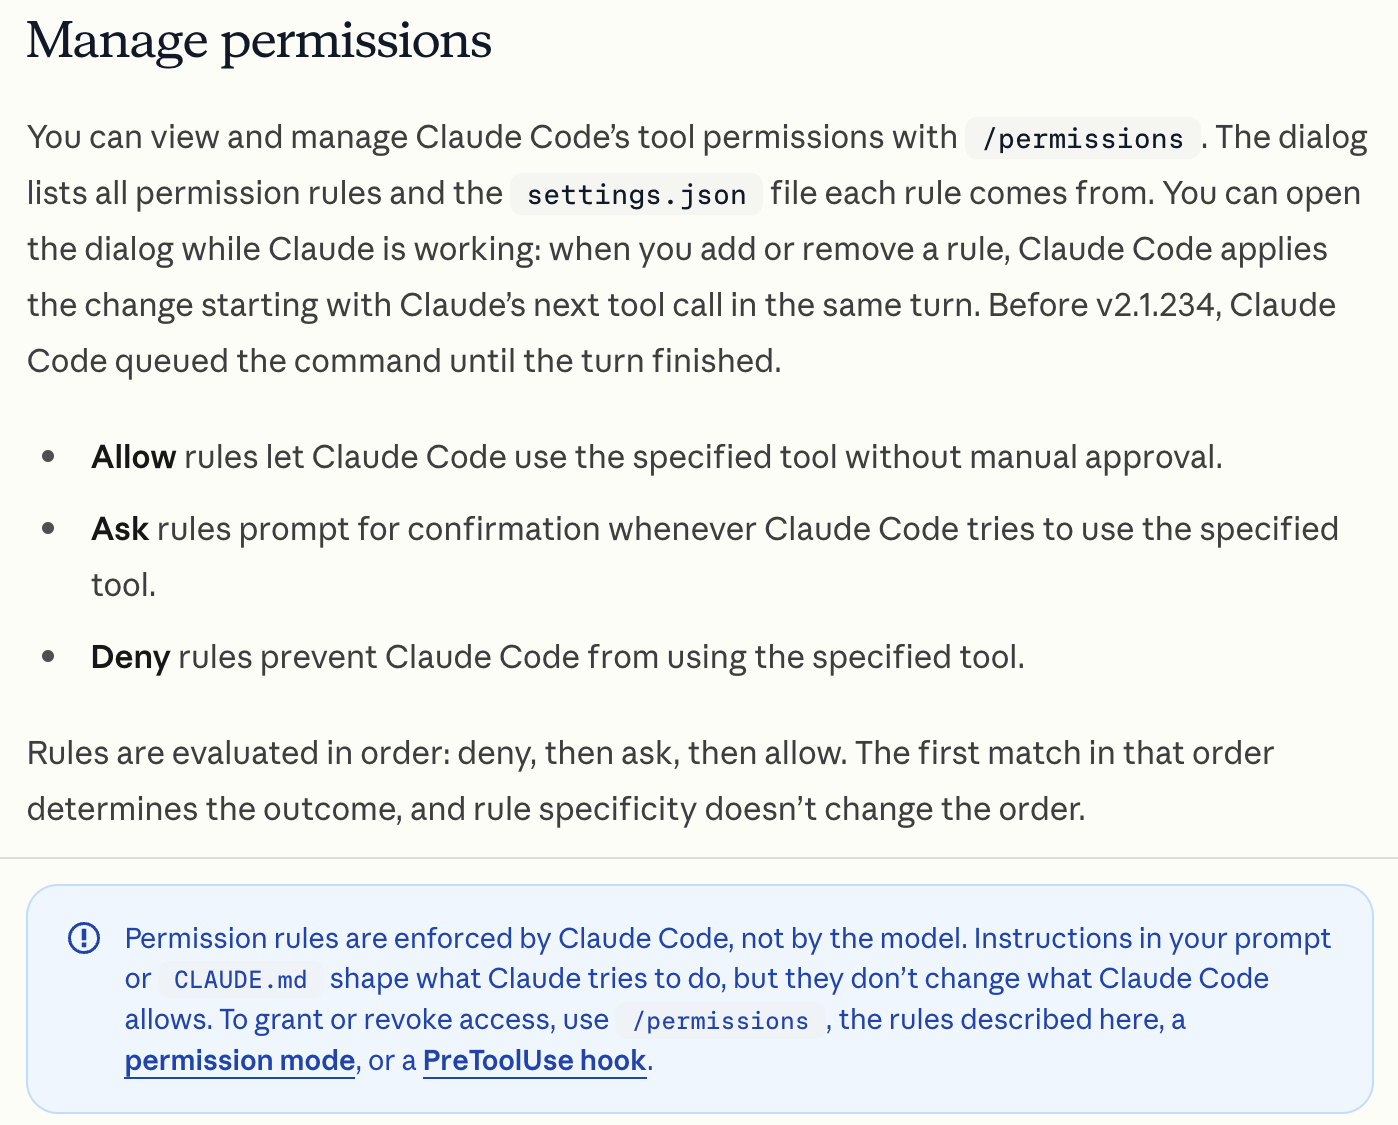
혼자 쓰는 사람도 같은 장치를 쓸 수 있어요. Claude Code 공식 문서를 보면 규칙은 막기·묻기·허용(deny·ask·allow) 순으로 적용되고, 모델이 아니라 Claude Code가 강제해요. 프롬프트로 조심시키는 것과 다른 층이죠. /permissions에서 규칙을 보고 고칠 수 있고 Codex도 샌드박스와 승인 정책으로 정하니, 막을 명령을 여기에 적어 두면 돼요.
엔지니어 2,000명이 쓰는 GPU 56장과 앤트로픽·오픈AI에 내던 돈의 10분의 1은 그대로 따라 할 숫자가 아니에요. 볼 건 아비트볼이 보여 준 구조예요. 값을 낮추고, 기본 모델과 예외를 나누고, 규칙과 로그로 선을 그었다는 거죠.
아비트볼의 해석대로라면 먼저 들여다볼 곳은 모델 가격표보다 아까워서 AI에 안 넘긴 일의 목록입니다. 구독의 주간 한도도 레볼루트의 예산 한도와 같은 종류의 제약이니까요. 이번 주에 한도가 걱정돼 미룬 일 하나를 적어 두고, 그 일부터 맡겨 보면 어떨까요?
조쉬가 직접 운영하는 AI 솔로프리너 클럽에 초대합니다.

이미 300명이 넘는 분들이 ASC와 함께 성장하고 있습니다.
구글 엔지니어, 토스 PM, 산부인과 전문의, 스타트업 대표까지
— 각자의 자리에서 정상에 선 사람들이 지금 AI로 새로운 도전을 시작했습니다.
그리고 ASC 14기는 단 30명만 함께합니다.
아직 늦지 않았습니다.
지금 시작하는 당신이, 1년 뒤 가장 앞서 있을 솔로프리너입니다.


의견을 남겨주세요