안녕하세요, 구독자님 😊
복잡한 IT를 한입 크기로 잘라 전해 드리는 뉴스레터, 이정환의 한입 IT입니다.
요즘은 뉴스만 틀어도 AI 이야기가 빠지지 않습니다. LLM, AI 에이전트, 할루시네이션, RAG… 어디선가 한 번쯤은 들어 보셨을 텐데, 구독자님은 이 단어들을 어디까지 설명하실 수 있으신가요?
사실 이 용어들은 따로 떨어진 단어가 아니라, 하나의 흐름으로 이어져 있습니다. 그래서 그 흐름만 한 번 머릿속에 잡아 두면, 뉴스를 볼 때도, 누군가와 AI를 주제로 이야기할 때도 용어 때문에 곤란할 일은 없습니다. 오늘은 그 흐름을 처음부터 끝까지 따라가 보겠습니다.
알파고는 왜 금방 잊혔을까요
AI가 우리를 처음 크게 놀라게 한 순간은 알파고였습니다. 당시 인간계 최강으로 불리던 이세돌 9단을 바둑으로 이기면서 많은 사람에게 큰 충격을 안겼죠.
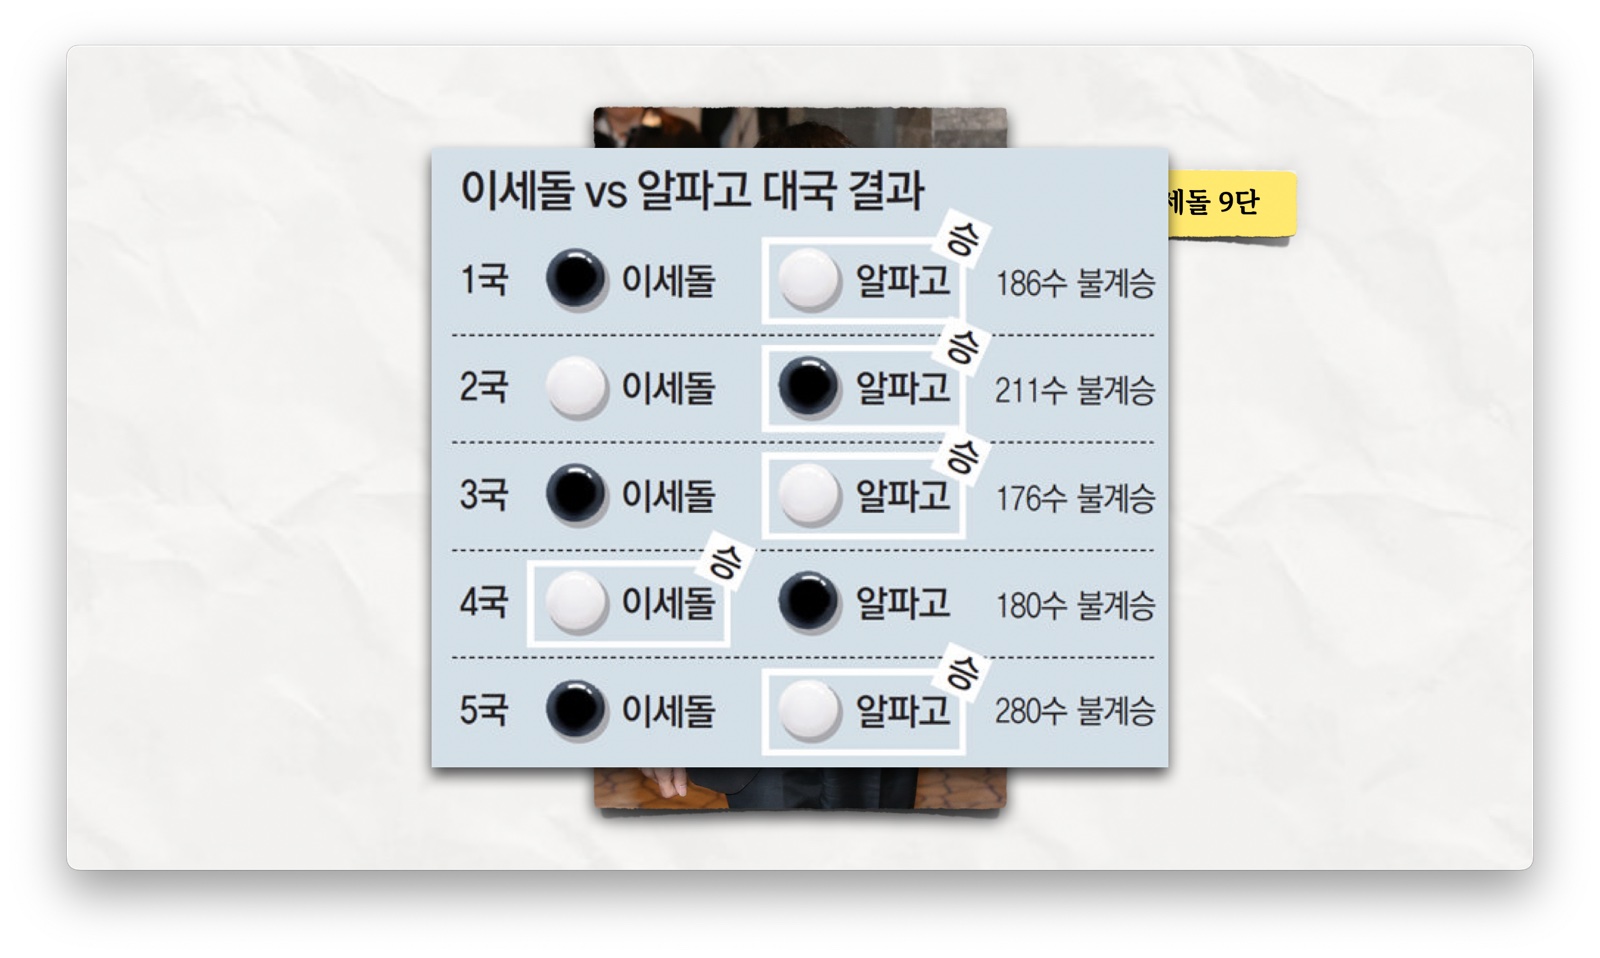
그런데 알파고의 임팩트는 생각보다 오래가지 않았습니다. 알파고는 어디까지나 바둑을 학습한 AI였기 때문에, 정말 바둑만 잘 뒀거든요. 일상에서 쓸 데가 없다 보니 사람들의 관심은 점점 사그라들었고, AI는 그렇게 우리 일상에서 조금씩 잊혀 갔습니다.
두 달 만에 1억 명, ChatGPT와 LLM
그러던 어느 날, 알파고보다 훨씬 큰 충격으로 전 세계를 뒤흔든 서비스가 나옵니다. 바로 ChatGPT입니다. 바둑만 두던 알파고와 달리, 사람과 실제로 대화를 나눌 수 있었죠.
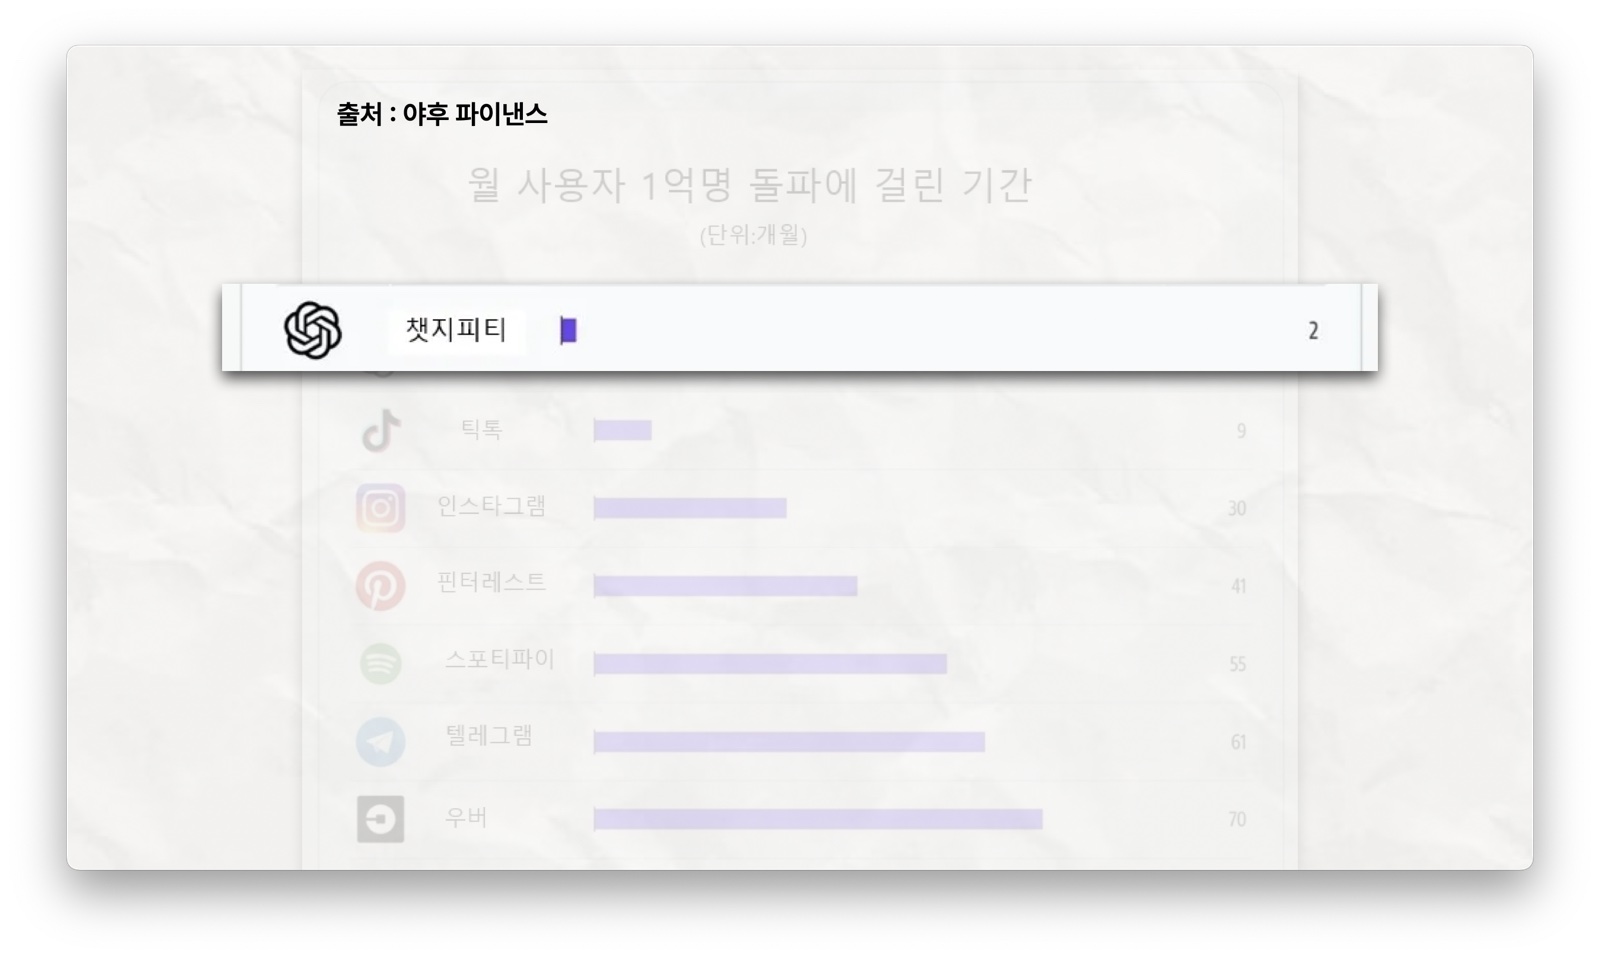
반응은 폭발적이었습니다. ChatGPT는 출시 단 두 달 만에 사용자 1억 명을 넘겼습니다. 틱톡이 1억 명을 모으는 데 9개월, 인스타그램은 30개월이 걸렸다는 걸 생각하면 그 인기가 얼마나 대단했는지 짐작이 되실 겁니다.
정확히 말하면 ChatGPT는 GPT라는 AI 모델과 사람이 대화할 수 있게 해 주는 채팅 프로그램입니다. GPT가 사람과 자연스럽게 대화할 수 있었던 비결은, 바둑 기보만 학습한 알파고와 달리 사람의 언어 그 자체를 학습했다는 데 있습니다. 사람들이 그동안 써 온 책과 뉴스, 블로그 같은 온라인 글을 대규모로 학습했기 때문에, 사람의 말을 알아듣고 사람처럼 말할 수 있게 된 거죠.
이렇게 방대한 언어 데이터를 학습해서 사람의 말을 이해하고 대화할 수 있게 된 AI 모델을 대규모 언어 모델, 영어로 Large Language Model, 줄여서 LLM이라고 부릅니다. 뉴스에 나오던 LLM이 바로 이런 뜻이었던 겁니다.
모델 전쟁이 반도체 이야기로 번진 이유
GPT의 인기가 하늘을 찌르자, IT 기업들도 저마다 자신만의 LLM을 만들기 시작했습니다. 구글은 제미나이, 메타는 라마, 일론 머스크의 xAI는 그록, 그리고 앤트로픽은 클로드를 내놓았죠.
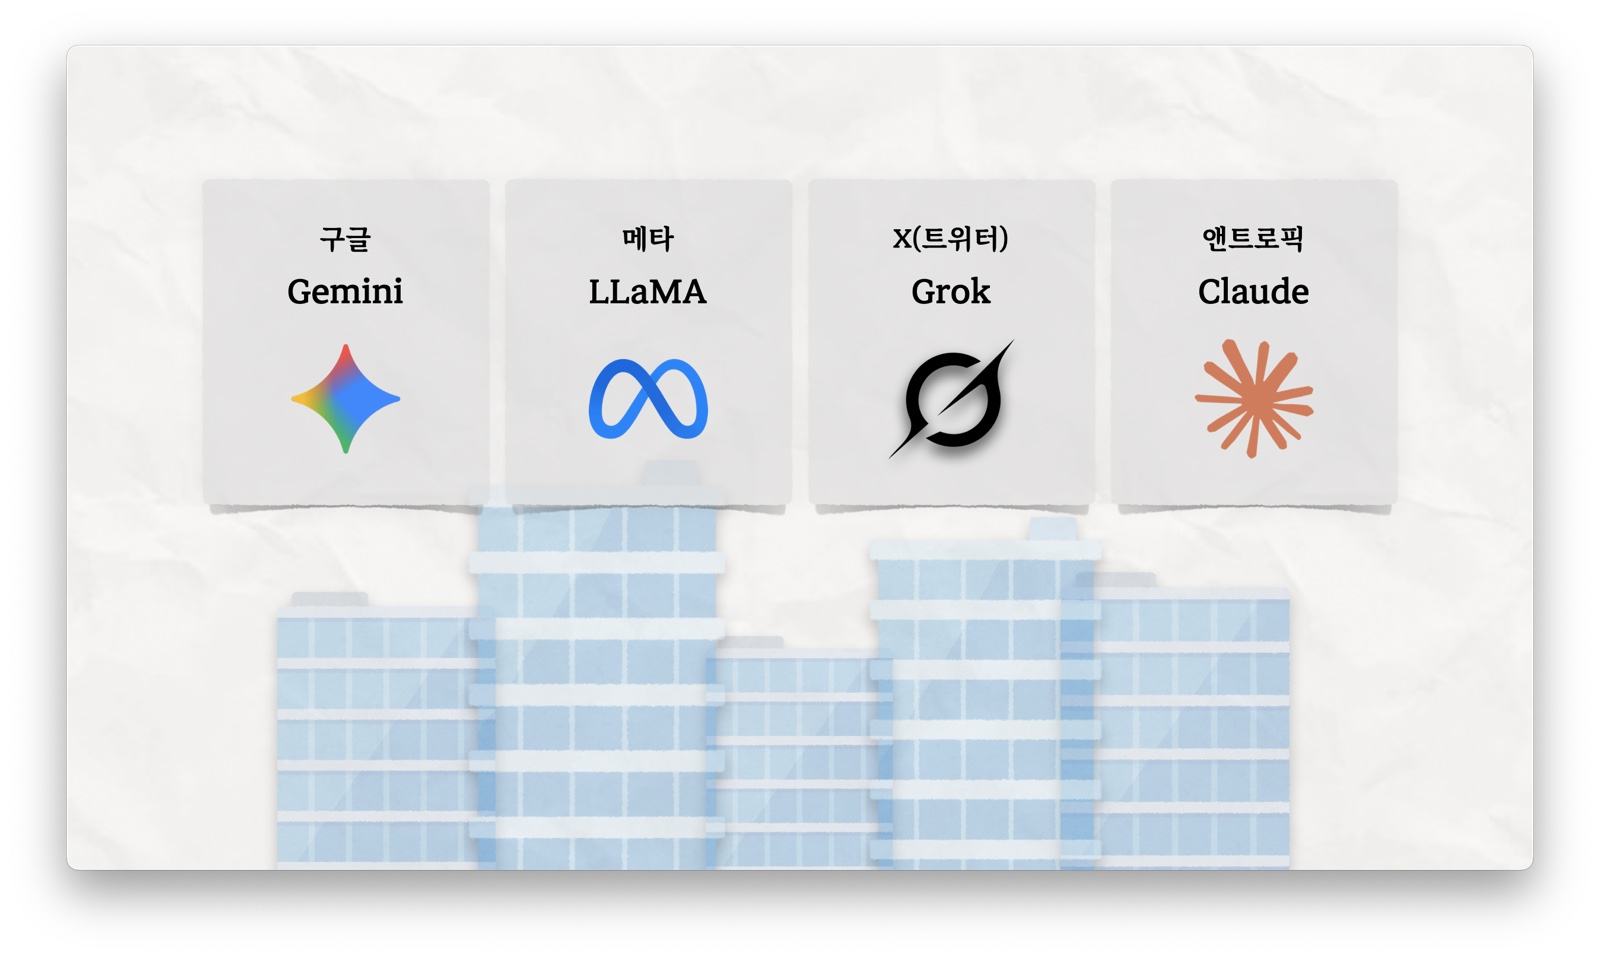
그런데 구독자님은 AI를 몇 개나 쓰고 계신가요? AI도 이제는 대부분 유료라서, 보통 하나, 많아야 두 개 정도를 쓰실 겁니다. 그러다 보니 기업 간 경쟁이 아주 치열해졌습니다. 경쟁사보다 더 빠르고 똑똑해야 소비자가 골라 주니까요. 기업들은 더 강력한 AI 모델을 계속 만들어 냈고, 그 과정에서 AI를 돌리기 위한 컴퓨팅 파워가 엄청나게 필요해졌습니다.
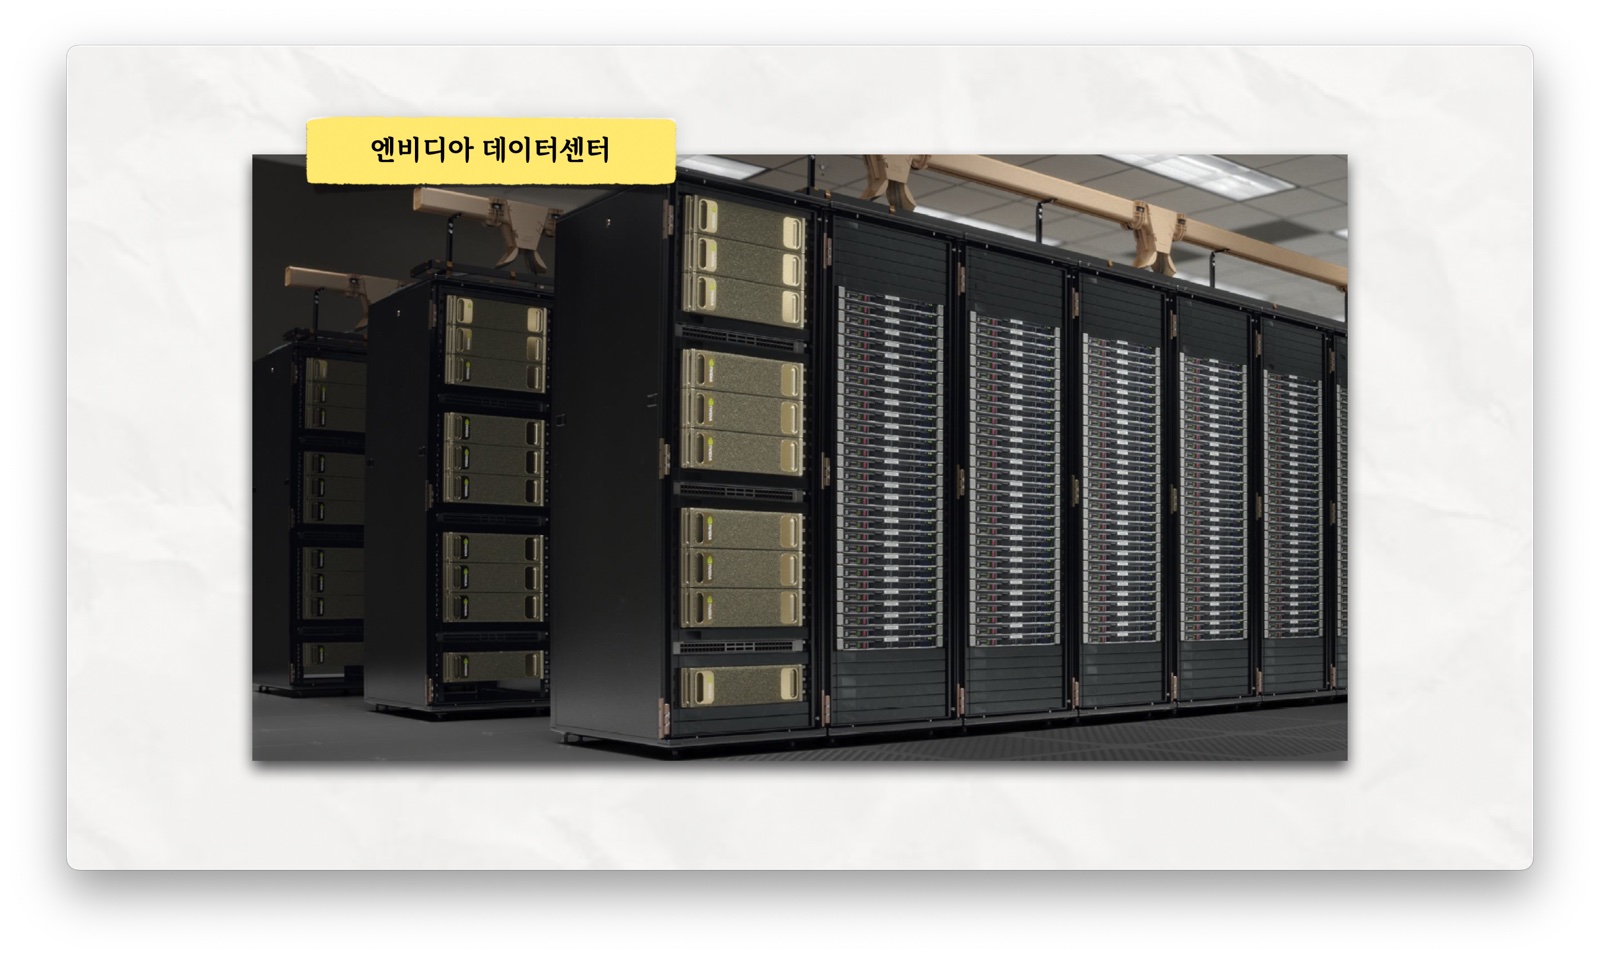
컴퓨팅 파워는 원래 컴퓨터의 연산 능력을 뜻하는 말인데, 쉽게는 AI를 돌리는 데 필요한 모든 컴퓨터 자원이라고 보시면 됩니다. AI도 결국 프로그램이라 그것을 돌릴 컴퓨터가 필요하거든요. 그래서 고성능 컴퓨터를 얼마나 많이 확보했는지, 그 컴퓨터들을 대량으로 문제없이 돌릴 시설을 잘 갖췄는지가 굉장히 중요해졌습니다. 자연스럽게 메모리와 그래픽 카드를 만드는 반도체 수요도 크게 늘었고, 삼성전자와 SK하이닉스 같은 국내 반도체 기업들이 큰 수혜를 받기도 했습니다.
채팅창에 갇혀 있던 AI가 밖으로 나왔습니다
기업 간 경쟁은 컴퓨팅 파워를 확보하는 데서 그치지 않고, AI가 할 수 있는 일의 범위를 넓히는 쪽으로도 이어졌습니다. 이 시점까지 AI는 ChatGPT 같은 챗봇 형태로만 쓰였기 때문에, 질문에 대답만 할 수 있을 뿐 내 컴퓨터의 파일을 읽거나 코드를 실행하는 일은 전혀 할 수 없었습니다. 채팅창 안에 갇혀 있었으니까요.
비유하자면, 무엇이든 해낼 수 있는 엄청나게 똑똑한 사람이 감옥에 갇혀 있어서 우리를 위해 직접 일은 못 하고 조언만 해 주는 상황이었던 겁니다. 그래서 AI를 채팅창 밖으로 꺼내려는 시도가 이어졌고, 그 결과 스스로 작업을 진행할 수 있는 AI 에이전트가 등장했습니다.
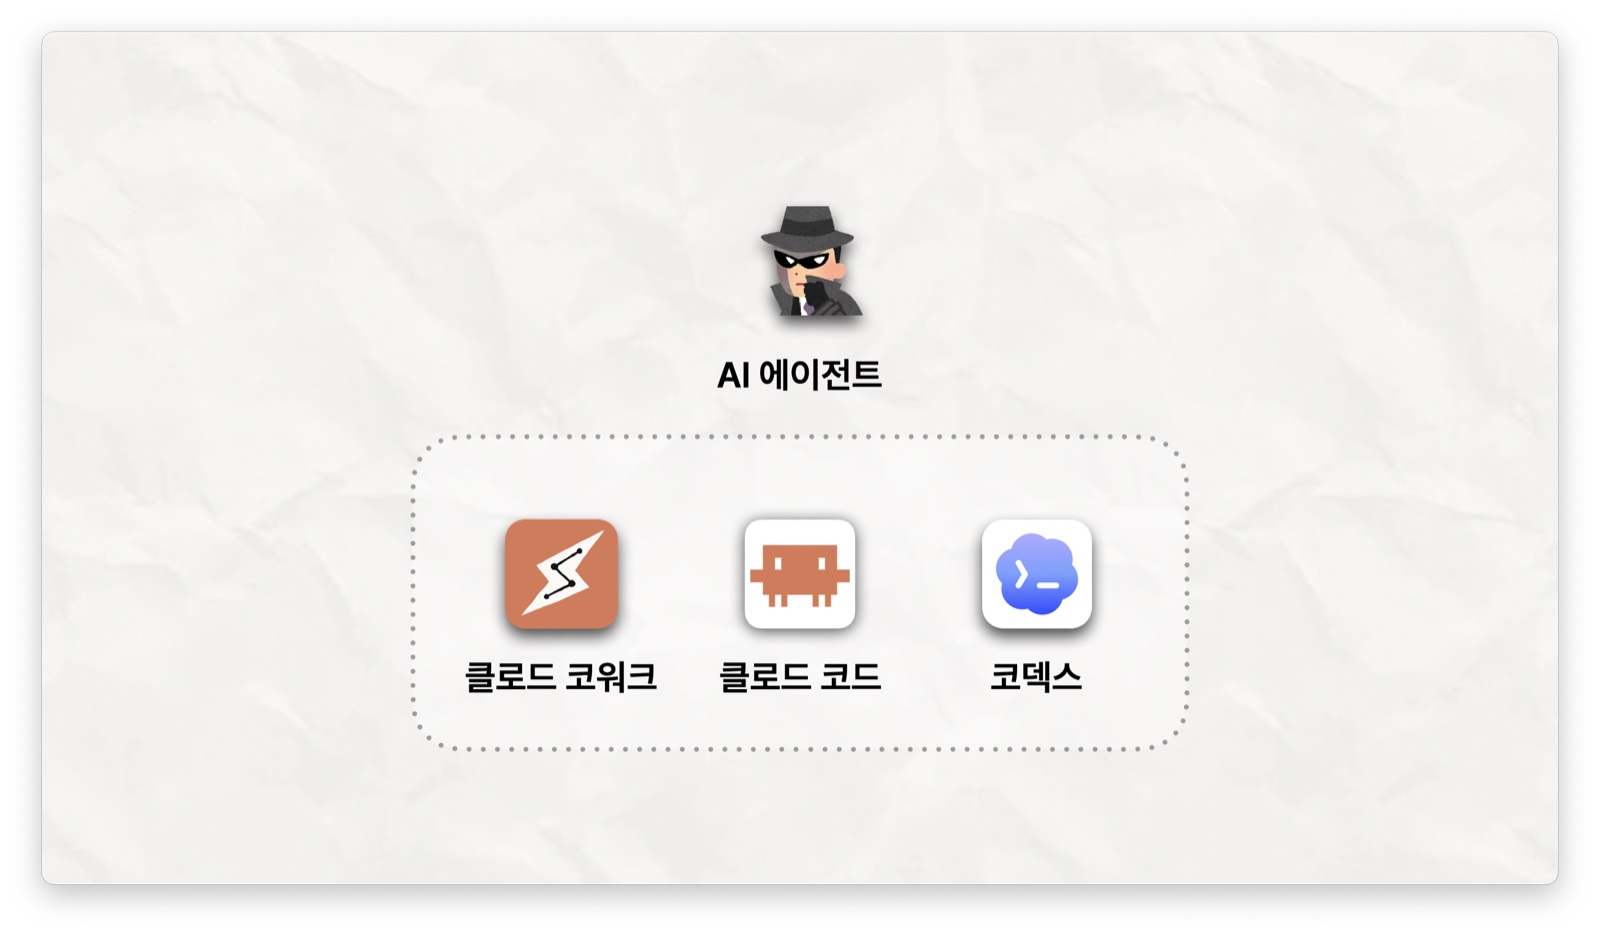
에이전트는 우리말로 요원이라는 뜻입니다. 요원처럼 작업을 지시하면 스스로 계획을 세워 직접 실행하는 프로그램을 말하죠. 클로드 코워크, 클로드 코드, 코덱스 같은 도구가 여기에 해당합니다. AI 에이전트를 쓰면 폴더 정리나 PPT 생성·검토 같은 서류 작업은 물론, 코딩까지 맡길 수 있습니다. AI가 코드 파일을 작성하고 실행한 뒤 테스트까지 돌려 보는데, 이렇게 AI에게 코딩을 맡기는 방식을 바이브코딩이라고 부릅니다. 저도 바이브코딩으로 책을 쓸 때 AI와 함께 원고를 검토하고 고치는 집필 도구를 만들어 정말 잘 쓰고 있습니다.
AI는 가끔, 아주 뻔뻔하게 거짓말을 합니다
여기까지 보면 AI가 사람의 일을 다 해 주니 이제 사람은 필요 없지 않을까 싶으실 수도 있습니다. 하지만 AI에게는 아직 분명한 한계가 남아 있습니다. 대표적인 것이, 가끔 거짓말을 한다는 점입니다. 그것도 아주 뻔뻔하게요.
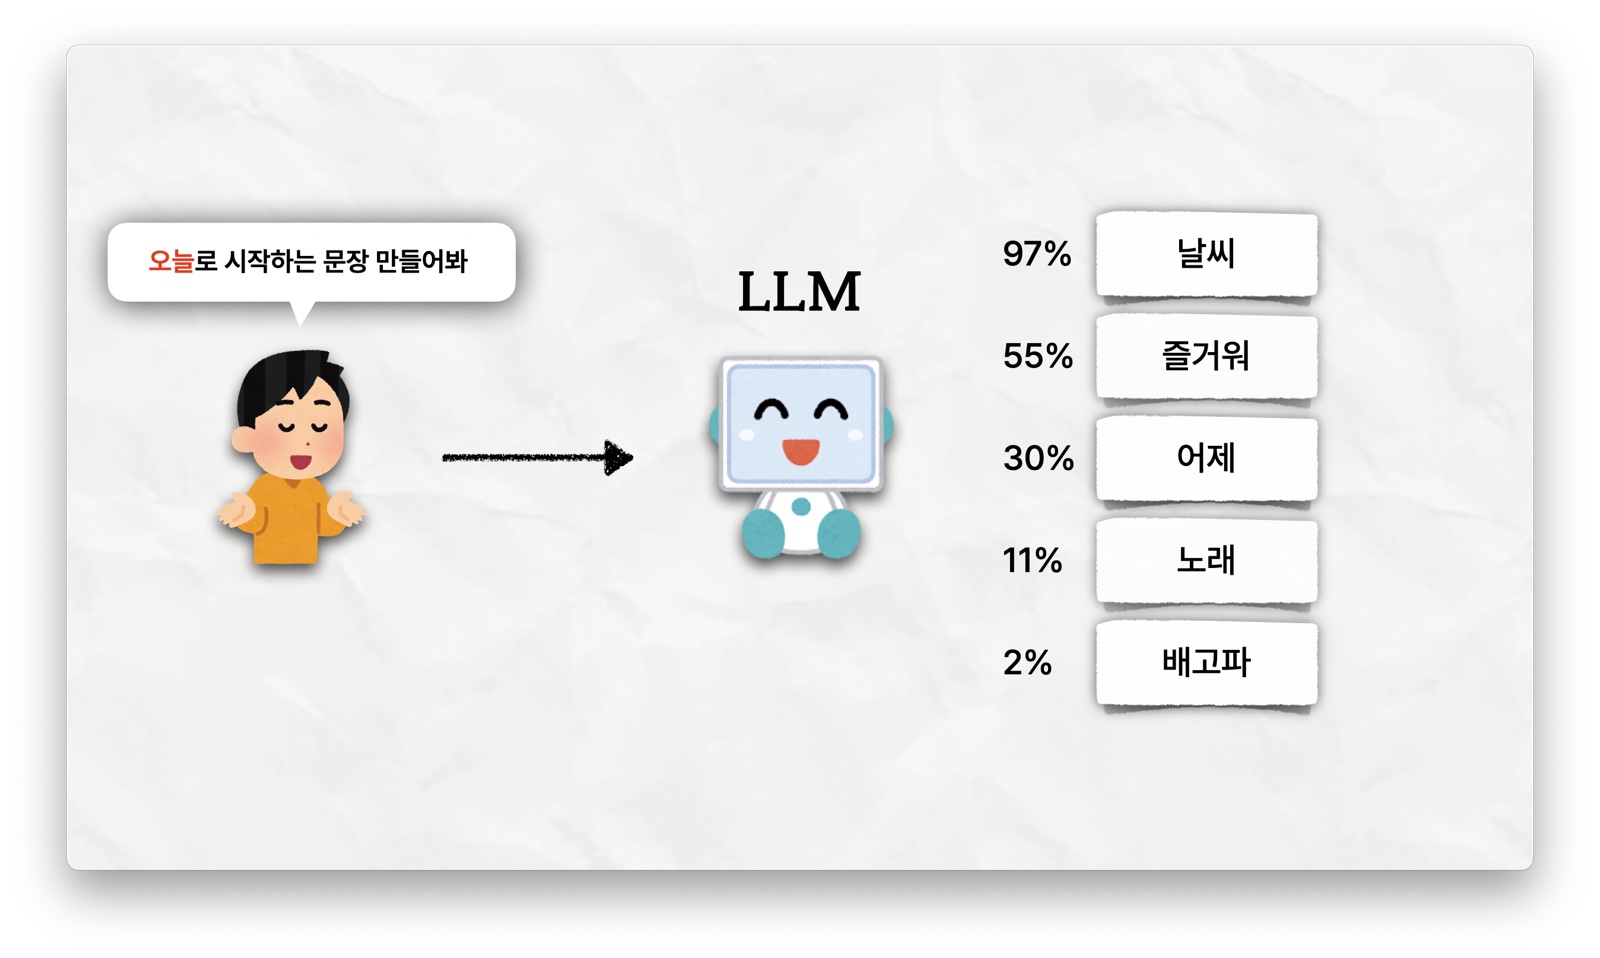
이유는 LLM의 동작 방식에 있습니다. LLM은 확률을 기반으로 움직입니다. 예를 들어 "오늘"로 시작하는 문장을 만들어 보라고 하면, LLM은 "오늘" 뒤에 올 수 있는 여러 단어 중 가장 확률이 높은 단어를 고릅니다. "날씨"가 골라졌다면 두 단어를 이어 붙이고, 다시 그 뒤에 올 단어 중 가장 확률이 높은 "뜨거워"를 골라 문장을 완성하는 식이죠. 이렇게 확률로 답을 만들다 보니, 틀린 답이라도 확률이 높으면 그대로 골라서 내놓게 됩니다.
AI가 마치 환각을 보고 대답하는 것 같다고 해서, 이 현상을 환각이라는 뜻의 영어 단어를 빌려 할루시네이션이라고 부릅니다. 확률로 답을 만드는 LLM의 특성상 완벽히 피하기는 상당히 어렵습니다. 그래서 이 문제가 해결되기 전까지는 AI의 답을 100% 믿을 수 없다는 의견이 주류이고, AI로 작업하더라도 사람의 검토가 꼭 필요합니다.
할루시네이션을 줄이는 방법, RAG
할루시네이션을 줄이기 위한 시도도 여럿 있었는데, 그중 가장 주목받는 방식이 RAG입니다. RAG는 사내 문서나 외부 데이터처럼 AI가 참고할 자료를 데이터베이스에 저장해 두고, AI가 답을 만들 때 그 데이터베이스를 참고하게 하는 기술입니다.
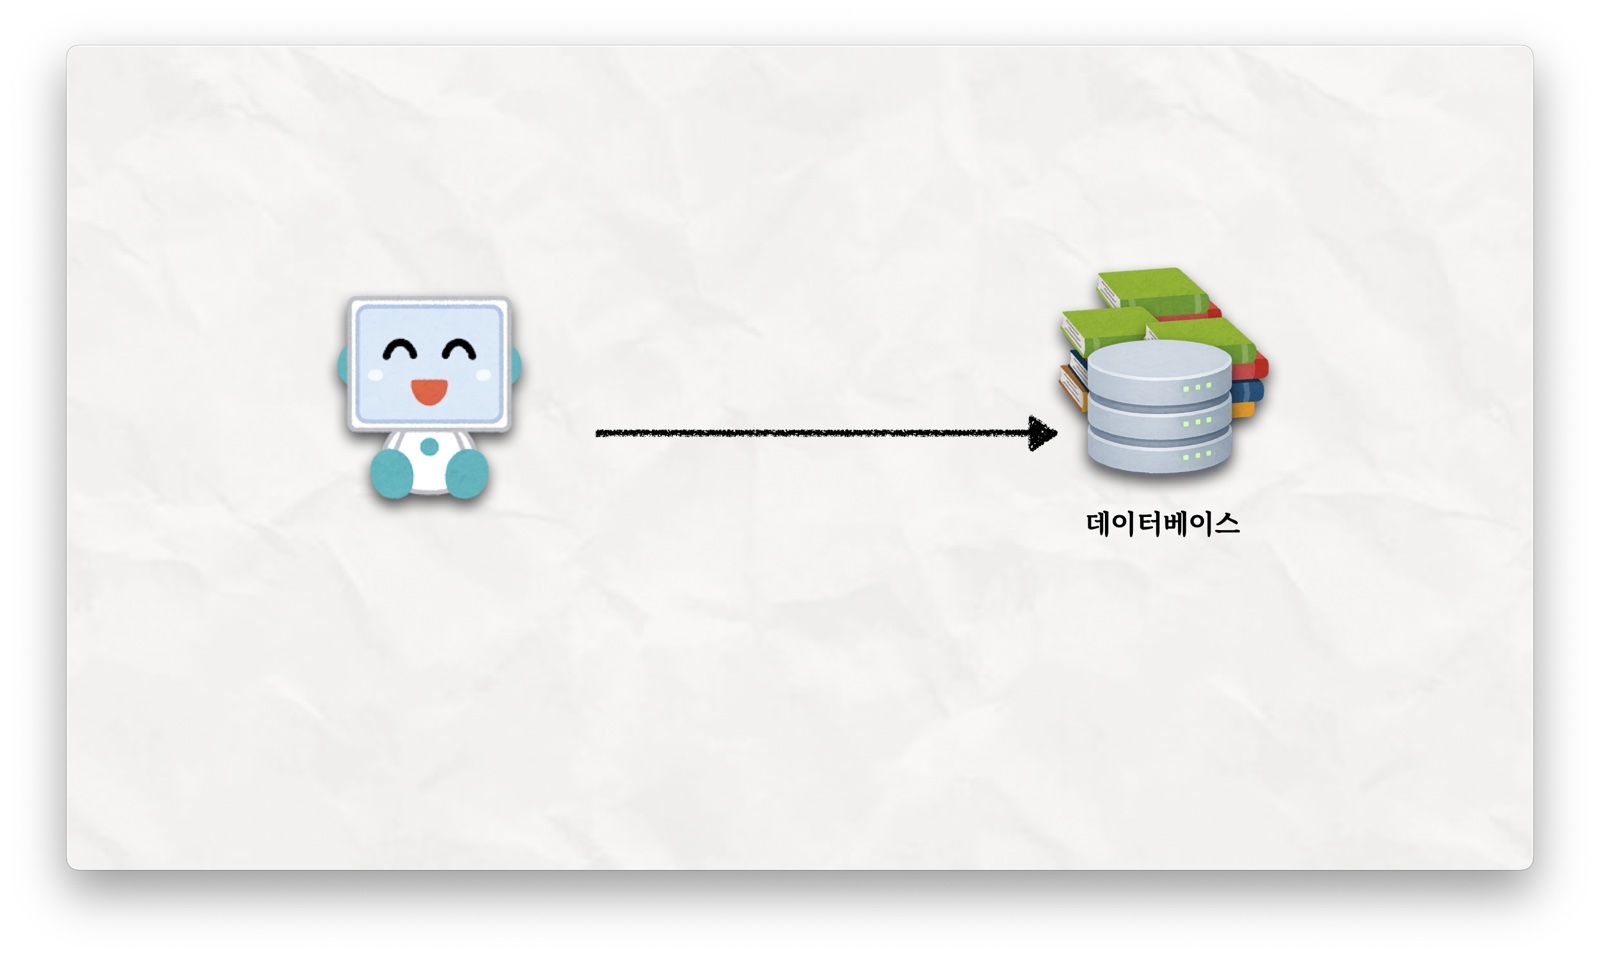
있는 자료를 근거로 답하니, 대놓고 거짓말을 하거나 틀린 정보를 내놓을 확률이 크게 줄어듭니다. 그래서 RAG는 정확성이 특히 중요한 금융기관이나 공공기관에서 활발하게 도입되고 있습니다.
마무리
정리해 보겠습니다. 바둑만 두던 알파고 이후, 사람의 언어를 학습한 LLM이 ChatGPT로 대중 앞에 나타났습니다. 기업들이 저마다 LLM 경쟁에 뛰어들면서 컴퓨팅 파워와 반도체가 중요해졌고, 채팅창에 갇혀 있던 AI는 스스로 일하는 AI 에이전트로 진화했습니다. 다만 확률로 답을 만드는 LLM은 여전히 할루시네이션이라는 한계를 안고 있고, 이를 줄이기 위해 RAG 같은 기술이 쓰이고 있습니다. 오늘 정리한 흐름을 떠올리며 AI 뉴스를 한 번 다시 읽어 보세요. 단어 하나하나가 훨씬 또렷하게 들어오실 겁니다.
영상으로 더 자세히 보기
🎥 RAG·LLM·할루시네이션, AI 뉴스 단어 한 번에 정리
의견을 남겨주세요