안녕하세요. 넥서스알파랩 리포트입니다.
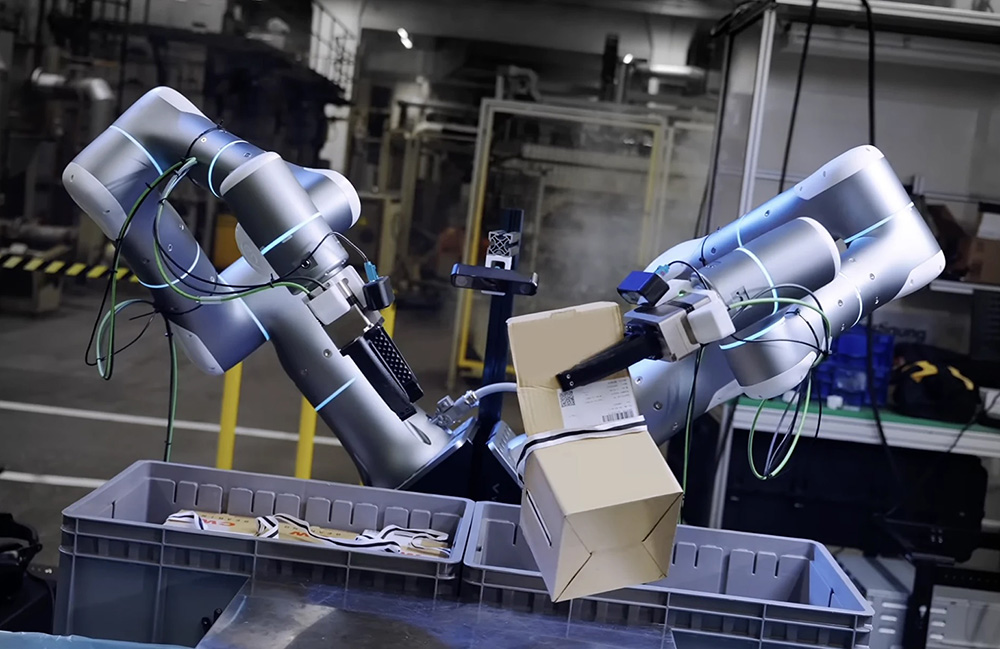
미국 팰로앨토의 로봇 AI 회사 로다 AI가 11월 3일 "모바일 DVA" 연구를 공개했습니다. 양팔 로봇이 유리병을 상자에 정렬하고, 상자를 들고 이동하고, 처음 보는 통로에서 장애물을 피해 쟁반을 나르는 영상과 함께 성공률 숫자를 냈습니다. 이 로봇이 이동하는 법을 배운 로봇 데이터는 30분이었습니다.
이 30분 앞에는 다른 교재가 있습니다. 인터넷 영상 수억 개입니다. 지난 10월 말 채널은 "사람 영상으로 배우면 로봇의 천장은 사람"이라는 결론을 다룬 적이 있습니다. 로다는 반대쪽에서 답합니다. 사람 손 영상만 골라 먹인 모델보다, 파도와 나무까지 다 본 모델이 더 잘했다는 것입니다. 오늘은 이 주장이 무엇을 근거로 하는지, 그리고 어디까지가 확인된 사실인지를 따라갑니다.
오늘의 목차
1️⃣ 로다 AI는 누구인가
2️⃣ 기존 방식의 벽: 원격조종 데이터
3️⃣ DVA는 어떻게 움직이나
4️⃣ 11월 연구: 숫자와 실패
5️⃣ 몸은 나중에, 두뇌는 항상: 사업 구조
1️⃣ 로다 AI는 누구인가
📊 [Fact & Logic]
▸ 2026년 3월 10일, 18개월의 비공개 개발 끝에 공개. 시리즈 A 4억 5,000만 달러(약 5,967억 원), 기업가치 17억 달러(약 2조 2,542억 원). 프렘지 인베스트 주도, 코슬라·테마섹·메이필드·라이트모티프(전 폭스바겐 임원) 등 참여, 존 도어 개인 참여. ▸ CEO 재그딥 싱: 전고체 배터리 회사 퀀텀스케이프 창업자. ▸ 최고과학책임자 에릭 라이언 챈: 스탠퍼드 컴퓨터 비전·생성 모델 연구, AI 회사 월드랩스 출신. 고든 웨츠스타인 스탠퍼드 교수, 공동창업자 앤드루 우튼 참여. ▸ 대상 산업: 자동차, 제조, 물류, 전자상거래. 고객사 이름은 공개하지 않았습니다. ▸ 자체 로봇: 다리 대신 바퀴, 7축 팔과 손. 정격 25kg·최대 40kg, 모든 관절 브레이크, 정격 하중에서 3년 연속 가동 목표. CEO는 "휴머노이드가 아니라 이동형 매니퓰레이터"라고 부릅니다. ▸ 학습 연산은 네비우스 클라우드를 씁니다.
💡 [Insight]
배터리 회사를 세웠던 사람이 로봇 두뇌 회사를 차렸고, 몸은 다리 대신 바퀴를 택했습니다. CEO는 바퀴를 고른 이유로 "비상정지 때 쓰러지지 않는다", "고객이 이미 바퀴 로봇에 익숙하다"를 들었습니다. 화려한 보행보다 공장 안전 기준과 현장 습관에 맞춘 선택입니다. (넥서스알파랩이 본 시각)
2️⃣ 기존 방식의 벽: 원격조종 데이터
📊 [Fact & Logic]
▸ 지금 로봇 AI의 주류는 VLA(시각-언어-행동) 모델입니다. 카메라 화면과 지시문을 보고 곧바로 동작을 냅니다. ▸ VLA를 가르치는 데이터는 주로 사람이 로봇을 원격으로 조종하며 모읍니다. ▸ CEO 싱: "그 방식으로 셔츠 개기, 커피 내리기 같은 흥미로운 연구실 시연은 나왔지만, 어느 것도 현실로 넘어갈 만큼 튼튼하지 않았다. 현실 문제를 푸는 자율 조작 로봇은 오늘 사실상 0대다." ▸ 공동창업자 우튼: VLA는 꽤 단순한 작업에도 1만 시간 단위의 데이터가 필요하고, 그래도 일반화가 잘 안 된다. 업계 사례로 7만, 10만, 70만 시간 같은 숫자를 들었습니다. (로다 측 주장) ▸ CEO: "언어 모델은 셰익스피어부터 레딧까지 인터넷의 모든 글로 배웠다. 물리 세계에는 그런 인터넷 규모의 데이터가 없었다."
💡 [Insight]
로봇 데이터를 사람이 한 시간씩 직접 만들어야 한다면, 데이터의 양은 사람의 시간에 묶입니다. 로다가 문제 삼는 것은 모델 구조보다 이 병목입니다. 다만 “1만 시간”은 경쟁 방식을 설명하는 쪽의 숫자이므로, 경쟁사가 직접 밝힌 수치와는 구분해서 봐야 합니다. (출처를 바탕으로 한 추론)
3️⃣ DVA는 어떻게 움직이나
📊 [Fact & Logic]
▸ 이름: DVA(Direct Video-Action), 직접 영상-행동 모델. ▸ 사전학습: 인터넷 영상 수억 개. CEO는 "수백 년 분량", 회사 사이트는 “1년 이상 분량”이라고 적어 표현이 다릅니다. ▸ 무엇을 봤나: 야구, 다트, 부서지는 파도, 바람에 흔들리는 나무. CEO: "사람이 나오지 않는 영상도 세상이 어떻게 움직이는지 가르쳐 준다. 인터넷 전체가 물리 교실이 된다." ▸ 핵심 발견: 사람 손 조작이 담긴 1인칭 영상만 골라 학습한 모델보다, 조작과 무관해 보이는 영상까지 포함한 가장 넓은 데이터로 학습한 모델이 가장 잘했다. (CEO 인터뷰, 비교 수치 미공개) ▸ 작동 순서: 과거 영상 장면, 행동 기록, 언어 지시를 함께 봅니다 → 영상 모델이 다음 약 0.5초 장면을 영상으로 예측 → 행동 변환기(역동역학 모델)가 그 장면을 팔과 바퀴 동작으로 바꿈 → 반 초 실행 → 다시 관찰하고 예측. ▸ 이동까지 한 모델로: 11월 "모바일 DVA"는 지도, 위치 추정(SLAM), 별도 길찾기 프로그램 없이 팔과 바퀴를 하나의 정책으로 조종합니다. ▸ 연산 위치: 세밀한 제어는 로봇 안에서, 영상 예측은 클라우드나 로봇 안 어느 쪽에서도 가능. (공동창업자 인터뷰) ▸ 사후학습: 작업별 로봇 데이터를 짧게 더합니다. CEO 비유: "이미 기술을 가진 신입 사원에게 우리 회사 작업 흐름만 가르치는 것과 같다."
💡 [Insight]
VLA는 "보고 바로 움직이는" 구조이고, DVA는 "보고, 다음 장면을 그려 보고, 그 장면을 따라 움직이는" 구조입니다. 중간에 영상 한 단계를 끼운 덕분에, 영상 모델 부분은 로봇 없이 인터넷 영상만으로 키울 수 있습니다. 로봇 데이터가 필요한 곳은 "그림을 동작으로 바꾸는" 마지막 단계로 좁아집니다. 이것이 로다가 30분, 15분을 말할 수 있는 이유로 읽힙니다. (출처를 바탕으로 한 추론)
4️⃣ 11월 연구: 숫자와 실패
📊 [Fact & Logic]
▸ 병 분류·상자 운반: 유리병을 상자에 담아 옮기고 빈 상자를 가져오는 작업. 성공률 95.1%(평가 5회). 이 작업의 이동 동작 데이터는 30분. ▸ 제자리 조작을 먼저 배운 효과: 같은 작업에서 제자리 조작 학습 없이 웹 영상에서 바로 시작한 모델은 88.5%. 차이 6.6%p. ▸ 쟁반 옮기기, 새 실험실: 이동 데이터 15분 88.3%, 60분 91.7%. ▸ 쟁반 옮기기, 공장 환경: 15분 76.7%, 60분 88.3%. 데이터가 늘수록 두 환경 차이가 11.7%p에서 3.3%p로 좁아졌습니다. (조건당 60회 평가) ▸ 주된 실패: 똑같이 생긴 두 테이블 중 원래 테이블에 쟁반을 되돌려 놓음. 회사가 스스로 밝혔습니다. ▸ 돌발 상황: 운반 중 장애물을 밀어 넣거나 목적지 테이블을 옮겨도 경로와 위치를 바꿔 대응. 이 테스트의 성공률은 공개하지 않았습니다. ▸ 그 밖의 공개 작업: 반품 처리, 10kg 베어링 상자 해체, 50파운드(약 23kg) 대형 상자 접기, 사람 시범을 한 번 보고 따라 하기. ▸ 공장 성과: 한 대형 자동차 공장에서 부품 처리 작업을 사람 개입 없이 1회 2분 이내에 끝내 고객 목표치를 넘었다고 발표. 공장 이름은 비공개.
💡 [Insight]
로봇 업계 시연 영상은 보통 성공한 장면만 보여 줍니다. 로다는 76.7%라는 낮은 숫자와 "테이블을 헷갈린다"는 실패 원인까지 함께 냈습니다. CEO가 경쟁사 대부분을 "작은 짐만 드는 장난감"이라 부르고 "데모만 있는 회사가 되기 싫다"고 한 것과 맞닿은 공개 방식입니다. 다만 모두 회사가 직접 잰 숫자이고, 평가 횟수가 적은 항목도 있습니다. (넥서스알파랩이 본 시각)
5️⃣ 몸은 나중에, 두뇌는 항상: 사업 구조
📊 [Fact & Logic]
▸ CEO: “AI 층은 항상 우리가 가진다. 몸은 우리 것이든 다른 회사 것이든 쓸 수 있다. 작업 기술은 우리가 가르칠 수도, 고객이나 제3자가 가르칠 수도 있다.” ▸ 어떤 로봇 몸인지는 사후학습 단계에서만 반영됩니다. 그래서 다른 로봇으로 옮기기 쉽다는 설명입니다. ▸ 현재 시범 운영은 협력사의 기성 산업 로봇에 로다 모델을 얹는 방식이고, 자체 로봇도 고객과 시험 중입니다. (공동창업자·CEO 인터뷰) ▸ 두뇌 "퓨처비전"을 여러 로봇 회사에 라이선스로 공급할 계획입니다. ▸ 집중 분야는 제조·물류. CEO: "많은 제조·물류 회사가 일손이 부족하다. 수십 년 해외로 나간 산업을 되돌릴 길이 될 수 있다." ▸ CEO 전망: 로봇의 "챗GPT 순간"이 예상보다 빨리 온다.
💡 [Insight]
로다는 몸을 팔 수도 있고 안 팔 수도 있지만, 두뇌는 반드시 쥡니다. 몸이 마지막 학습에서야 붙는 구조라서 가능한 선택입니다. 영상으로 키운 두뇌 하나를 여러 회사 로봇에 얹을 수 있다면, 로봇 하드웨어 회사가 늘어날수록 두뇌 공급자의 고객도 늘어납니다. 반대로 그 두뇌가 현장에서 기대만큼 버티지 못하면, 몸까지 함께 만드는 경쟁사에 밀릴 수 있습니다. (출처를 바탕으로 한 추론)
⚖️ 다른 시각
▸ 사람 영상이 더 효율적이라는 시각: 제너럴리스트, 샤오미 등은 사람 손 동작을 담은 데이터에 집중합니다. 로봇이 결국 하는 일은 사람 손의 일이므로, 관련 있는 데이터가 적은 양으로 더 빨리 가르친다는 논리입니다. 로다의 "넓은 데이터가 이겼다"는 비교 수치가 공개되지 않아 아직 판정할 수 없습니다. ▸ 영상 예측이 느리다는 시각: 매번 다음 장면을 영상으로 그리는 데는 연산이 듭니다. 로다는 영상 모델이 실시간의 2배 속도로 돈다고 말하지만, 고속 작업에서 이 구조가 얼마나 버틸지는 공개된 수치가 없습니다. ▸ 실험실과 공장의 거리: 같은 15분 학습이 실험실 88.3%, 공장 환경 76.7%였습니다. 실제 공장은 조명, 소음, 사람 동선이 훨씬 복잡합니다. 회사 밖 독립 평가가 나오기 전까지 숫자는 회사 발표로 남습니다.
🎯 결론
로다 AI는 로봇 데이터를 사람이 직접 만드는 병목을 인터넷 영상으로 돌아가려는 회사입니다. 영상으로 다음 장면을 먼저 그리는 DVA 구조 덕분에, 로봇 데이터가 필요한 부분을 마지막 변환 단계로 좁혔고, 이동 동작을 30분 만에 배웠습니다. 동시에 공장 환경 76.7%, 테이블 혼동 같은 한계도 스스로 공개했습니다. 다음에 확인할 것은 하나, 이 숫자가 회사 밖 공장에서 독립적으로 재현되는가입니다.
🍙 한입쌈밥
한 줄 요약 로다 AI는 파도와 나무까지 담긴 인터넷 영상으로 세상의 움직임을 먼저 배우고, 로봇 데이터 30분으로 이동을 익혔다.
숫자 셋 ▸ 30분: 병 운반 작업의 이동 동작 학습 데이터 ▸ 95.1%: 병 분류·상자 운반 성공률 (회사 자체 평가) ▸ 76.7%: 공장 환경에서 15분 학습한 쟁반 운반 성공률
밈으로 보면 신입 사원: "회사 일은 처음인데요" → 로다 로봇: "세상 돌아가는 건 유튜브로 다 봤습니다"
지켜볼 지표 하나 회사 밖 공장에서 나온 독립 평가 성공률
아직 모르는 것 넓은 데이터 모델과 사람 영상 모델의 비교 수치, 고객사 이름, 실제 공장 가동 대수, 퓨처비전 라이선스 가격
다음에 볼 것 자체 바퀴 로봇의 공식 발표, 첫 라이선스 고객 로봇 회사의 이름
🎬 영상으로 보기: (유튜브 쇼츠 링크)
📚 지난 편 ▸ 디즈니식 직접 제작 vs 하스브로식 나눠 빌려주기 — 손님을 기억하는 로봇 캐릭터 ▸ 최고 속도 vs 멈춘 시간 — 보스턴 다이내믹스 스트레치 ▸ 에카 로보틱스, 사람 시범 없는 학습 (사람 영상이면 천장은 사람)
본 리포트는 정보 제공 목적이며 투자 추천이 아닙니다.



의견을 남겨주세요